1/50
WWW – architektura serwerów HTTP
Cel slajdu: Slajd omawia zagadnienie „WWW – architektura serwerów HTTP” w kontekście: Protokół HTTP i serwery WWW jako fundament sieci.

Protokół HTTP i serwery WWW jako fundament sieci

Protokół HTTP (Hypertext Transfer Protocol) stanowi bazowy protokół warstwy aplikacji modelu ISO/OSI i TCP/IP dla ogólnoświatowej sieci WWW (World Wide Web). Definiuje on sformalizowane reguły wymiany informacji między klientem (przeglądarką, agentem użytkownika) a serwerem w asymetrycznym modelu żądanie-odpowiedź (request-response).

  • Standardy bazowe IETF: Semantyka protokołu określona jest w standardzie internetowym RFC 9110 (HTTP Semantics) oraz specyfikacji warstwy przesyłowej RFC 9112 (HTTP/1.1).
  • Architektura serwerów WWW: Analiza porównawcza procesowo-wątkowego serwera Apache HTTP Server (moduły MPM: prefork, worker, event) oraz asynchronicznego, sterowanego zdarzeniami serwera Nginx (event-driven, silniki epoll i kqueue).
  • Mechanizmy i bezpieczeństwo: Szczegółowe omówienie metod HTTP, kodów statusu, nagłówków bezpieczeństwa (CSP, HSTS, X-Frame-Options) oraz zarządzania pamięcią podręczną.
  • Laboratorium inżynierskie: Konfiguracja wirtualnych hostów (virtual hosts / server blocks), analiza ruchu narzędziem curl -vL oraz inspekcja nagłówków w panelu sieciowym narzędzi deweloperskich (DevTools).
WWW – architektura serwerów HTTP: Slajd przedstawia zagadnienie Protokół HTTP i serwery WWW jako fundament sieci w ramach tematu WWW – architektura serwerów HTTP na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
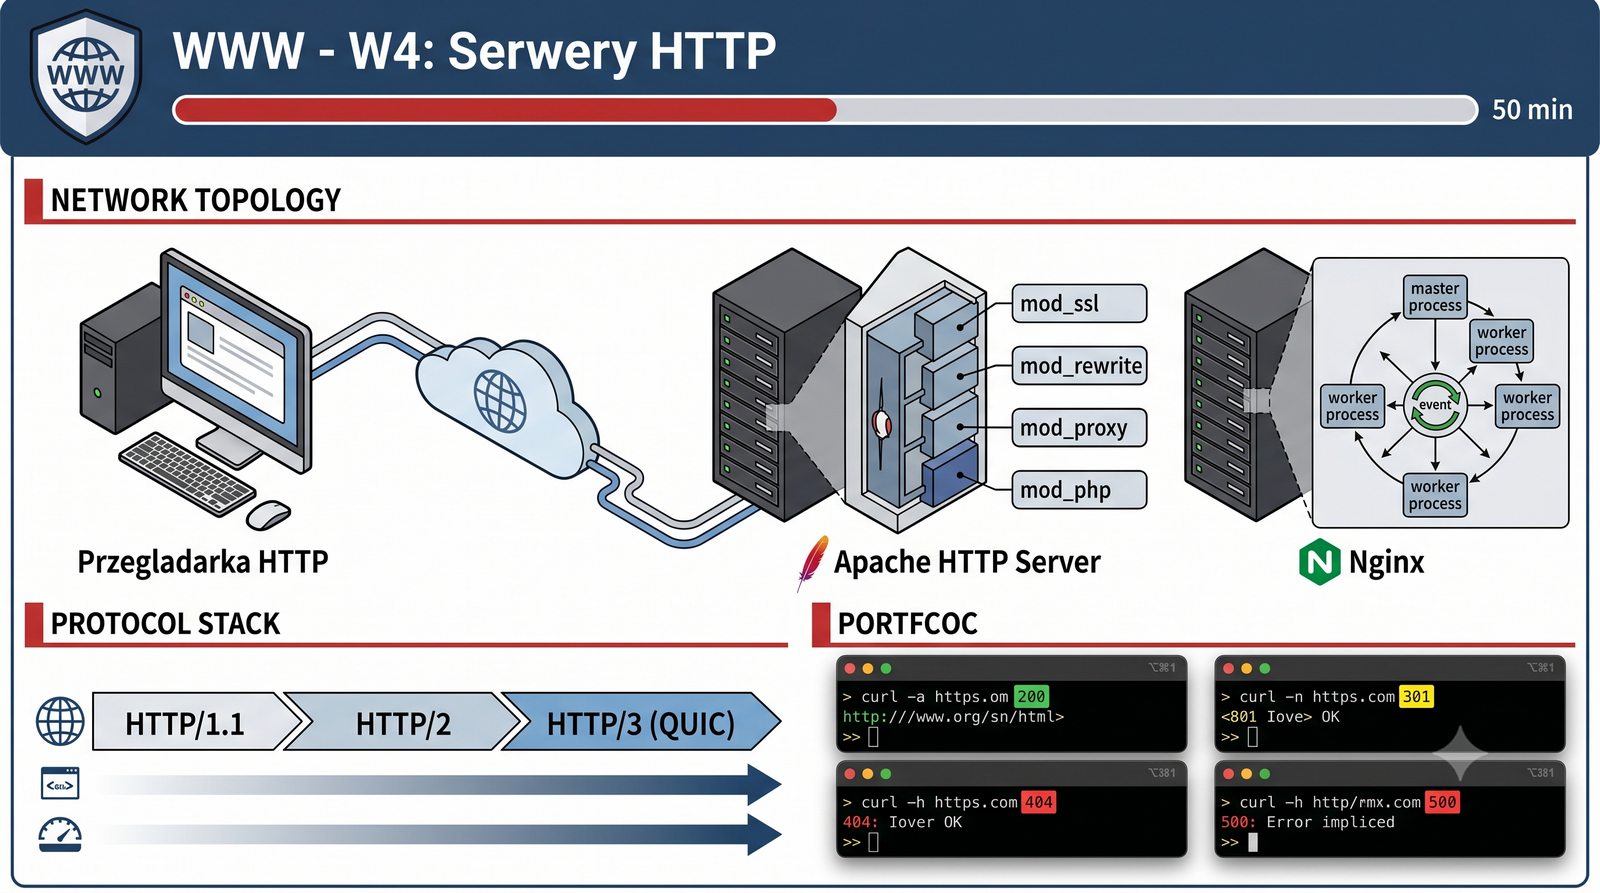
WWW - grafika tytulowa
2/50
Cel warsztatu: pod maską WWW
Cel slajdu: Slajd określa wymagane efekty uczenia się, czyli wiedzę i umiejętności, które uczestnik opanuje po zajęciach i laboratorium.

Praktyczne cele i umiejętności inżynierskie

  • Zrozumienie mechaniki protokołu: Prześledzenie pełnego cyklu przetwarzania żądania HTTP – od rezolucji DNS, przez trójstopniowe uzgadnianie połączenia TCP i negocjację TLS 1.3 (RFC 8446), aż po analizę składniową (parsowanie) nagłówków i generowanie odpowiedzi.
  • Konfiguracja produkcyjna: Samodzielne wdrażanie serwerów Apache 2.4 i Nginx w środowisku Linux, konfiguracja hostów wirtualnych bazujących na nazwach (Name-based Virtual Hosts) i adresach IP (IP-based).
  • Bezpieczeństwo i nagłówki ochronne: Prawidłowa implementacja polityk bezpieczeństwa przy użyciu nagłówków Content-Security-Policy, Strict-Transport-Security (HSTS) oraz X-Frame-Options.
  • Diagnostyka i analiza ruchu: Biegłe posługiwanie się narzędziami konsolowymi (curl -vL, openssl s_client) oraz graficznym panelem sieciowym (DevTools) do weryfikacji kodów odpowiedzi, czasów opóźnień i nagłówków sterujących pamięcią podręczną (Cache-Control, ETag).
Cel warsztatu: pod maską WWW: Slajd przedstawia zagadnienie Praktyczne cele i umiejętności inżynierskie w ramach tematu Cel warsztatu: pod maską WWW na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
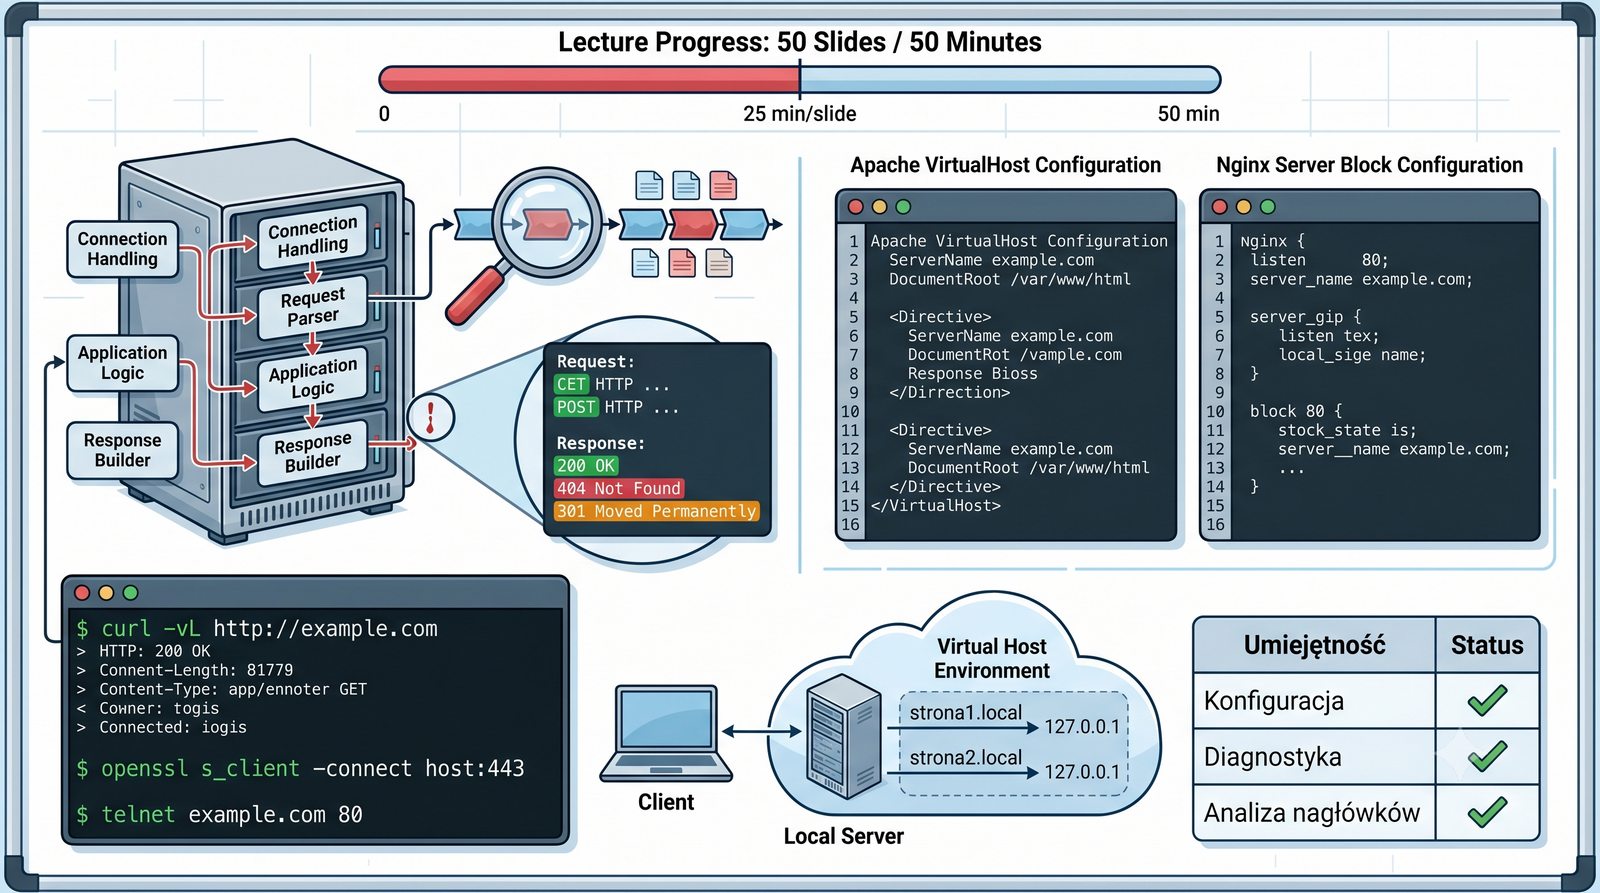
Cel warsztatu
3/50
Agenda warsztatu
Cel slajdu: Slajd przedstawia kolejność omawianych zagadnień i wskazuje miejsce bieżącego tematu w strukturze wykładu.

Struktura i tematyka poszczególnych modułów

  1. Istota protokołu HTTP (slajdy 4–12): Bezstanowość, mechanizmy zarządzania sesją (ciasteczka wg RFC 6265, tokeny JWT wg RFC 7519), ewolucja standardu od HTTP/1.0, przez HTTP/1.1 i HTTP/2, do HTTP/3 (QUIC). Cykl życia żądania i odpowiedzi.
  2. Metody i kody statusu (slajdy 13–20): Klasyfikacja metod (bezpieczne, idempotentne), szczegółowa taksonomia kodów odpowiedzi grup 1xx–5xx, diagnostyka przy użyciu narzędzia curl -vL.
  3. Architektura oprogramowania serwerowego (slajdy 21–30): Wewnętrzna budowa Apache httpd (moduły MPM) oraz serwera Nginx (wieloprocesowa pętla zdarzeń, nieblokujące gniazda I/O, moduł upstream). Porównanie efektywności zasobowej.
  4. Wirtualne hosty (slajdy 31–38): Koncepcja hostingu wirtualnego opartego na nazwie (Name-based) i adresie (IP-based), konfiguracja dyrektyw VirtualHost i bloków server, aliasowanie interfejsów sieciowych w Linuksie, ćwiczenia wdrożeniowe.
  5. Nagłówki HTTP i negocjacja treści (slajdy 39–44): Podział nagłówków, mechanizmy ochrony przed atakami (CSP, HSTS, X-Frame-Options), polityki buforowania (Cache-Control, ETag) i mechanizm Content Negotiation.
  6. Laboratorium diagnostyczne i troubleshooting (slajdy 45–50): Praktyczne scenariusze awaryjne, interpretacja logów serwera w formatach common i combined, wykorzystanie DevTools, openssl oraz Wireshark.
Agenda warsztatu: Slajd przedstawia zagadnienie Struktura i tematyka poszczególnych modułów w ramach tematu Agenda warsztatu na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
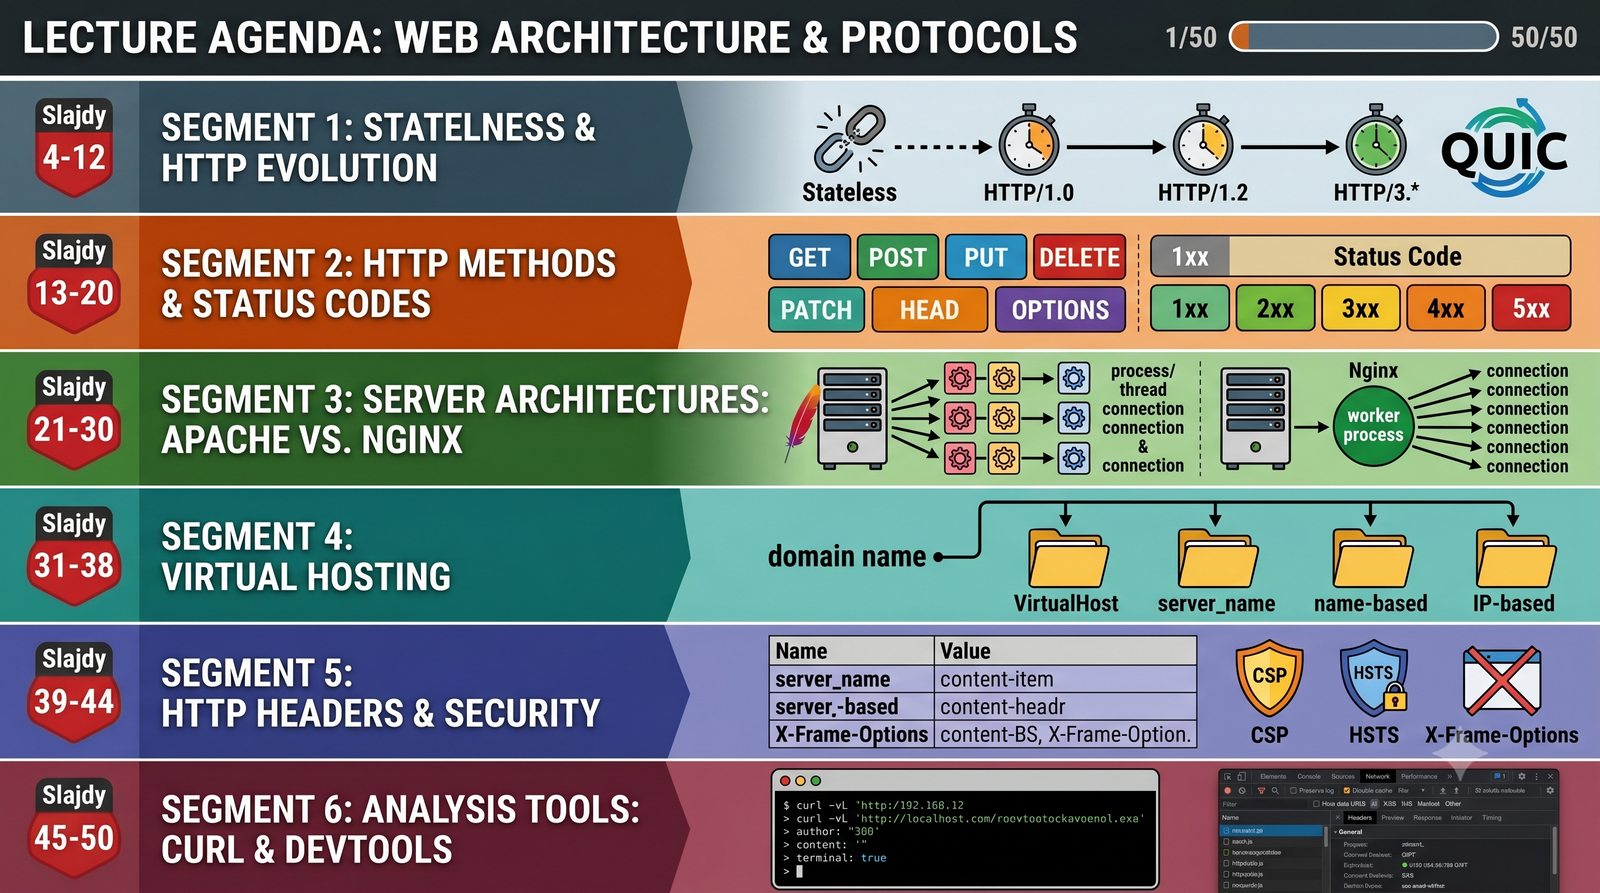
Agenda
4/50
Bezstanowość protokołu HTTP
Cel slajdu: Slajd omawia zagadnienie „Bezstanowość protokołu HTTP” w kontekście: Każde żądanie HTTP jest niezależną transakcją.

Każde żądanie HTTP jest niezależną transakcją

  • Protokół bezstanowy (stateless protocol): Zgodnie ze standardem RFC 9110 serwer WWW przetwarza każde napływające żądanie w sposób całkowicie autonomiczny, nie zachowując w pamięci protokołu żadnych informacji o wcześniejszych interakcjach z danym klientem.
  • Brak natywnego kontekstu: Dwa kolejne żądania wysłane przez tę samą przeglądarkę w odstępie milisekund są dla rdzenia serwera dwoma niezwiązanymi zdarzeniami, chyba że w nagłówkach przekazano zewnętrzne identyfikatory stanu.
  • Zalety architektoniczne bezstanowości:
    • Wysoka skalowalność horyzontalna: Kolejne żądania klienta mogą być kierowane przez moduł równoważenia obciążenia (load balancer) do dowolnego węzła w klastrze bez konieczności kosztownej replikacji pamięci sesji w warstwie HTTP.
    • Odporność na awarie (fault tolerance): Restart lub awaria pojedynczego węzła serwerowego nie narusza stanu protokołu dla kolejnych żądań.
    • Uproszczenie logiki serwera: Brak konieczności zwalniania zasobów protokołowych w przypadku nagłego zerwania łączności przez klienta.
Bezstanowość protokołu HTTP: Slajd przedstawia zagadnienie Każde żądanie HTTP jest niezależną transakcją w ramach tematu Bezstanowość protokołu HTTP na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
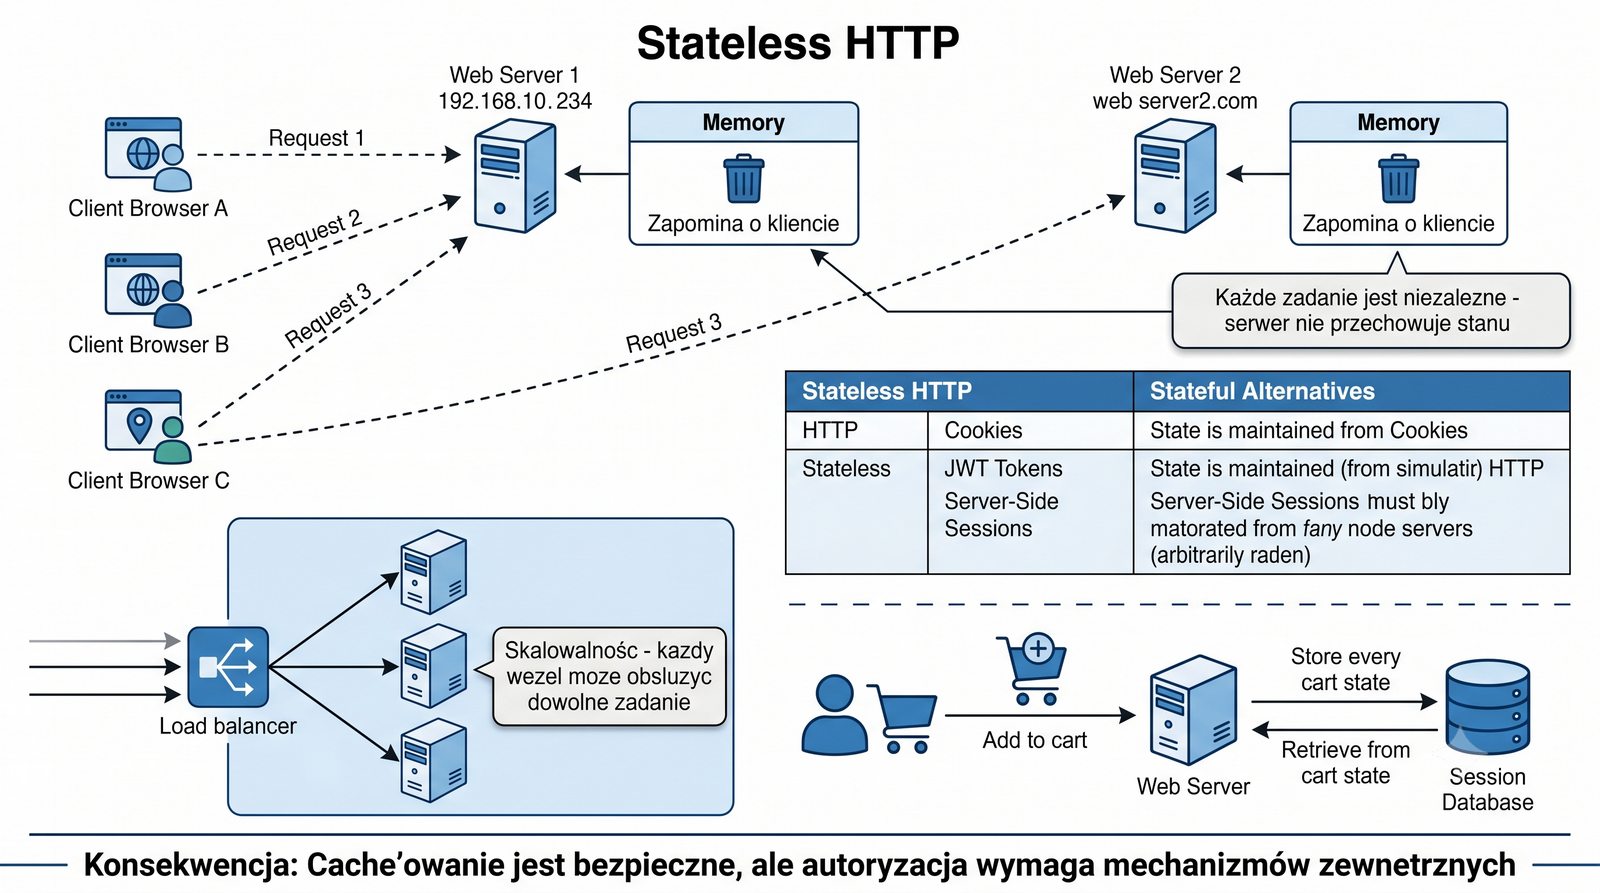
bezstanowość HTTP
5/50
Problemy bezstanowości i mechanizmy sesji
Cel slajdu: Slajd omawia zagadnienie „Problemy bezstanowości i mechanizmy sesji” w kontekście: Sesje, ciasteczka i tokeny jako emulacja stanu.

Sesje, ciasteczka i tokeny jako emulacja stanu

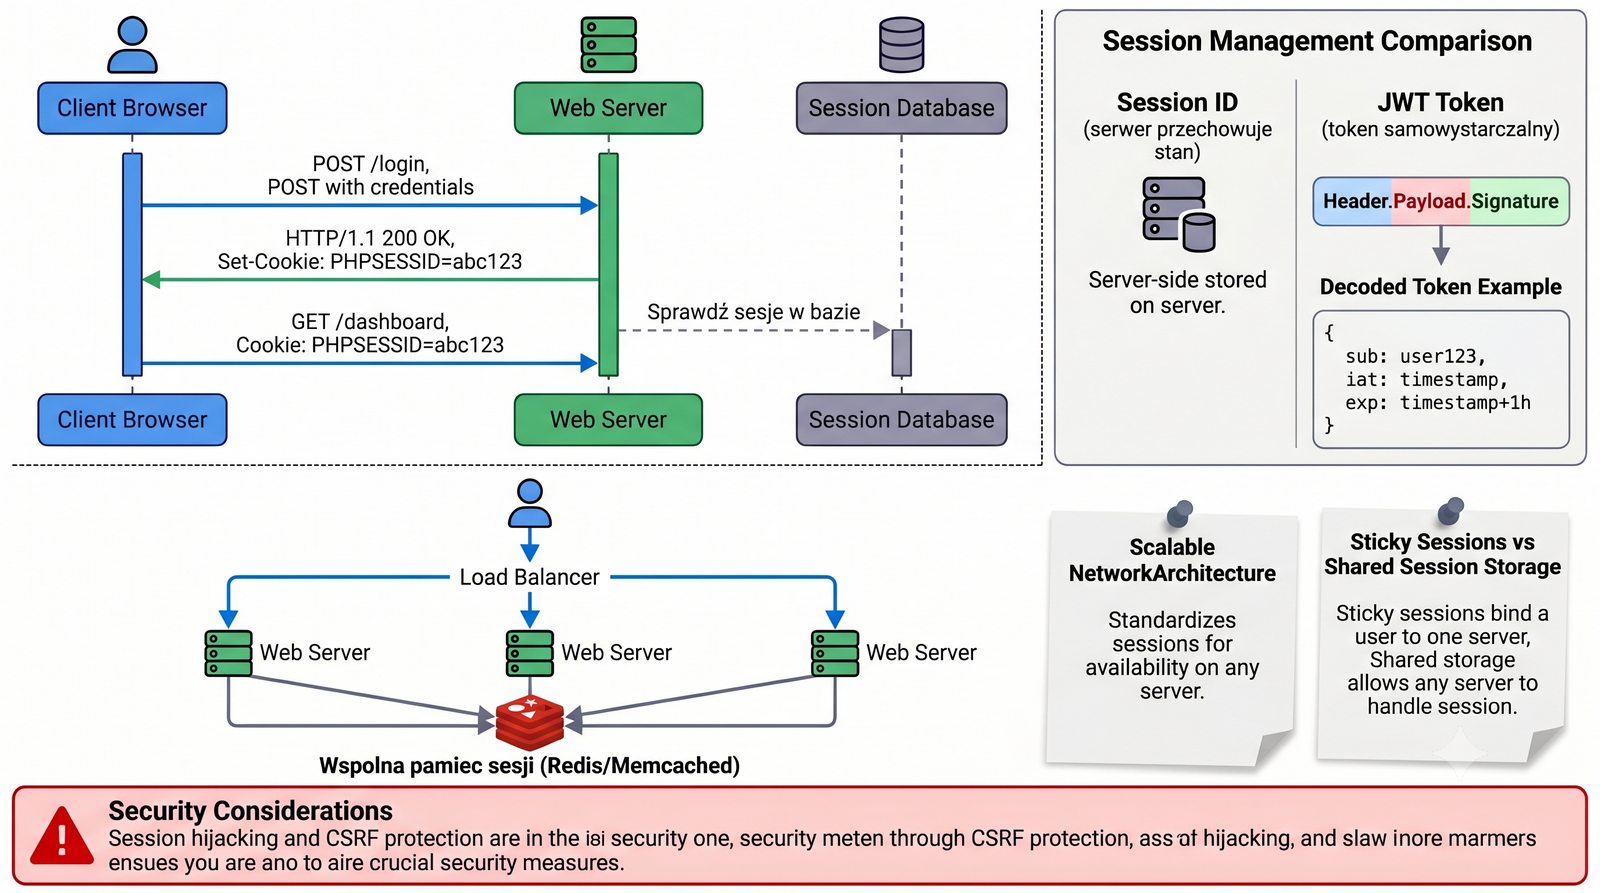
Bezstanowość uniemożliwia natywną obsługę scenariuszy wymagających ciągłości, takich jak uwierzytelnianie użytkownika, koszyk w sklepie internetowym czy wieloetapowe formularze. Rozwiązaniem jest przeniesienie stanu do warstwy aplikacji poprzez mechanizmy zewnętrzne:

  • Ciasteczka HTTP (Cookies – RFC 6265): Serwer generuje unikalny identyfikator i odsyła go w nagłówku Set-Cookie: session_id=abc123xyz; Secure; HttpOnly; SameSite=Strict. Przeglądarka automatycznie dołącza go do każdego kolejnego żądania w nagłówku Cookie.
  • Sesje serwerowe (Server-side Sessions): Stan sesji przechowywany jest w pamięci serwera, bazie danych lub rozproszonej pamięci podręcznej (np. Redis, Memcached), a po stronie klienta znajduje się jedynie klucz sesji.
  • Bezstanowe tokeny kryptograficzne (JWT – RFC 7519): Cały stan (tożsamość, uprawnienia, czas ważności) zapisany jest w podpisanej cyfrowo strukturze JSON, przesyłanej najczęściej w nagłówku Authorization: Bearer <token>.
Problemy bezstanowości i mechanizmy sesji: Slajd przedstawia zagadnienie Sesje, ciasteczka i tokeny jako emulacja stanu w ramach tematu Problemy bezstanowości i mechanizmy sesji na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
Mechanizmy sesji
6/50
Ewolucja HTTP: od HTTP/1.0 do HTTP/1.1
Cel slajdu: Slajd omawia zagadnienie „Ewolucja HTTP: od HTTP/1.0 do HTTP/1.1” w kontekście: Od osobnych połączeń do trwałych sesji TCP.

Od osobnych połączeń do trwałych sesji TCP

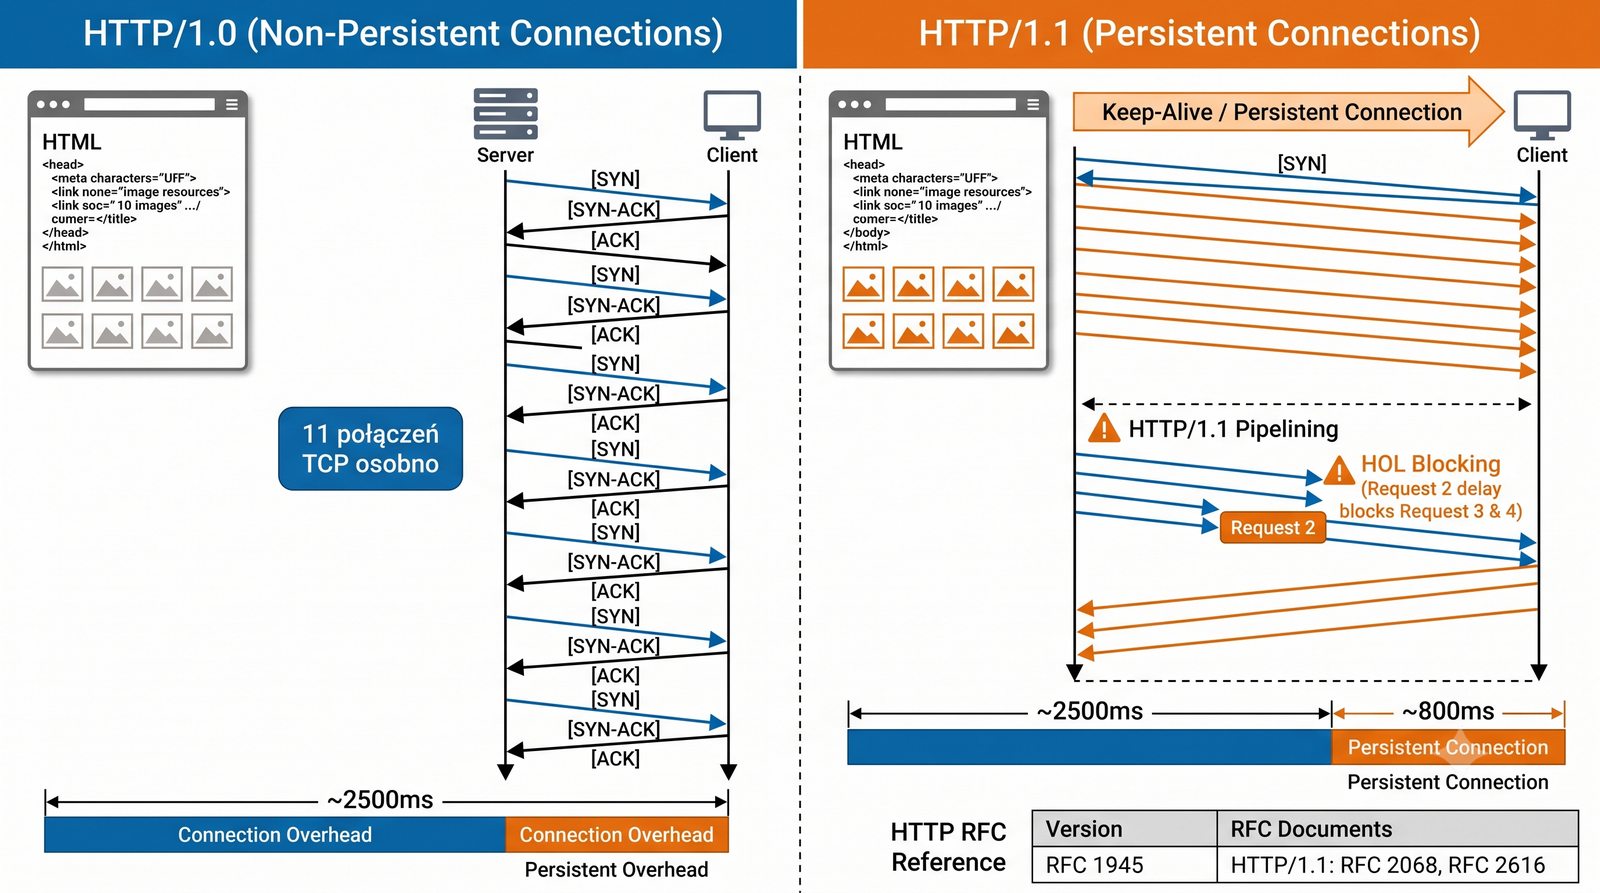
  • HTTP/1.0 (RFC 1945, maj 1996):
    • Każde pojedyncze żądanie i odpowiedź wymagało nawiązania nowego połączenia TCP (pełny 3-way handshake SYN-SYN/ACK-ACK) oraz jego natychmiastowego zamknięcia (FIN/ACK).
    • Ogromny narzut sieciowy: strona zawierająca dokument HTML i 30 plików graficznych wymagała zestawienia aż 31 niezależnych połączeń TCP, co przy wysokich czasach RTT paraliżowało wydajność.
  • HTTP/1.1 (RFC 2616 (1999), zastąpiony przez RFC 7230–7235 (2014), obecnie przez RFC 9110/RFC 9112 (2022)):
    • Wprowadzenie domyślnych połączeń trwałych (Persistent Connections / Keep-Alive) – jedno połączenie TCP obsługuje sekwencyjnie wiele kolejnych żądań i odpowiedzi.
    • Obowiązkowy nagłówek Host (kluczowy dla wirtualnego hostingu opartego na nazwie).
    • Kodowanie fragmentowane (Chunked Transfer Encoding): możliwość przesyłania dynamicznie generowanych danych o nieznanym z góry rozmiarze bez zamykania gniazda.
    • Koncepcja potokowości (Pipelining): wysyłanie kolejnych żądań bez czekania na odpowiedź na poprzednie, w praktyce porzucona z powodu blokowania czoła kolejki (Head-of-Line Blocking na poziomie protokołu aplikacyjnego).
Ewolucja HTTP: od HTTP/1.0 do HTTP/1.1: Slajd przedstawia zagadnienie Od osobnych połączeń do trwałych sesji TCP w ramach tematu Ewolucja HTTP: od HTTP/1.0 do HTTP/1.1 na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
HTTP/1.0 vs HTTP/1.1
7/50
Ewolucja HTTP: HTTP/2 i HTTP/3
Cel slajdu: Slajd omawia zagadnienie „Ewolucja HTTP: HTTP/2 i HTTP/3” w kontekście: Multipleksowanie i QUIC jako przełom w wydajności.

Multipleksowanie i QUIC jako przełom w wydajności

  • HTTP/2 (RFC 9113, zastępujący RFC 7540):
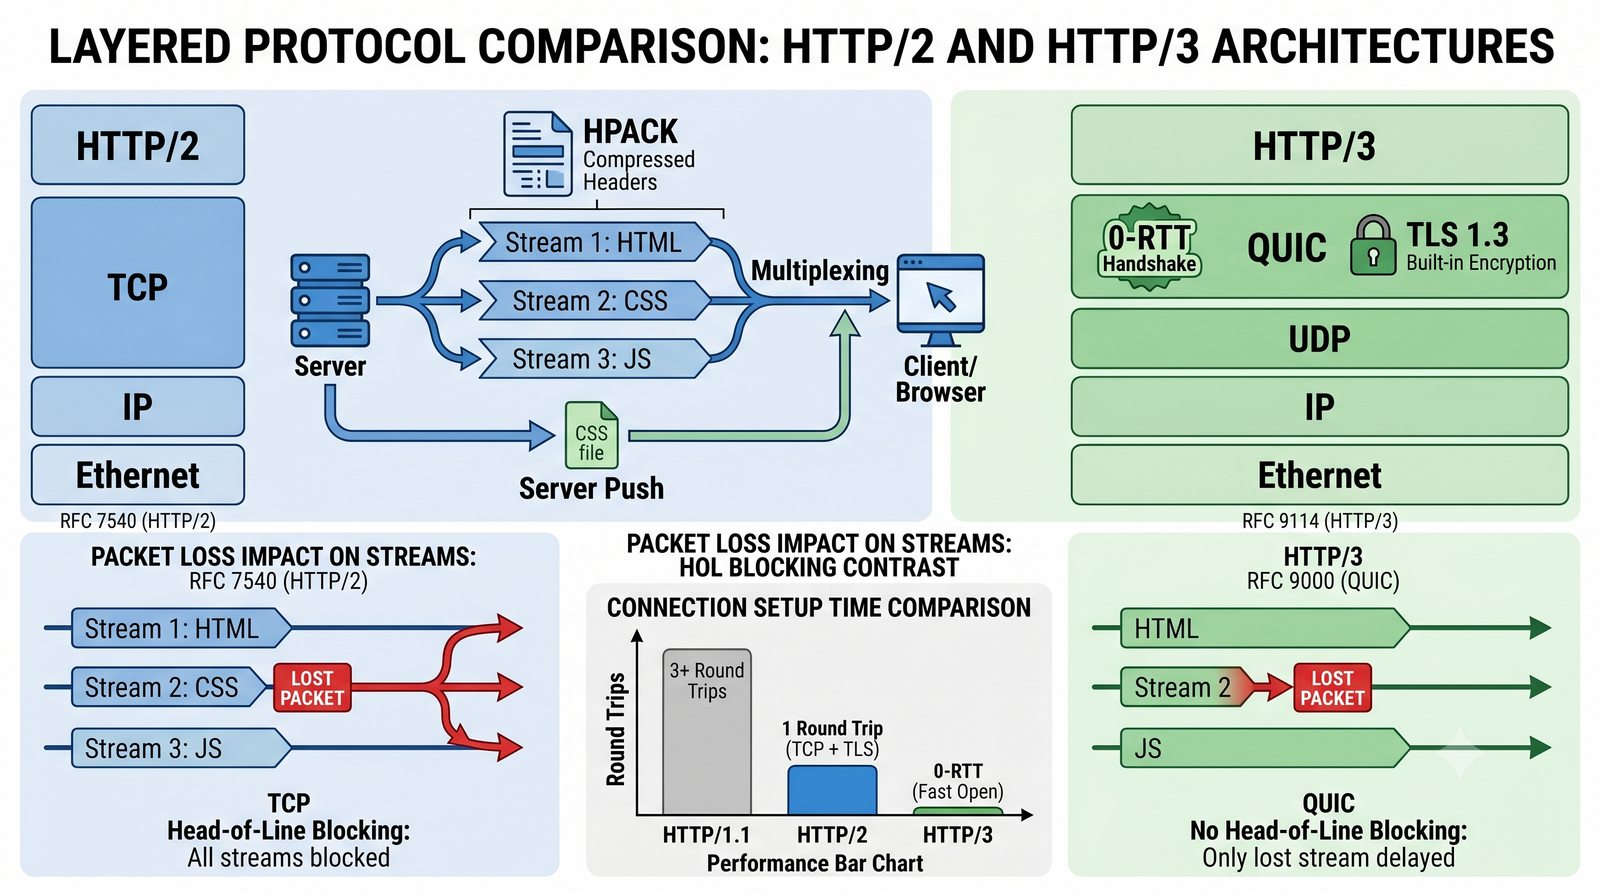
    • Protokół binarny: Zastąpienie formatu tekstowego binarnymi ramkami (Frames) pogrupowanymi w niezależne strumienie (Streams).
    • Pełne multipleksowanie (Multiplexing): Równoczesne przesyłanie wielu zapytań i odpowiedzi w ramach jednego połączenia TCP bez blokowania kolejki na poziomie aplikacji.
    • Kompresja nagłówków HPACK (RFC 7541): Eliminacja redundancji powtarzających się nagłówków poprzez tablice statyczne i dynamiczne (w HTTP/3 odpowiednikiem jest kompresja QPACK).
    • Priorytetyzacja strumieni i Server Push: Serwer może asynchronicznie przesyłać krytyczne zasoby (np. CSS) przed jawnym żądaniem klienta. Uwaga: mechanizm Server Push jest przestarzały i wycofywany z przeglądarek; zamiast niego stosuje się wstępne podpowiedzi 103 Early Hints (RFC 8297).
  • HTTP/3 (RFC 9114 na fundamencie QUIC – RFC 9000):
    • Przejście na UDP: Zastąpienie protokołu TCP protokołem QUIC działającym w przestrzeni użytkownika na bazie datagramów UDP.
    • Eliminacja transportowego HoL Blocking: Utrata pojedynczego pakietu w jednym strumieniu nie wstrzymuje odbioru danych w pozostałych strumieniach.
    • Natywne szyfrowanie TLS 1.3 (RFC 8446): Skrócenie czasu nawiązywania bezpiecznego połączenia do 1-RTT, a przy ponownym połączeniu do 0-RTT.
    • Odporność na migrację sieci (Connection Migration): Identyfikator połączenia (Connection ID) pozwala kontynuować transfer przy zmianie adresu IP (np. przełączenie z Wi-Fi na LTE).
Ewolucja HTTP: HTTP/2 i HTTP/3: Slajd przedstawia zagadnienie Multipleksowanie i QUIC jako przełom w wydajności w ramach tematu Ewolucja HTTP: HTTP/2 i HTTP/3 na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
HTTP/2 i HTTP/3
8/50
Połączenia HTTP: przegląd procedury
Cel slajdu: Slajd omawia zagadnienie „Połączenia HTTP: przegląd procedury” w kontekście: Pełny cykl żądania od zapytania DNS do renderowania odpowiedzi.

Pełny cykl żądania od zapytania DNS do renderowania odpowiedzi

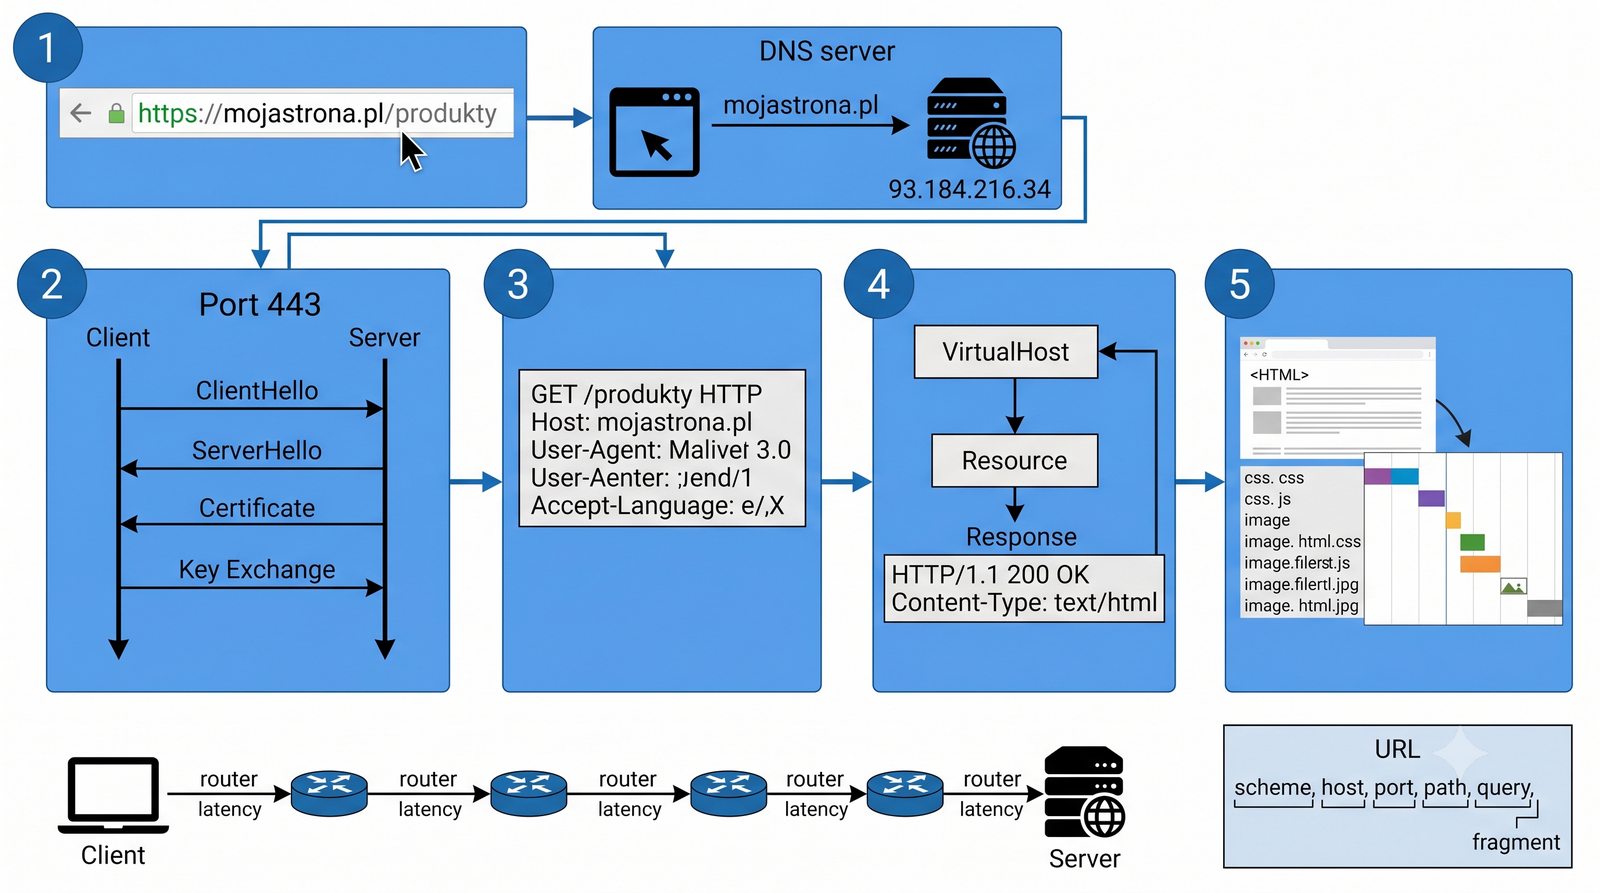
  1. Rozwiązanie nazwy domenowej (DNS Resolution): Przeglądarka sprawdza pamięć podręczną (DNS cache), a w przypadku braku wpisu wysyła zapytanie rekurencyjne na port UDP/53 serwera DNS celem uzyskania adresu IP (rekord A dla IPv4 lub AAAA dla IPv6).
  2. Nawiązanie połączenia transportowego (TCP Handshake): Trójstopniowa wymiana pakietów (SYN → SYN-ACK → ACK) na standardowy port docelowy (port 80 dla HTTP, port 443 dla HTTPS).
  3. Negocjacja bezpiecznego kanału (TLS 1.3 Handshake): Wymiana parametrów kryptograficznych, walidacja łańcucha zaufania certyfikatu X.509 serwera, uzgodnienie klucza sesji (np. ECDHE) oraz przesłanie nazwy domeny w rozszerzeniu SNI (RFC 6066).
  4. Przesłanie żądania HTTP: Wysłanie sformatowanego bloku żądania (linia żądania, nagłówki, opcjonalna treść/body).
  5. Przetwarzanie po stronie serwera WWW: Inspekcja reguł wirtualnych hostów, uprawnień dostępu, wykonanie skryptu backendowego (np. PHP-FPM przez FastCGI) lub odczyt pliku z dysku z użyciem wywołania sendfile().
  6. Odebranie i interpretacja odpowiedzi: Przesłanie nagłówków odpowiedzi z kodem statusu (np. 200 OK) i ciałem zasobu. Przeglądarka rozpoczyna parsowanie drzewa DOM i kaskadowe pobieranie zasobów powiązanych (CSS, JS, media).
Połączenia HTTP: przegląd procedury: Slajd przedstawia zagadnienie Pełny cykl żądania od zapytania DNS do renderowania odpowiedzi w ramach tematu Połączenia HTTP: przegląd procedury na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
połączenie HTTP
9/50
Struktura żądania HTTP (request)
Cel slajdu: Slajd omawia zagadnienie „Struktura żądania HTTP (request)” w kontekście: Linia żądania, nagłówki i opcjonalna treść wiadomości.

Linia żądania, nagłówki i opcjonalna treść wiadomości

Komunikat żądania w standardzie tekstowym RFC 9112 (HTTP/1.1) posiada ściśle zdefiniowaną strukturę trójsegmentową:

GET /katalog/zasob.html HTTP/1.1
Host: www.example.com
User-Agent: Mozilla/5.0 (X11; Linux x86_64)
Accept: text/html,application/xhtml+xml
Accept-Language: pl,en-US;q=0.7
Connection: keep-alive

[Opcjonalna treść żądania - Message Body]
  • Linia żądania (Request Line): Zawiera nazwę metody HTTP (np. GET, POST), identyfikator zasobu (URI/ścieżkę) oraz deklarowaną wersję protokołu (np. HTTP/1.1), zakończone sekwencją CRLF (\r\n).
  • Nagłówki żądania (Request Headers): Zestaw par Nazwa: Wartość przekazujących metadane (identyfikacja klienta, formaty akceptowanych danych, uprawnienia, parametry buforowania).
  • Pusta linia separatora: Wymagana jest pojedyncza sekwencja znaków powrotu karetki i wysunięcia linii (CRLF), sygnalizująca koniec bloku nagłówków.
  • Ciało komunikatu (Message Body): Opcjonalna treść przesyłana w metodach POST, PUT lub PATCH (np. parametry formularzy, pliki binarne, struktury JSON).
Struktura żądania HTTP (ang. request): Slajd przedstawia zagadnienie Linia żądania, nagłówki i opcjonalna treść wiadomości w ramach tematu Struktura żądania HTTP (request) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
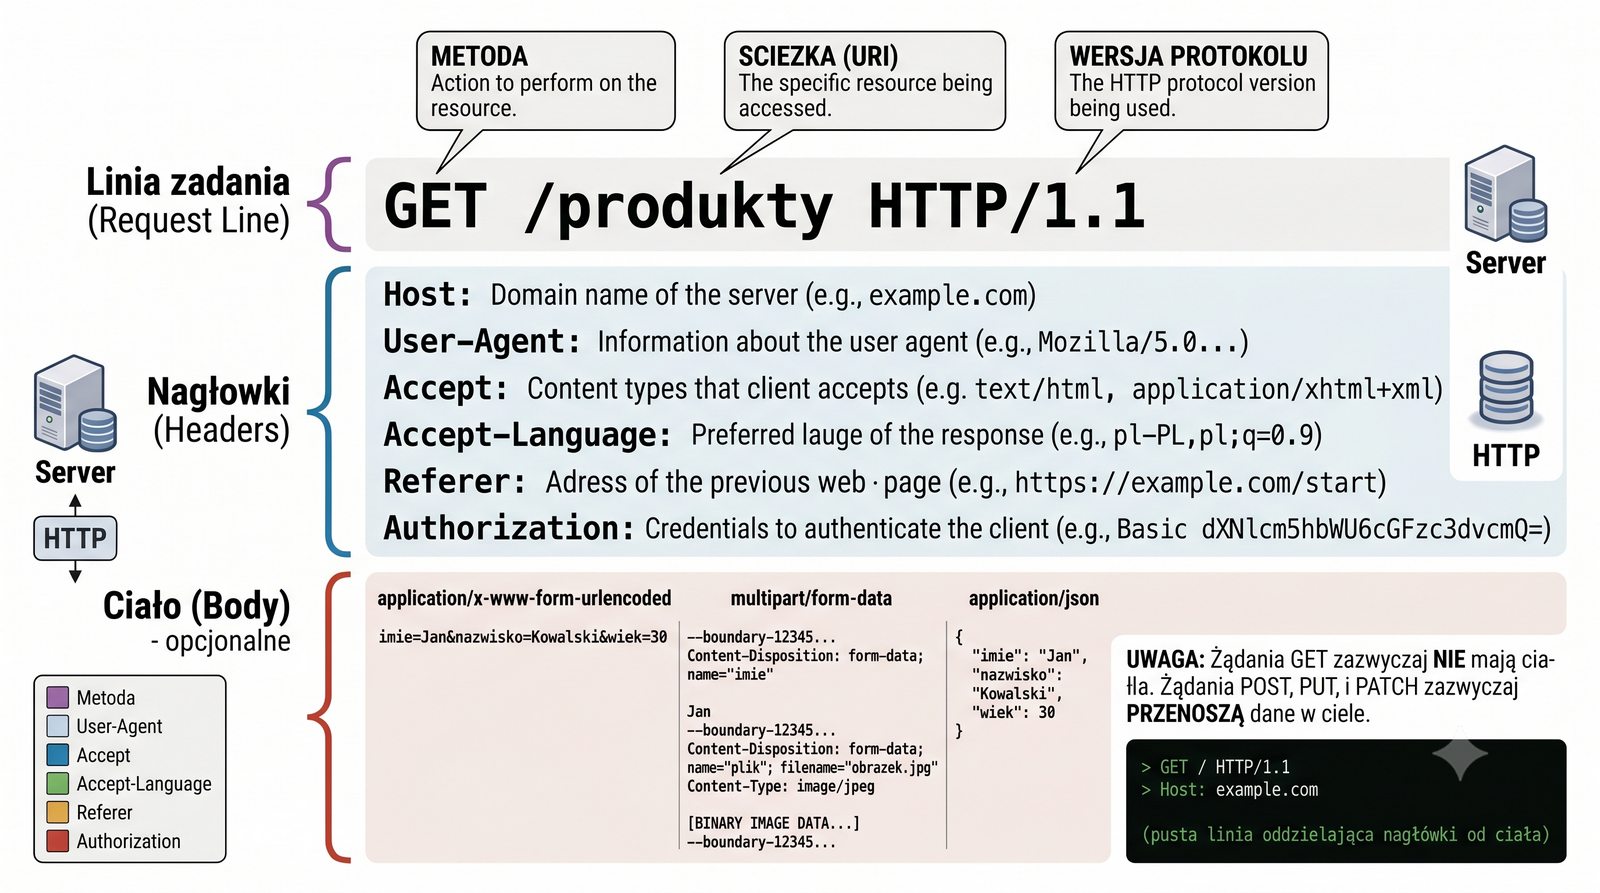
Struktura zadania HTTP
10/50
Struktura odpowiedzi HTTP (response)
Cel slajdu: Slajd omawia zagadnienie „Struktura odpowiedzi HTTP (response)” w kontekście: Status, nagłówki i treść odpowiedzi serwera.

Status, nagłówki i treść odpowiedzi serwera

Odpowiedź generowana przez serwer WWW w standardzie RFC 9112 odzwierciedla symetryczną strukturę żądania:

HTTP/1.1 200 OK
Date: Thu, 01 Oct 2026 12:00:00 GMT
Server: Apache/2.4.58 (Ubuntu)
Content-Type: text/html; charset=UTF-8
Content-Length: 1420
Connection: keep-alive

<!DOCTYPE html>
<html><head>...</head><body>...</body></html>
  • Linia statusu (Status Line): Składa się z wersji protokołu (HTTP/1.1), trzycyfrowego numerycznego kodu statusu (np. 200) oraz frazy opisowej czytelnej dla człowieka (np. OK), zakończona sekwencją CRLF.
  • Nagłówki odpowiedzi (Response Headers): Metadane serwera określające parametry odpowiedzi: znacznik czasu (Date), oprogramowanie serwera (Server), typ zasobu (Content-Type), rozmiar (Content-Length) oraz instrukcje zarządzania sesją (Set-Cookie) i pamięcią podręczną (Cache-Control).
  • Pusta linia separatora (CRLF): Granica oddzielająca nagłówki od przesyłanego ładunku.
  • Ciało odpowiedzi (Response Body): Właściwy strumień danych zasobu (kod HTML, plik graficzny JPEG/PNG, skrypt JS, arkusz stylów CSS, obiekt JSON itp.).
Struktura odpowiedzi HTTP (ang. response): Slajd przedstawia zagadnienie Status, nagłówki i treść odpowiedzi serwera w ramach tematu Struktura odpowiedzi HTTP (response) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
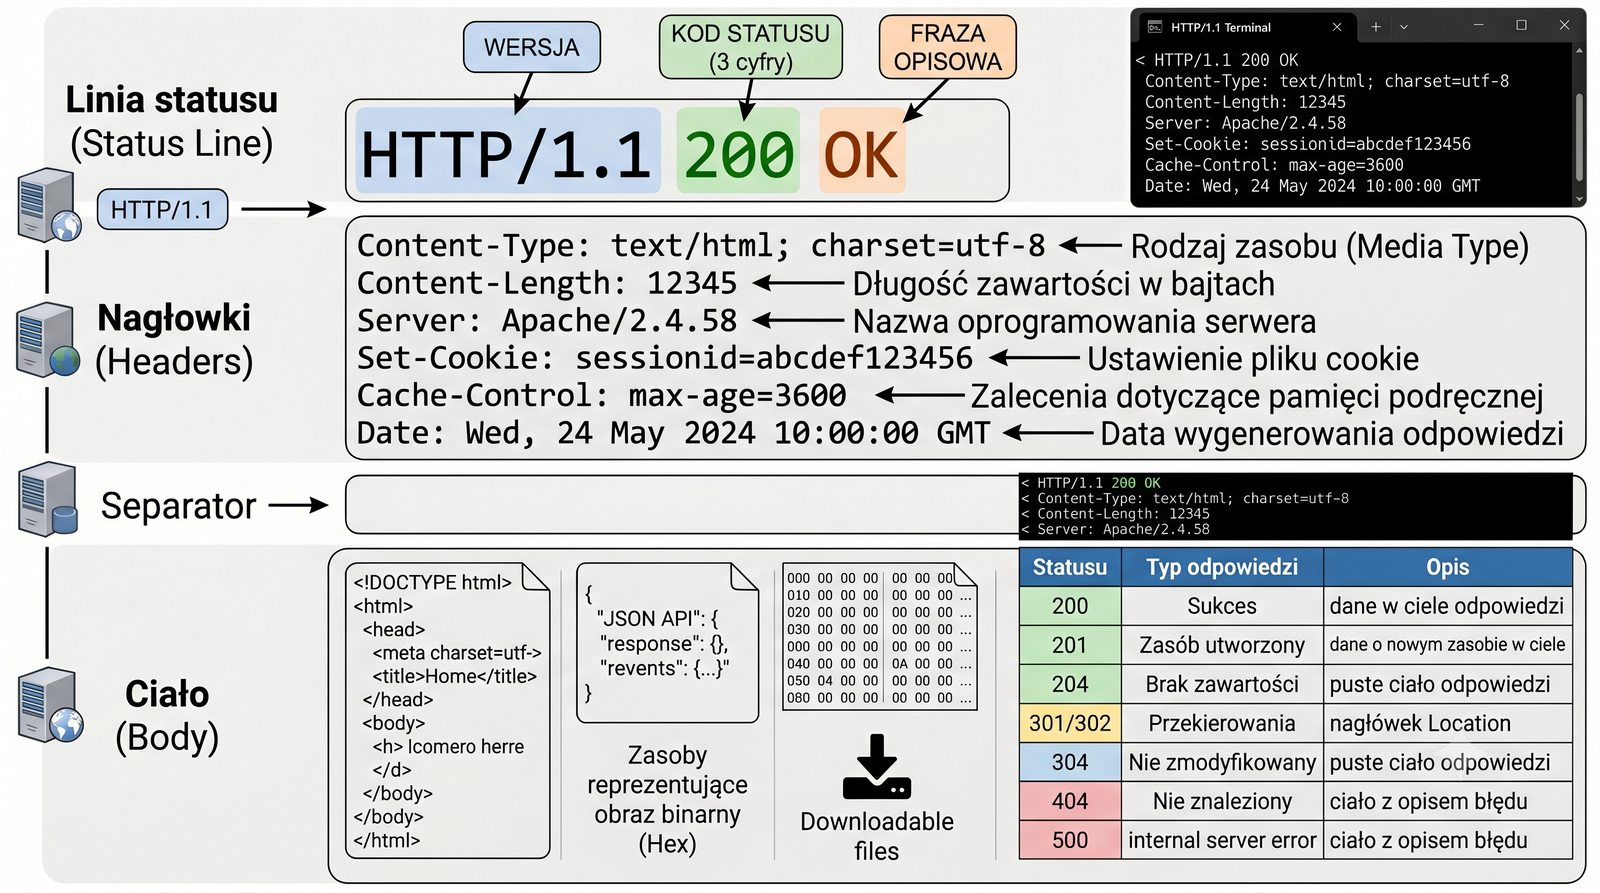
Struktura odpowiedzi HTTP
11/50
Przykładowa sesja HTTP (telnet / netcat)
Cel slajdu: Slajd omawia zagadnienie „Przykładowa sesja HTTP (telnet / netcat)” w kontekście: Manualna komunikacja z serwerem przez surowe gniazdo TCP.

Manualna komunikacja z serwerem przez surowe gniazdo TCP

Wykorzystując narzędzia konsolowe telnet lub nc (netcat), inżynier sieci może nawiązać bezpośrednie połączenie z portem 80/TCP serwera WWW, ręcznie przesłać ramkę żądania i przeanalizować surową odpowiedź protokołu:

telnet example.com 80
Trying 93.184.215.14...
Connected to example.com.
Escape character is '^]'.
GET / HTTP/1.1
Host: example.com
Connection: close
[Wciśnięcie klawisza ENTER – pusta linia CRLF]

HTTP/1.1 200 OK
Content-Type: text/html; charset=UTF-8
Content-Length: 1256
Date: Thu, 01 Oct 2026 12:00:00 GMT
Server: cloudflare (wartość zależy od operatora CDN; zweryfikuj poleceniem curl -sI http://example.com)

<!doctype html>
<html><head>...</head><body>...</body></html>
Connection closed by foreign host.
  • Kluczowe elementy składniowe: Podanie metody, ścieżki i wersji w pierwszej linii, obowiązkowy nagłówek Host oraz dwukrotne naciśnięcie klawisza Enter (sekwencja CRLF CRLF).
  • Połączenia szyfrowane (HTTPS): W przypadku portu 443/TLS zamiast telnetu stosuje się polecenie: openssl s_client -connect example.com:443 -servername example.com -crlf.
Przykładowa sesja HTTP (ang. telnet / netcat): Slajd przedstawia zagadnienie Manualna komunikacja z serwerem przez surowe gniazdo TCP w ramach tematu Przykładowa sesja HTTP (telnet / netcat) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
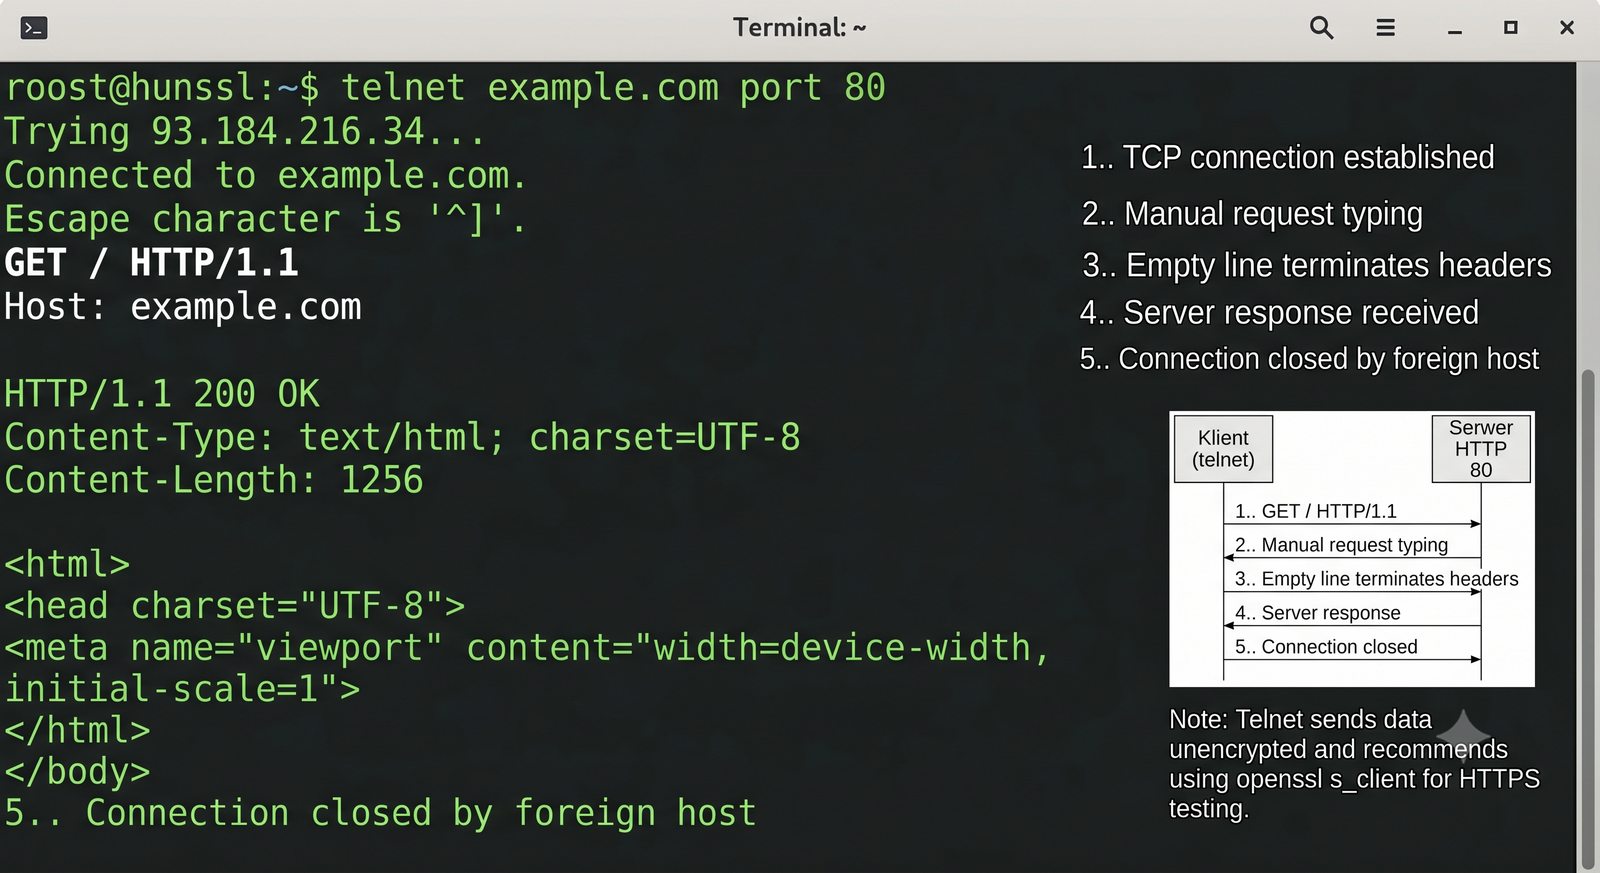
Sesja telnet HTTP
12/50
Model żądanie-odpowiedź w HTTP
Cel slajdu: Slajd omawia zagadnienie „Model żądanie-odpowiedź w HTTP” w kontekście: Klient inicjuje, serwer odpowiada biernie.

Klient inicjuje, serwer odpowiada biernie

  • Asymetria ról (Client-Server Architecture): Komunikacja w protokole HTTP jest z definicji jednostronna – to klient (inicjator) otwiera połączenie transportowe i wysyła zapytanie. Serwer WWW nasłuchuje w trybie pasywnym i odsyła odpowiedź.
  • Brak możliwości spontanicznej inicjacji przez serwer: W klasycznym HTTP serwer nie może samodzielnie przesłać danych do klienta bez uprzedniego żądania.
  • Technologie komunikacji asynchronicznej i dwukierunkowej:
    • Odpytywanie długie (Long Polling): Klient wysyła żądanie, serwer wstrzymuje odpowiedź (blokuje gniazdo) do momentu pojawienia się nowych danych.
    • Server-Sent Events (SSE): Jednokierunkowy strumień tekstowy (text/event-stream) od serwera do przeglądarki utrzymywany na otwartym połączeniu HTTP.
    • WebSocket (RFC 6455): Pełny dupleks (dwukierunkowy) po uprzednim przełączeniu protokołu z HTTP za pomocą nagłówków Upgrade: websocket i Connection: Upgrade.
  • Semantyka idempotentności i bezpieczeństwa: Zgodnie z RFC 9110 metody HTTP dzielą się na bezpieczne (safe – nie modyfikujące stanu zasobów) oraz idempotentne (idempotent – wielokrotne wykonanie wywołuje ten sam stan docelowy na serwerze).
Model żądanie-odpowiedź w HTTP: Slajd przedstawia zagadnienie Klient inicjuje, serwer odpowiada biernie w ramach tematu Model żądanie-odpowiedź w HTTP na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
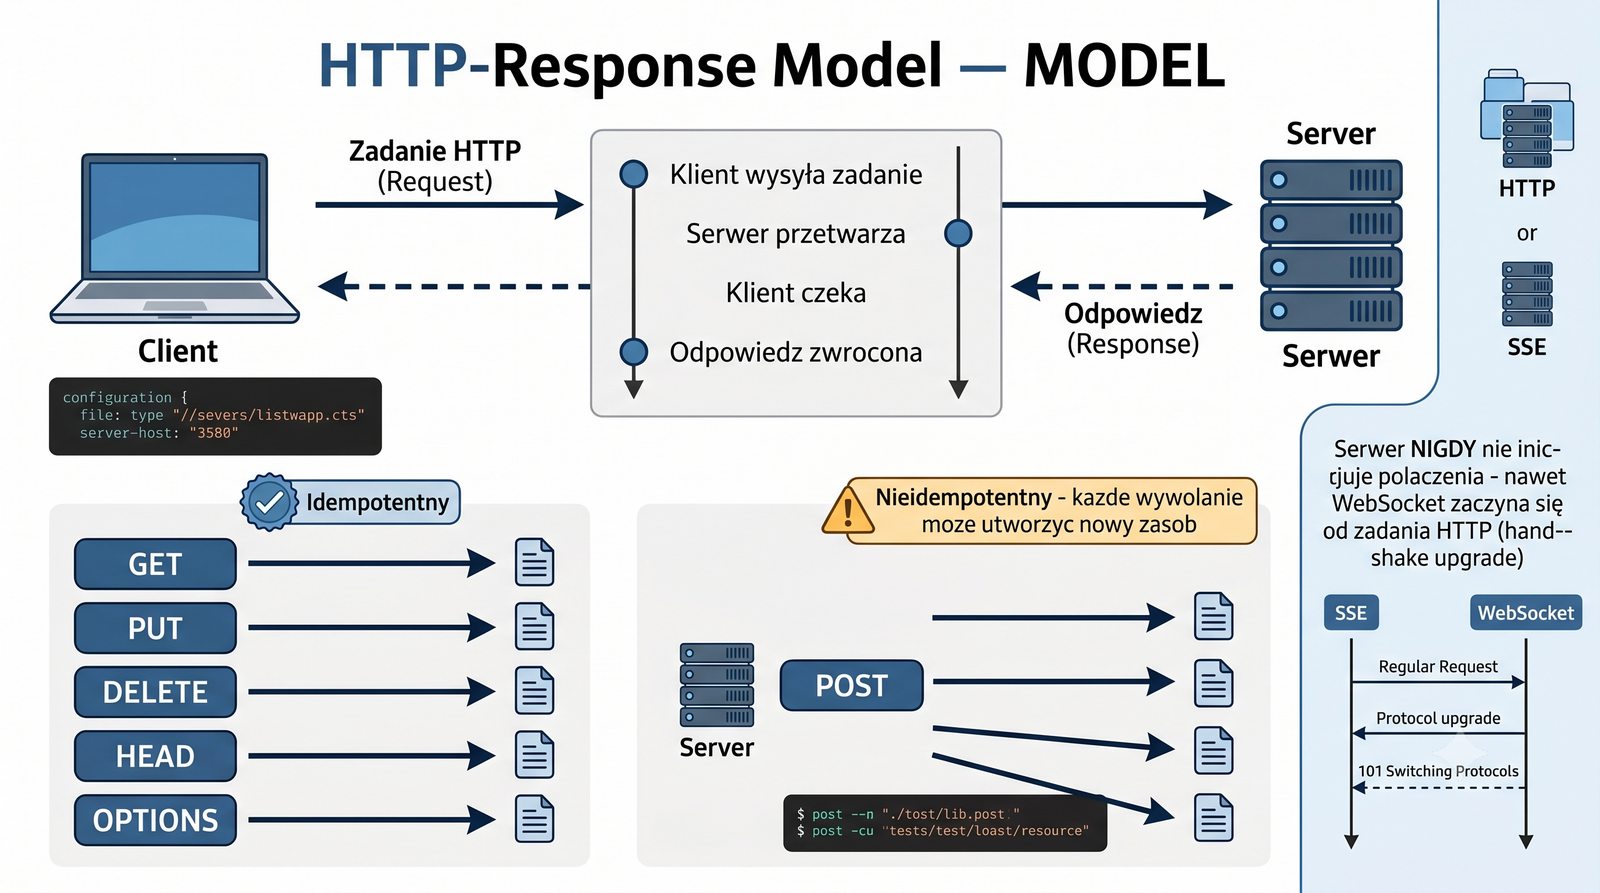
Model zadanie-odpowiedź
13/50
Metody HTTP – przegląd (cz. 1)
Cel slajdu: Slajd omawia zagadnienie „Metody HTTP – przegląd (cz. 1)” w kontekście: Główne metody manipulacji zasobami: GET, POST, PUT, DELETE, PATCH.

Główne metody manipulacji zasobami: GET, POST, PUT, DELETE, PATCH

Zgodnie ze standardem RFC 9110 oraz RFC 5789 metody determinują operację semantyczną na wskazanym identyfikatorze URI:

Metoda Semantyka operacji Ciało (Body) Bezpieczna? Idempotentna?
GET Pobranie reprezentacji zasobu z serwera; domyślna metoda przeglądarek Nie (ignorowane) Tak Tak
POST Przetworzenie danych przez serwer; utworzenie zasobu podrzędnego Tak Nie Nie
PUT Utworzenie lub całkowite zastąpienie zasobu pod zadanym URI Tak Nie Tak
DELETE Usunięcie wskazanego zasobu z przestrzeni nazw serwera Opcjonalne Nie Tak
PATCH Częściowa modyfikacja zasobu (zdefiniowana w RFC 5789) Tak Nie Nie
Metody HTTP – przegląd: Slajd przedstawia zagadnienie Główne metody manipulacji zasobami: GET, POST, PUT, DELETE, PATCH w ramach tematu Metody HTTP – przegląd (cz. 1) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
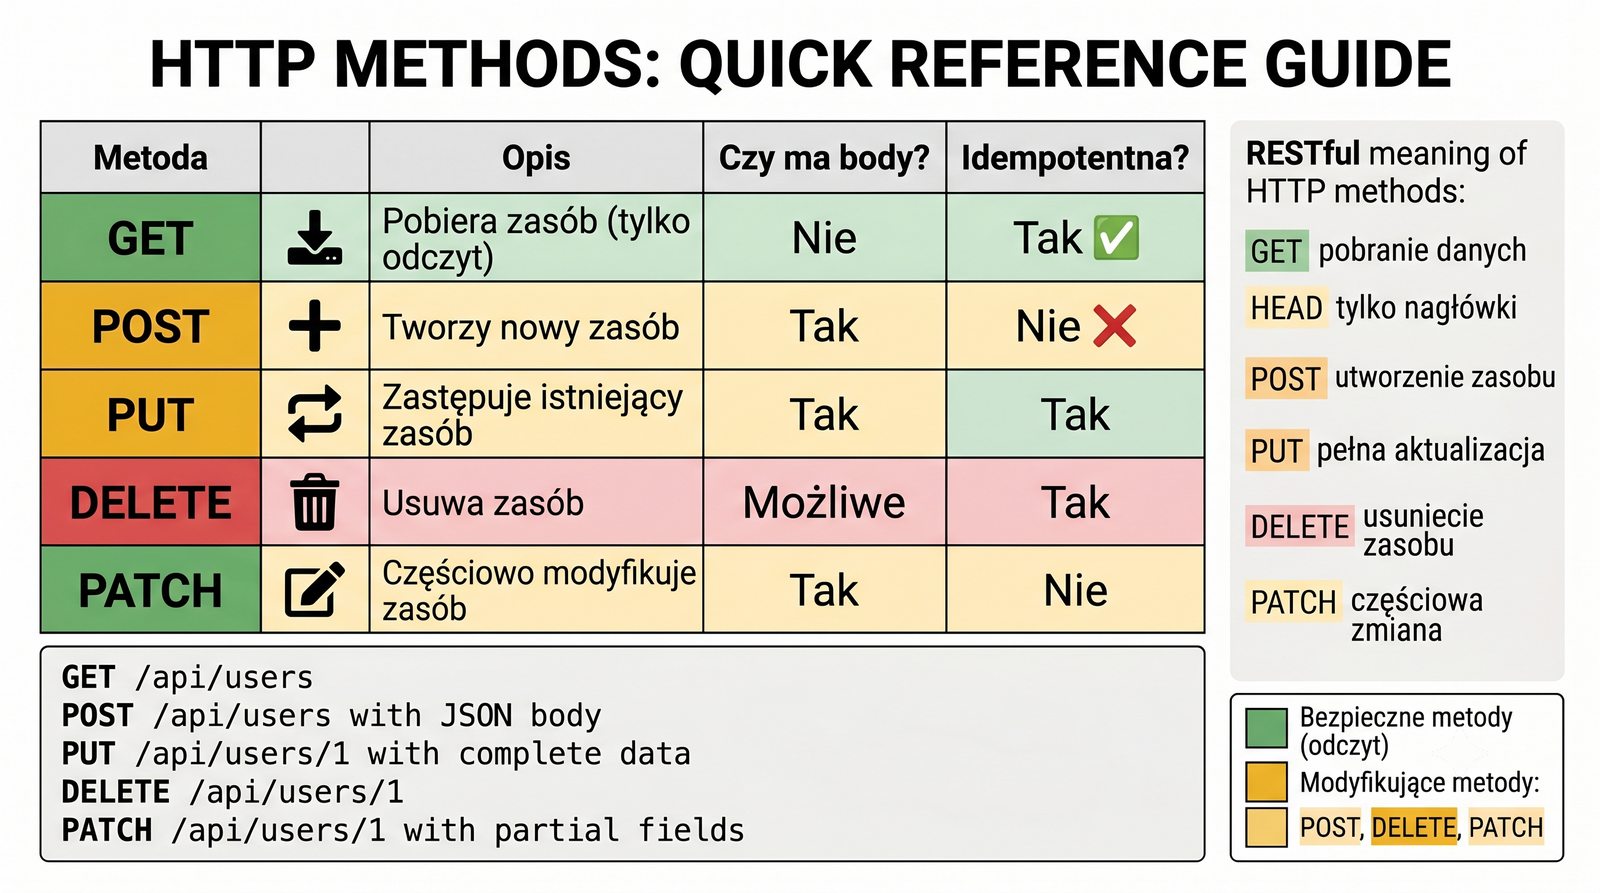
Metody HTTP cz.1
14/50
Metody HTTP – przegląd (cz. 2)
Cel slajdu: Slajd omawia zagadnienie „Metody HTTP – przegląd (cz. 2)” w kontekście: Metody specjalne i diagnostyczne: HEAD, OPTIONS, TRACE, CONNECT.

Metody specjalne i diagnostyczne: HEAD, OPTIONS, TRACE, CONNECT

  • HEAD: Działa identycznie jak metoda GET, lecz serwer zwraca wyłącznie linię statusu i nagłówki, bez ciała odpowiedzi.
    • Zastosowanie: Błyskawiczna weryfikacja dostępności zasobu, sprawdzenie rozmiaru pliku (Content-Length), typu MIME lub znacznika świeżości (ETag, Last-Modified) przed pobraniem dużej ilości danych.
  • OPTIONS: Zwraca listę metod i funkcjonalności obsługiwanych przez serwer dla danego URI.
    • Zastosowanie: Kluczowa rola w mechanizmie CORS (Cross-Origin Resource Sharing), gdzie przeglądarka wysyła tzw. zapytanie wstępne (preflight request) z nagłówkiem Origin przed realizacją operacji z innej domeny.
  • TRACE: Wykonuje pętlę zwrotną (loop-back) żądania – serwer odsyła klientowi dokładnie to, co otrzymał, jako ciało odpowiedzi typu message/http.
    • Rygor bezpieczeństwa: Metoda TRACE jest niemal powszechnie wyłączana na serwerach produkcyjnych (dyrektywa TraceEnable off w Apache), ponieważ umożliwia ataki XST (Cross-Site Tracing) kradnące ciasteczka z flagą HttpOnly.
  • CONNECT: Przekształca żądanie w przezroczysty, dwukierunkowy tunel TCP – fundament działania serwerów proxy pośredniczących w bezpiecznym ruchu HTTPS.
Metody HTTP – przegląd: Slajd przedstawia zagadnienie Metody specjalne i diagnostyczne: HEAD, OPTIONS, TRACE, CONNECT w ramach tematu Metody HTTP – przegląd (cz. 2) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
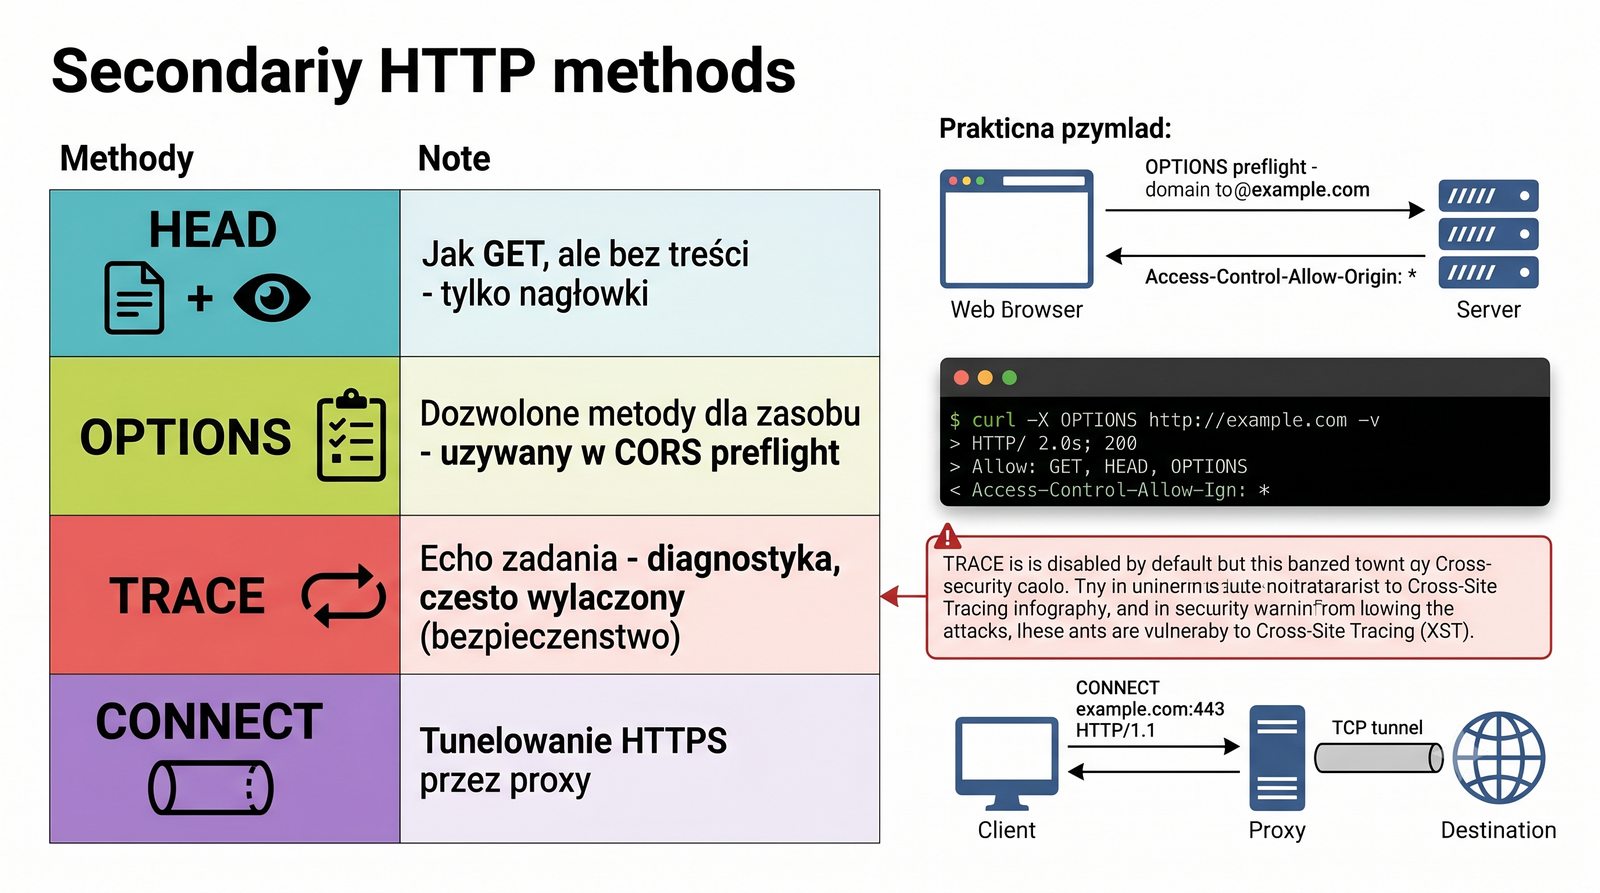
Metody HTTP cz.2
15/50
Kody statusu HTTP – 1xx i 2xx
Cel slajdu: Slajd omawia zagadnienie „Kody statusu HTTP – 1xx i 2xx” w kontekście: Komunikaty informacyjne oraz potwierdzenia powodzenia operacji.

Komunikaty informacyjne oraz potwierdzenia powodzenia operacji

Zgodnie ze standardem RFC 9110 kody statusu to trzycyfrowe liczby, których pierwsza cyfra definiuje ogólną klasę odpowiedzi serwera:

  • Klasa 1xx (Informacyjne – Informational): Przejściowe komunikaty protokołu; serwer potwierdza odbiór nagłówków i kontynuuje przetwarzanie:
    • 100 Continue – potwierdzenie, że serwer zaakceptował wstępne nagłówki i klient może przesłać właściwe ciało żądania (wysyłane po nagłówku Expect: 100-continue).
    • 101 Switching Protocols – serwer akceptuje żądanie zmiany protokołu (np. przełączenie na WebSocket wg RFC 6455).
    • 103 Early Hints – (RFC 8297) wstępne przesłanie nagłówków Link: rel=preload przed ostatecznym wygenerowaniem odpowiedzi, przyspieszające ładowanie CSS/JS.
  • Klasa 2xx (Sukces – Successful): Żądanie klienta zostało pomyślnie odebrane, zrozumiane i przetworzone:
    • 200 OK – standardowa odpowiedź sukcesu zwracająca reprezentację zasobu.
    • 201 Created – zasób został pomyślnie utworzony na serwerze (najczęściej w odpowiedzi na POST lub PUT); serwer dołącza nagłówek Location z nowym URI.
    • 204 No Content – operacja zakończona sukcesem, lecz odpowiedź celowo nie zawiera ciała (powszechne w operacjach DELETE w API REST).
    • 206 Partial Content – serwer zwraca jedynie określony fragment pliku na podstawie żądania z nagłówkiem Range: bytes=... (kluczowe przy strumieniowaniu wideo).
Kody statusu HTTP – 1xx i 2xx: Slajd przedstawia zagadnienie Komunikaty informacyjne oraz potwierdzenia powodzenia operacji w ramach tematu Kody statusu HTTP – 1xx i 2xx na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
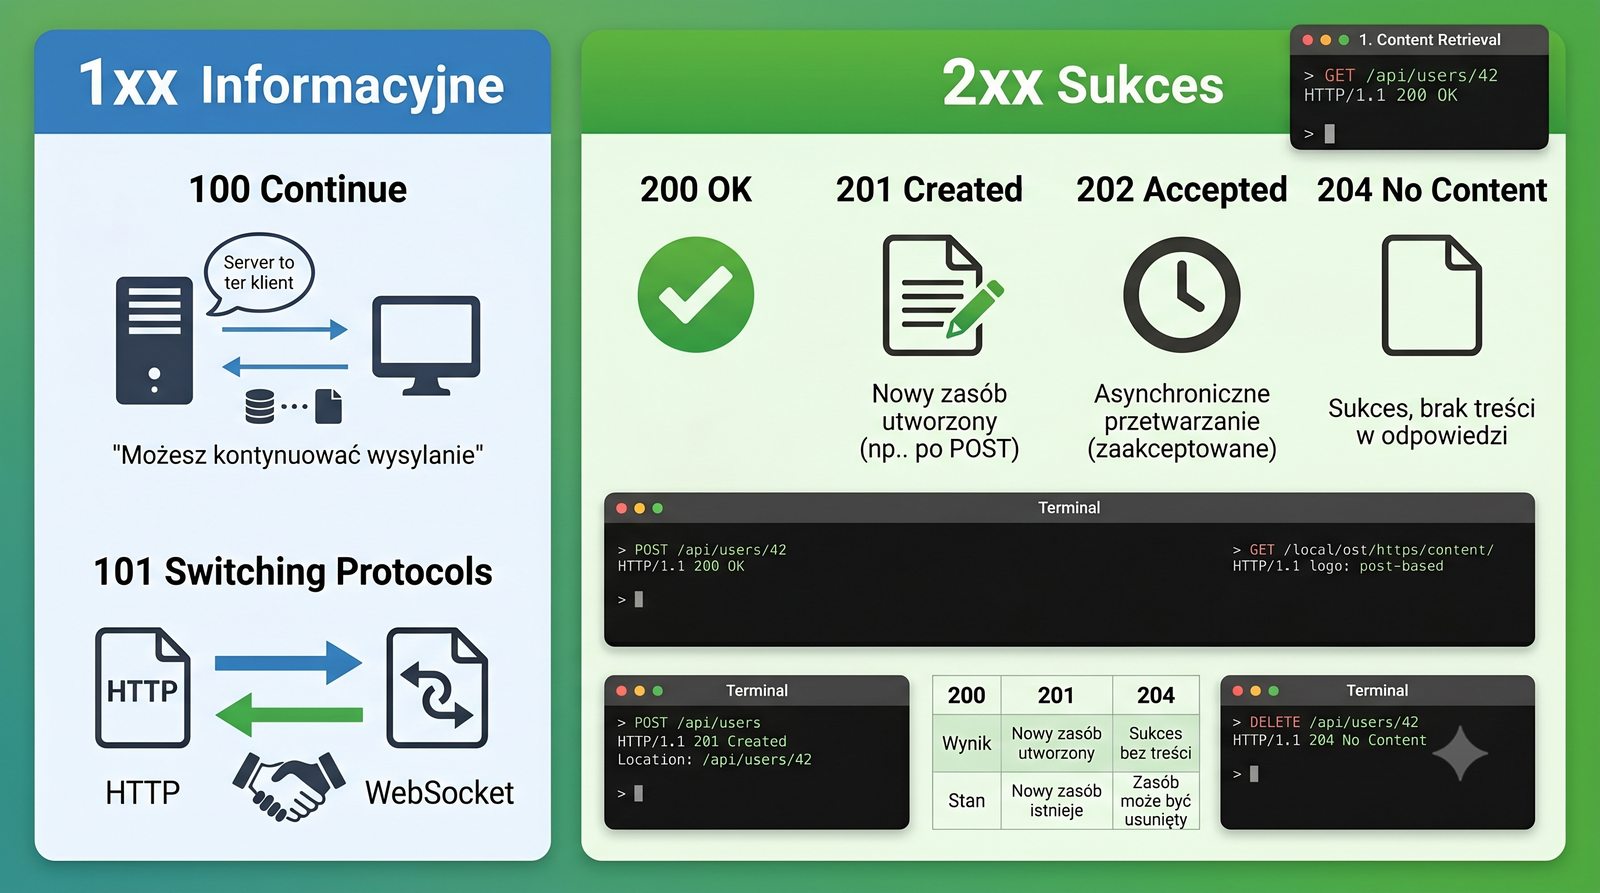
Kody 1xx i 2xx
16/50
Kody statusu HTTP – 3xx (przekierowania)
Cel slajdu: Slajd omawia zagadnienie „Kody statusu HTTP – 3xx (przekierowania)” w kontekście: Stałe i tymczasowe przekierowania oraz obsługa pamięci podręcznej.

Stałe i tymczasowe przekierowania oraz obsługa pamięci podręcznej

Odpowiedzi z klasy 3xx informują klienta, że w celu sfinalizowania operacji musi wykonać dodatkowe działanie (najczęściej wysłać nowe żądanie pod adres wskazany w nagłówku Location):

  • 301 Moved Permanently: Trwałe przeniesienie zasobu pod nowy adres URI.
    • Przeglądarki i roboty sieciowe zapamiętują to przekierowanie na stałe w pamięci podręcznej i przekazują wartość SEO (PageRank). Historycznie przeglądarki zmieniały metodę z POST na GET.
  • 302 Found: Tymczasowe przekierowanie zasobu (oryginalnie w HTTP/1.0 Moved Temporarily). Klient w przyszłości powinien nadal odpytywać stary adres URI.
  • 303 See Other: Wymusza pobranie zasobu docelowego zawsze metodą GET. Kluczowy składnik wzorca Post/Redirect/Get (PRG) zapobiegającego powtórnemu wysyłaniu formularzy po odświeżeniu strony.
  • 304 Not Modified: Odpowiedź na żądanie warunkowe (nagłówki If-None-Match lub If-Modified-Since). Zasób nie uległ zmianie; odpowiedź nie zawiera ciała, a klient pobiera dane z lokalnego cache.
  • 307 Temporary Redirect: Ścisłe tymczasowe przekierowanie zdefiniowane w RFC 9110 – klient nie może zmieniać metody ani treści żądania (np. POST pozostaje POST).
  • 308 Permanent Redirect: (RFC 7538, włączony do RFC 9110) Ścisły odpowiednik kodu 301 gwarantujący ścisłe zachowanie metody i ciała żądania.
Kody statusu HTTP – 3xx (przekierowania): Slajd przedstawia zagadnienie Stałe i tymczasowe przekierowania oraz obsługa pamięci podręcznej w ramach tematu Kody statusu HTTP – 3xx (przekierowania) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
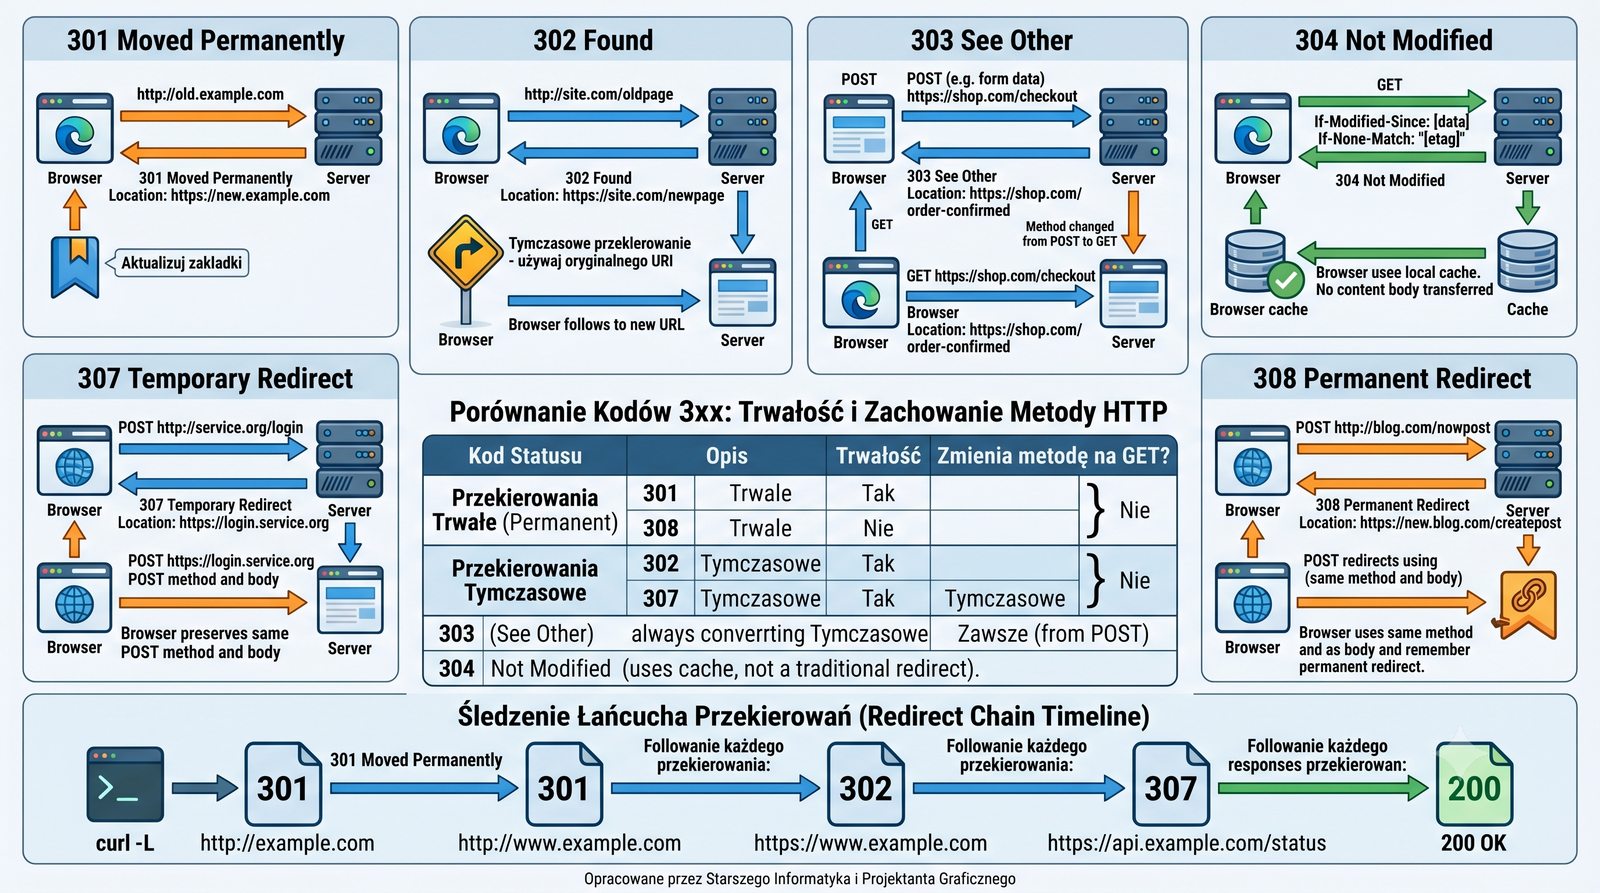
Kody 3xx
17/50
Kody statusu HTTP – 4xx (błędy klienta)
Cel slajdu: Slajd omawia zagadnienie „Kody statusu HTTP – 4xx (błędy klienta)” w kontekście: Nieprawidłowości po stronie klienta i ich diagnostyka.

Nieprawidłowości po stronie klienta i ich diagnostyka

Kody z grupy 4xx wskazują na sytuację, w której żądanie zawiera błędy składniowe, odwołuje się do nieistniejących zasobów lub narusza reguły autoryzacji:

  • 400 Bad Request: Niepoprawna składnia żądania (np. błędy parsowania nagłówków, brak obowiązkowego nagłówka Host w HTTP/1.1, uszkodzone kodowanie znaków).
  • 401 Unauthorized: Brak wymaganych poświadczeń uwierzytelniających. W odpowiedzi serwer musi dołączyć nagłówek WWW-Authenticate określający schemat uwierzytelniania (np. Basic, Bearer).
  • 403 Forbidden: Serwer zrozumiał żądanie i tożsamość klienta, lecz odmawia udzielenia dostępu. Uwierzytelnienie nie pomoże (brak uprawnień w systemie plików, blokada po adresie IP w module mod_authz_core).
  • 404 Not Found: Serwer nie odnalazł zasobu odpowiadającego zadanemu URI.
  • 405 Method Not Allowed: Metoda żądania (np. DELETE) nie jest dozwolona dla tego URI; serwer musi zwrócić nagłówek Allow: GET, POST, HEAD.
  • 408 Request Timeout: Serwer zamknął gniazdo z powodu przekroczenia czasu oczekiwania na nadejście pełnego żądania od klienta.
  • 429 Too Many Requests: (RFC 6585) Przekroczenie limitu liczby zapytań (Rate Limiting); zalecane użycie nagłówka Retry-After.
Kody statusu HTTP – 4xx (błędy klienta): Slajd przedstawia zagadnienie Nieprawidłowości po stronie klienta i ich diagnostyka w ramach tematu Kody statusu HTTP – 4xx (błędy klienta) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
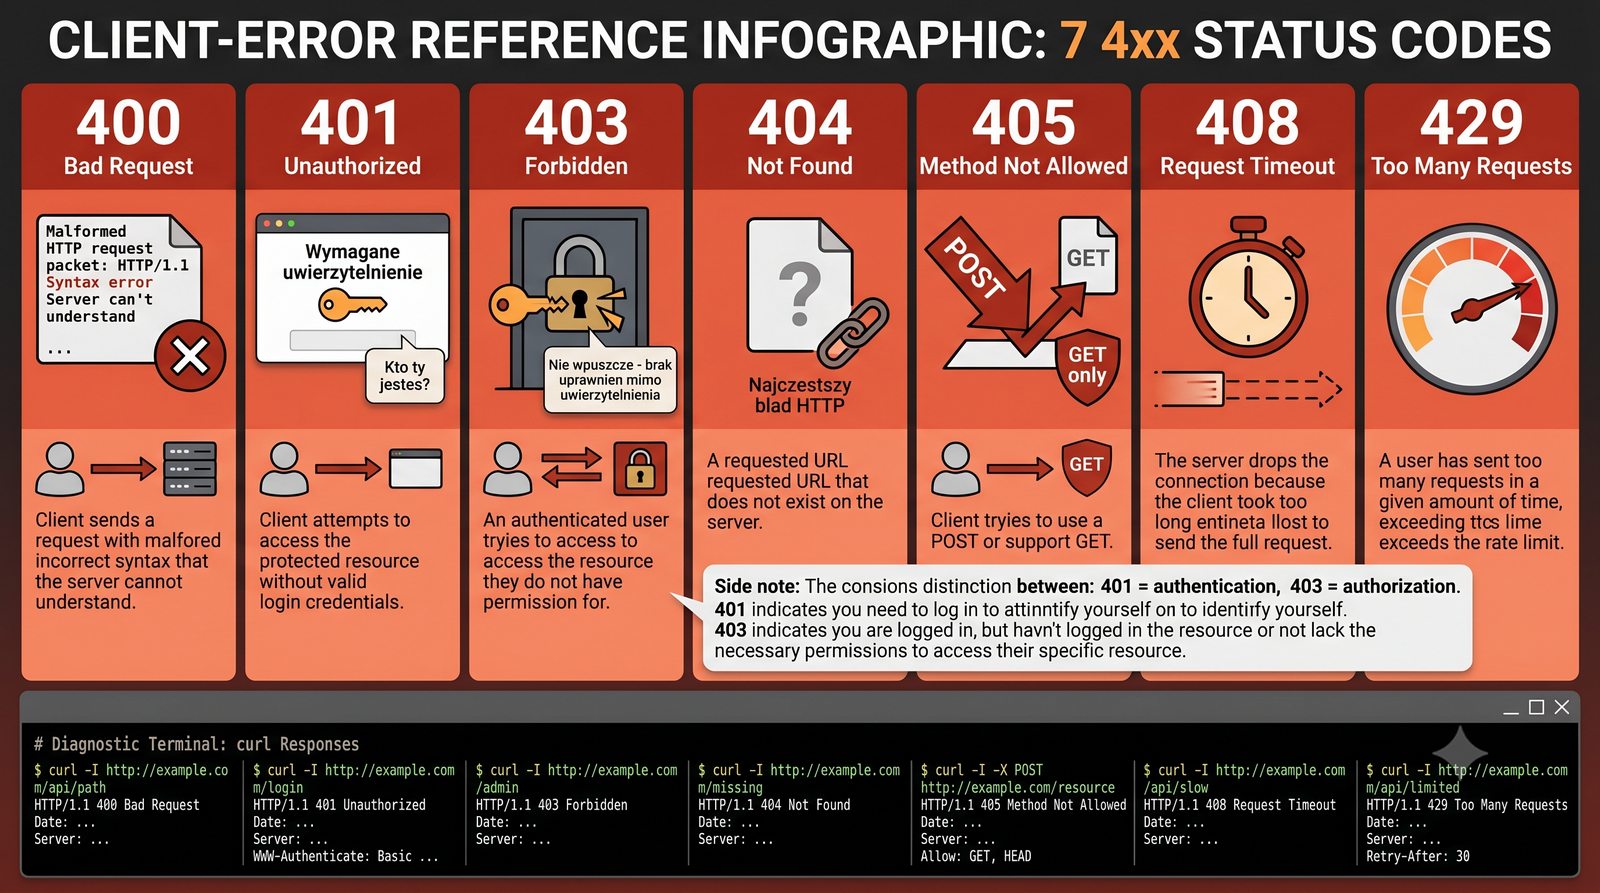
Kody 4xx
18/50
Kody statusu HTTP – 5xx (błędy serwera)
Cel slajdu: Slajd omawia zagadnienie „Kody statusu HTTP – 5xx (błędy serwera)” w kontekście: Awarie po stronie serwera wymagające pilnej interwencji.

Awarie po stronie serwera wymagające pilnej interwencji

Kody z rodziny 5xx oznaczają, że serwer napotkał krytyczną usterkę uniemożliwiającą zrealizowanie poprawnego skądinąd żądania klienta:

  • 500 Internal Server Error: Generyczny błąd serwera. Najczęstsze przyczyny: błąd składniowy w pliku .htaccess w Apache, awaria skryptu aplikacyjnego (np. nieobsłużony wyjątek w PHP/Pythonie), brak pamięci RAM.
  • 501 Not Implemented: Serwer nie posiada funkcjonalności niezbędnej do obsłużenia żądania (np. nieobsługiwana, egzotyczna metoda HTTP).
  • 502 Bad Gateway: Serwer pośredniczący (reverse proxy, np. Nginx) otrzymał nieprawidłową, pustą lub uszkodzoną odpowiedź od serwera nadrzędnego (upstream backend, np. proces PHP-FPM uległ awarii typu segfault).
  • 503 Service Unavailable: Serwer jest chwilowo przeciążony lub wyłączony z powodu prac konserwacyjnych. Powinien zawierać nagłówek Retry-After z czasem wznowienia usługi.
  • 504 Gateway Timeout: Serwer proxy (Nginx/HAProxy) nie otrzymał w wyznaczonym limicie czasu (np. proxy_read_timeout) odpowiedzi od serwera backendowego (np. zawieszone zapytanie SQL do bazy danych).
Kody statusu HTTP – 5xx (błędy serwera): Slajd przedstawia zagadnienie Awarie po stronie serwera wymagające pilnej interwencji w ramach tematu Kody statusu HTTP – 5xx (błędy serwera) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
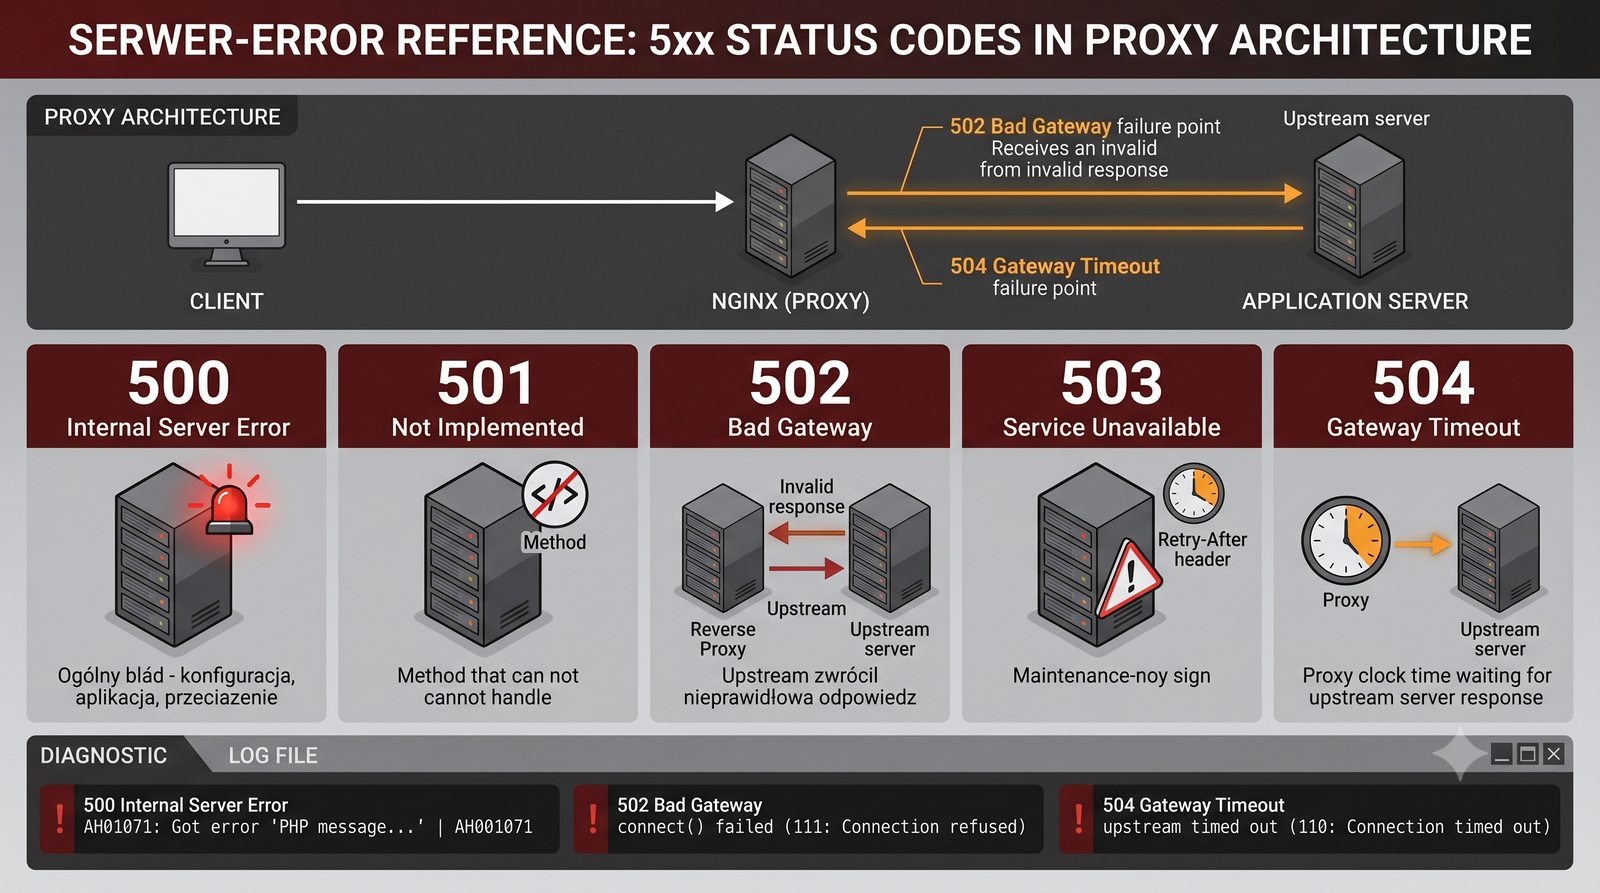
Kody 5xx
19/50
curl -vL – narzędzie administratora
Cel slajdu: Slajd omawia zagadnienie „curl -vL – narzędzie administratora” w kontekście: Wszechstronne narzędzie diagnostyczne protokołu HTTP.

Wszechstronne narzędzie diagnostyczne protokołu HTTP

Program curl to standardowe konsolowe narzędzie inżyniera sieci, umożliwiające precyzyjne konstruowanie zapytań HTTP/HTTPS i inspekcję każdego etapu transmisji:

  • -v (--verbose) – szczegółowy tryb diagnostyczny: wyświetla rozwiązany adres IP, etapy negocjacji TLS, nagłówki wysłane (>) oraz odebrane (<).
  • -L (--location) – automatyczne podążanie za łańcuchem przekierowań 3xx aż do uzyskania ostatecznej odpowiedzi.
  • -I (--head) – wysłanie zapytania metodą HEAD celem pobrania wyłącznie linii statusu i nagłówków.
  • -H "Nazwa: Wartość" (--header) – wstrzyknięcie niestandardowego nagłówka (np. symulacja domeny: -H "Host: strona1.local" lub autoryzacji: -H "Authorization: Bearer xyz").
  • -k (--insecure) – pominięcie weryfikacji łańcucha certyfikatu TLS (dopuszczalne wyłącznie w laboratoryjnych testach certyfikatów self-signed).
  • -w format (--write-out) – ekstrakcja precyzyjnych metryk czasowych (DNS, connect, TLS, TTFB, total time).
curl -vL – narzędzie administratora: Slajd przedstawia zagadnienie Wszechstronne narzędzie diagnostyczne protokołu HTTP w ramach tematu curl -vL – narzędzie administratora na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
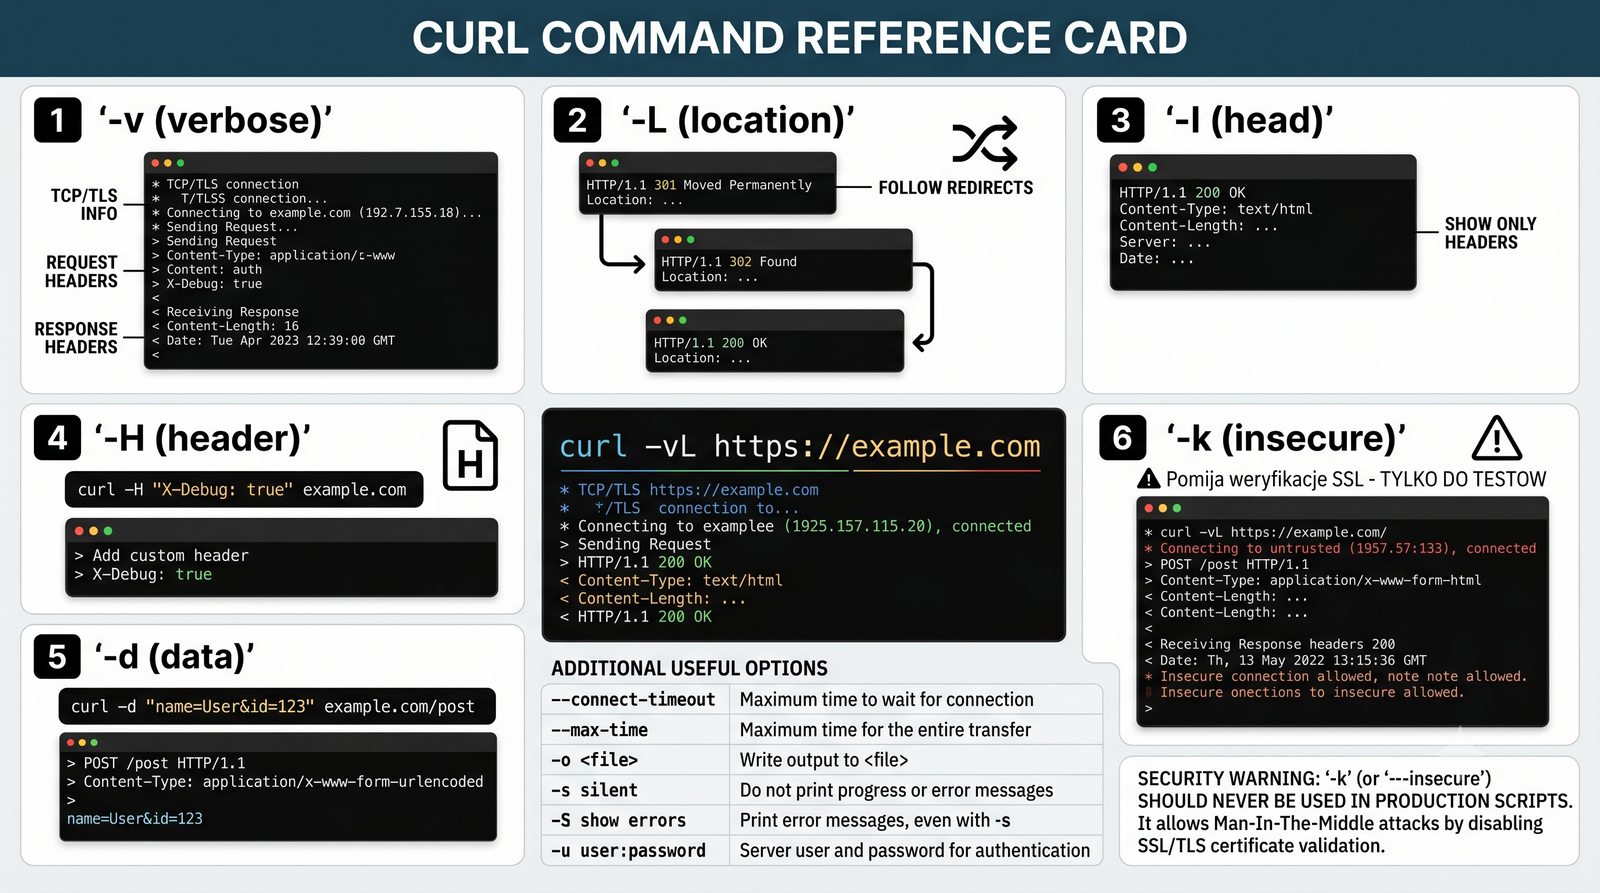
curl -vL
20/50
curl -vL w praktyce
Cel slajdu: Slajd omawia zagadnienie „curl -vL w praktyce” w kontekście: Szczegółowa analiza rzeczywistej komunikacji z serwerem.

Szczegółowa analiza rzeczywistej komunikacji z serwerem

Analiza sesji diagnostycznej polecenia curl -v -L http://example.com:

* Trying 93.184.215.14:80...
* Connected to example.com (93.184.215.14) port 80
> GET / HTTP/1.1
> Host: example.com
> User-Agent: curl/8.5.0
> Accept: */*
>
* Request completely sent off
< HTTP/1.1 200 OK
< Age: 521402
< Cache-Control: max-age=604800
< Content-Type: text/html; charset=UTF-8
< Date: Thu, 01 Oct 2026 12:00:00 GMT
< ETag: "3147526947"
< Expires: Thu, 08 Oct 2026 12:00:00 GMT
< Last-Modified: Thu, 17 Oct 2019 07:18:26 GMT
< Server: cloudflare (wartość zależy od operatora CDN; zweryfikuj poleceniem curl -sI http://example.com)
< Vary: Accept-Encoding
< Content-Length: 1256
<
[1256 bajtów treści HTML...]
* Connection #0 to host example.com left intact
  • * – zdarzenia systemowe: translacja DNS, otwarcie gniazda TCP, stan połączenia.
  • > – surowe nagłówki żądania klienta przekazane do gniazda.
  • < – surowe nagłówki odpowiedzi zwrócone przez serwer (kody statusu, polityka pamięci podręcznej, znaczniki walidacji ETag).
curl -vL w praktyce: Slajd przedstawia zagadnienie Szczegółowa analiza rzeczywistej komunikacji z serwerem w ramach tematu curl -vL w praktyce na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
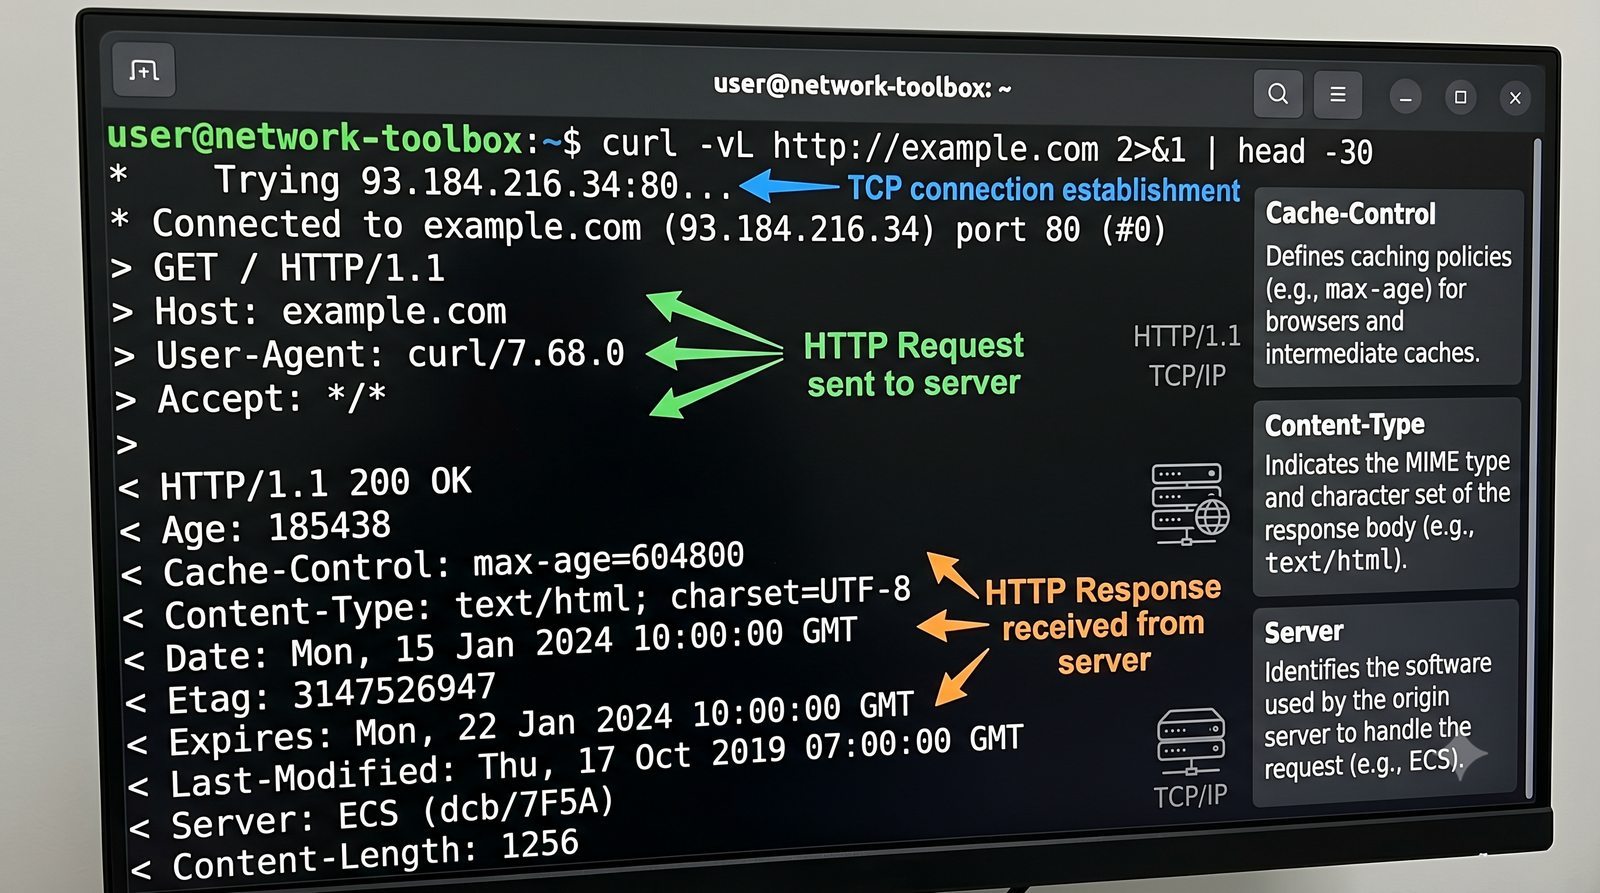
curl -vL praktyka
21/50
Apache HTTP Server – architektura
Cel slajdu: Slajd omawia zagadnienie „Apache HTTP Server – architektura” w kontekście: Modularna budowa i architektura dynamicznych modułów (DSO).

Modularna budowa i architektura dynamicznych modułów (DSO)

  • Rys historyczny i znaczenie: Apache HTTP Server (projekt httpd rozwijany przez Apache Software Foundation od 1995 roku) przez ponad dwie dekady stanowił dominującą platformę serwerową WWW na świecie.
  • Modularność DSO (Dynamic Shared Object): Rdzeń serwera (core) realizuje jedynie podstawowe operacje sieciowe, natomiast niemal cała funkcjonalność dostarczana jest w postaci dynamicznie ładowanych bibliotek współdzielonych (.so).
  • Kluczowe moduły produkcyjne:
    • mod_ssl – obsługa bezpiecznych połączeń TLS/HTTPS, weryfikacji certyfikatów i rozszerzenia SNI.
    • mod_rewrite – zaawansowany silnik manipulacji i przepisywania adresów URL w oparciu o wyrażenia regularne PCRE.
    • mod_proxy i mod_proxy_fcgi – funkcjonalność serwera pośredniczącego (reverse proxy) i integracji z procesami PHP-FPM.
    • mod_headers i mod_deflate / mod_brotli – manipulacja nagłówkami HTTP oraz kompresja strumienia wyjściowego.
  • Abstrakcja przetwarzania – MPM (Multi-Processing Module): Odizolowanie logiki serwera od specyfiki obsługi gniazd sieciowych i procesów systemu operacyjnego.
Apache HTTP Server – architektura: Slajd przedstawia zagadnienie Modularna budowa i architektura dynamicznych modułów (DSO) w ramach tematu Apache HTTP Server – architektura na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
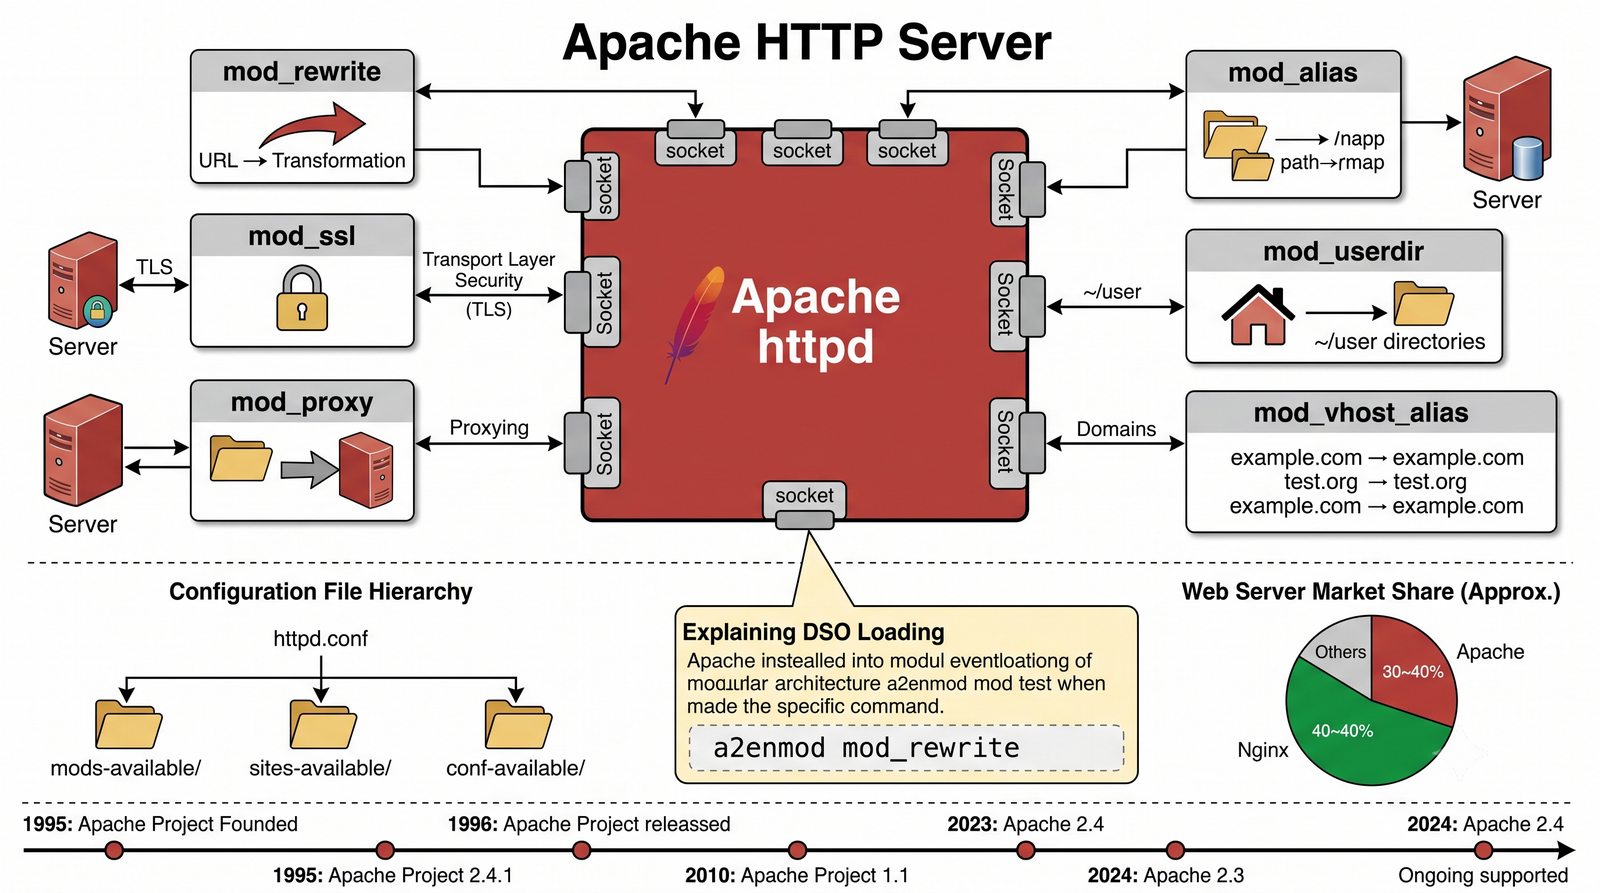
Apache architektura
22/50
Modele MPM w Apache (cz. 1)
Cel slajdu: Slajd omawia zagadnienie „Modele MPM w Apache (cz. 1)” w kontekście: Model procesowy MPM Prefork i zarządzanie pamięcią.

Model procesowy MPM Prefork i zarządzanie pamięcią

  • MPM Prefork (model procesowy bezwątkowy):
    • Najstarszy, klasyczny model przetwarzania w Apache; proces nadrzędny (działający jako root) tworzy z wyprzedzeniem pulę procesów potomnych (działających jako nieuprzywilejowany użytkownik www-data / apache).
    • Jedno połączenie = jeden dedykowany proces: Każde aktywne połączenie HTTP jest przypisane do odrębnego procesu systemu operacyjnego na cały czas jego trwania.
  • Zalety: Pełna izolacja pamięciowa (awaria lub błąd naruszenia ochrony pamięci w jednym procesie nie wpływa na pozostałe połączenia); pełna kompatybilność ze starymi bibliotekami zewnętrznymi, które nie są bezpieczne wątkowo (np. tradycyjny moduł mod_php).
  • Wady i ograniczenia: Ogromne zużycie pamięci operacyjnej RAM (każdy proces potomny alokuje odrębną przestrzeń adresową, często 20–50 MB na proces); wysoki narzut na przełączanie kontekstu procesora (context switching) przy dużej liczbie klientów.
  • Kluczowe dyrektywy regulacyjne: StartServers, MinSpareServers, MaxSpareServers, MaxRequestWorkers (limitująca maksymalną liczbę równoczesnych procesów) oraz MaxConnectionsPerChild.
Modele MPM w Apache: Slajd przedstawia zagadnienie Model procesowy MPM Prefork i zarządzanie pamięcią w ramach tematu Modele MPM w Apache (cz. 1) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
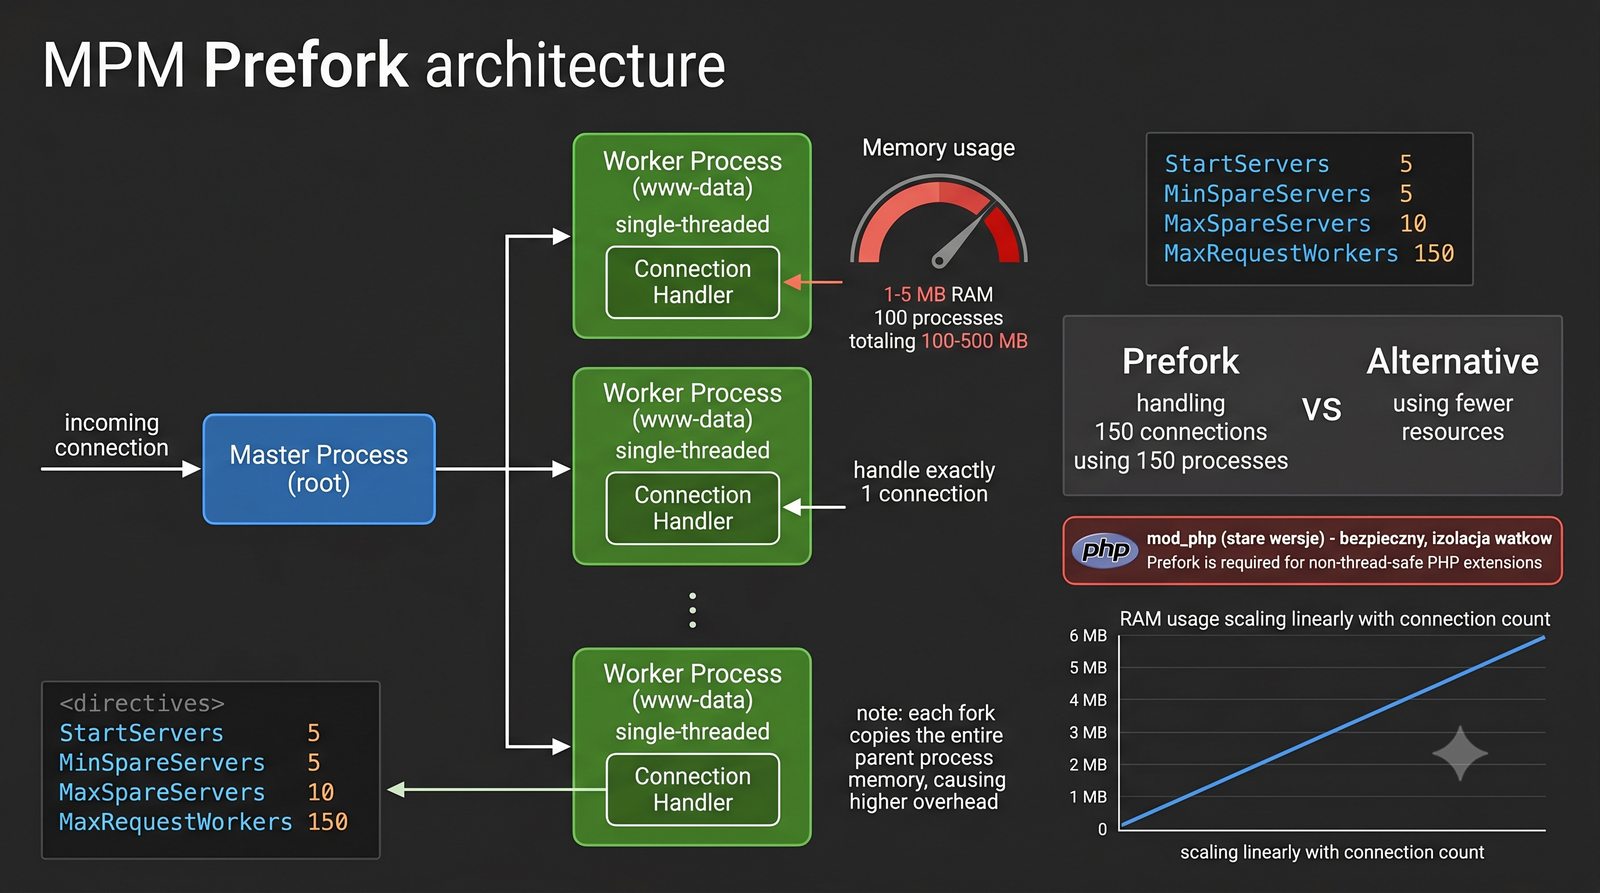
MPM Prefork
23/50
Modele MPM w Apache (cz. 2)
Cel slajdu: Slajd omawia zagadnienie „Modele MPM w Apache (cz. 2)” w kontekście: Wielowątkowość w MPM Worker i zdarzeniowy MPM Event.

Wielowątkowość w MPM Worker i zdarzeniowy MPM Event

  • MPM Worker (model procesowo-wątkowy):
    • Model hybrydowy: proces główny tworzy (metodą fork) ograniczoną liczbę procesów potomnych, z których każdy tworzy pulę wątków roboczych (dyrektywa ThreadsPerChild, np. 25 lub 64).
    • Wątki współdzielą tę samą przestrzeń adresową procesu, co radykalnie redukuje zużycie pamięci RAM w porównaniu z Prefork.
    • Wymaga modułów i bibliotek w pełni bezpiecznych wątkowo (thread-safe).
  • MPM Event (nowoczesny standard zdarzeniowy w Apache 2.4):
    • Ewolucja modelu Worker rozwiązująca problem blokowania zasobów przez trwałe połączenia Keep-Alive.
    • Dedykowany wątek nasłuchujący (Listener Thread): Wykorzystuje asynchroniczny mechanizm jądra (epoll w Linuksie), monitorując stan uśpionych połączeń Keep-Alive.
    • Gdy klient wyśle nowe żądanie, gniazdo jest natychmiast przekazywane do wolnego wątku roboczego. Po odesłaniu odpowiedzi wątek jest zwalniany, a połączenie wraca pod nadzór wątku nasłuchującego.
    • W połączeniu z PHP-FPM przez mod_proxy_fcgi stanowi rekomendowaną konfigurację produkcyjną Apache.
Modele MPM w Apache: Slajd przedstawia zagadnienie Wielowątkowość w MPM Worker i zdarzeniowy MPM Event w ramach tematu Modele MPM w Apache (cz. 2) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
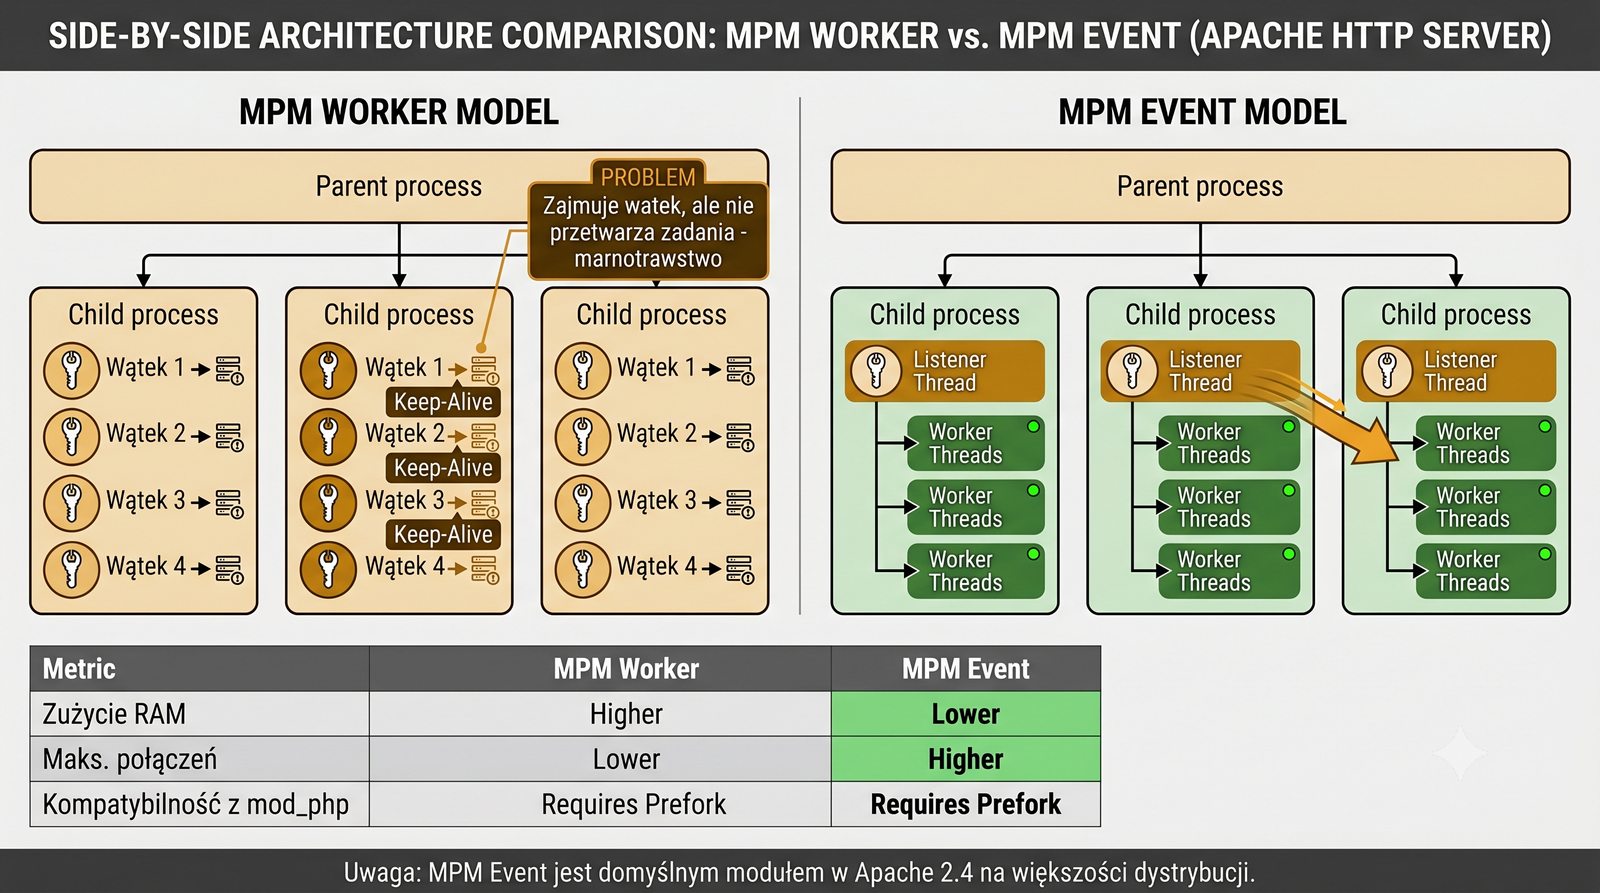
MPM Worker i Event
24/50
Konfiguracja Apache – pliki
Cel slajdu: Slajd omawia zagadnienie „Konfiguracja Apache – pliki” w kontekście: Hierarchia katalogów i plików konfiguracyjnych w systemie Linux.

Hierarchia katalogów i plików konfiguracyjnych w systemie Linux

  • Układ w dystrybucjach Debian / Ubuntu (katalog /etc/apache2/):
    • apache2.conf – główny plik konfiguracyjny definiujący architekturę procesu, limity MPM i dyrektywy IncludeOptional.
    • ports.conf – deklaracja nasłuchiwanych portów TCP (np. Listen 80, Listen 443).
    • envvars – zmienne środowiskowe dla procesu demona (np. APACHE_RUN_USER=www-data).
    • System dowiązań symbolicznych: *-available/ (zasoby dostępne) oraz *-enabled/ (zasoby aktywne).
    • Narzędzia administracyjne CLI: a2enmod / a2dismod (moduły), a2ensite / a2dissite (wirtualne hosty), a2enconf / a2disconf (konfiguracje pomocnicze).
  • Układ w dystrybucjach RHEL / CentOS / Rocky Linux (katalog /etc/httpd/):
    • conf/httpd.conf – jednolity, scentralizowany plik konfiguracyjny.
    • conf.d/*.conf – pliki konfiguracyjne wirtualnych hostów i usług pomocniczych włączane automatycznie dyrektywą Include.
    • conf.modules.d/*.conf – deklaracje ładowania modułów dynamicznych DSO.
  • Polecenia weryfikacji i przeładowania (po instalacji pakietu apache2): Sprawdzenie składni: apache2ctl configtest (lub httpd -t); przeładowanie bez przerywania sesji: systemctl reload apache2.
Konfiguracja Apache – pliki: Slajd przedstawia zagadnienie Hierarchia katalogów i plików konfiguracyjnych w systemie Linux w ramach tematu Konfiguracja Apache – pliki na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
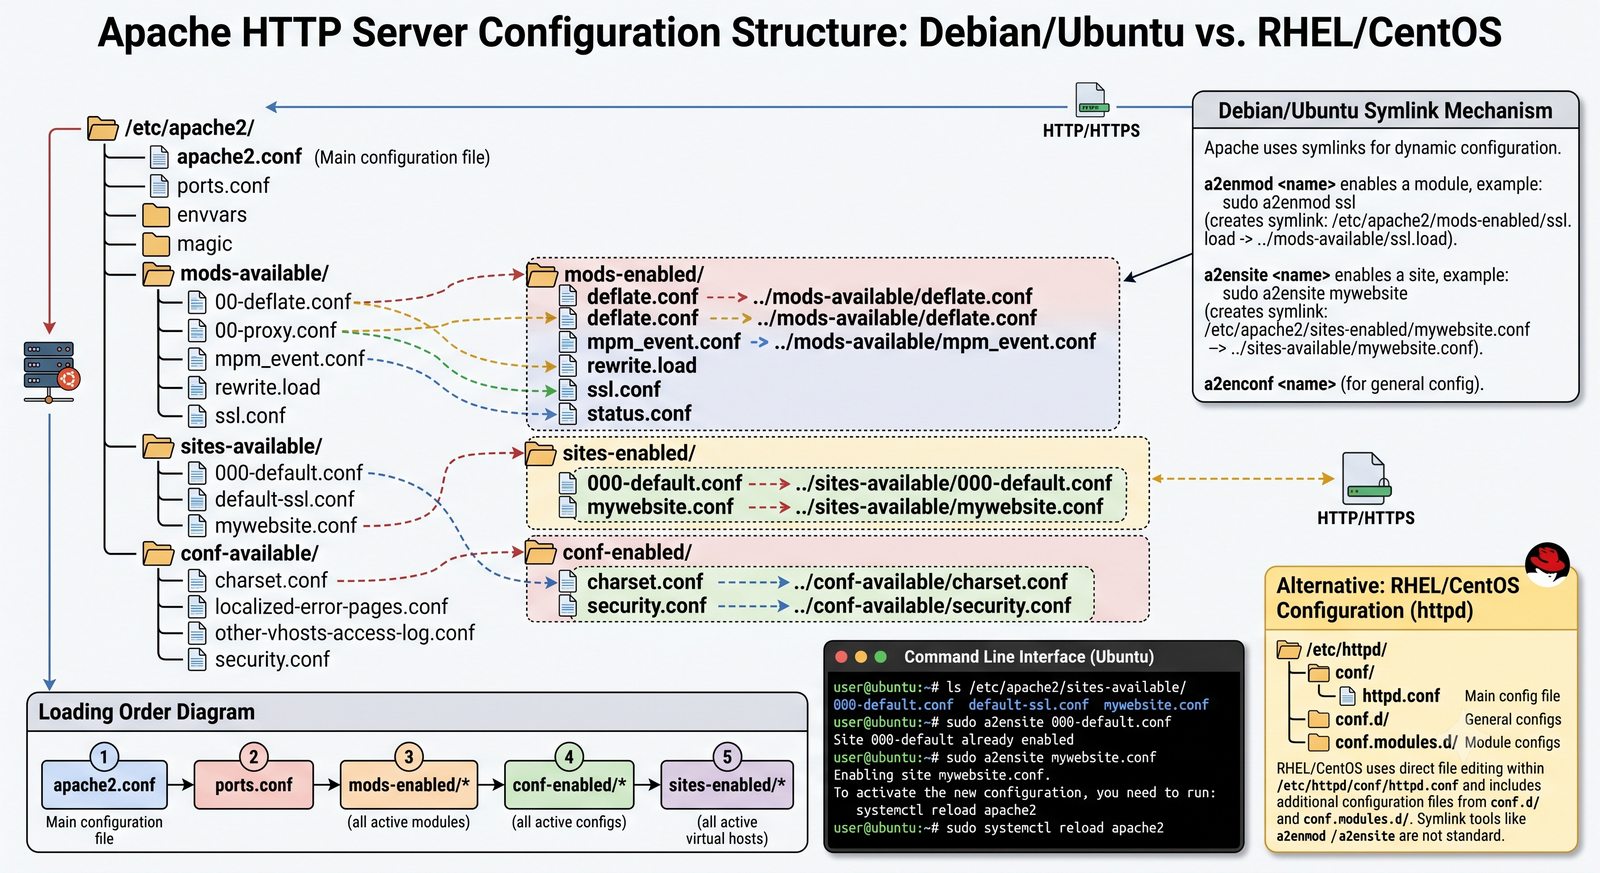
konfiguracja Apache
25/50
Apache VirtualHost – przykład
Cel slajdu: Slajd omawia zagadnienie „Apache VirtualHost – przykład” w kontekście: Definiowanie hosta wirtualnego w dyrektywach Apache.

Definiowanie hosta wirtualnego w dyrektywach Apache

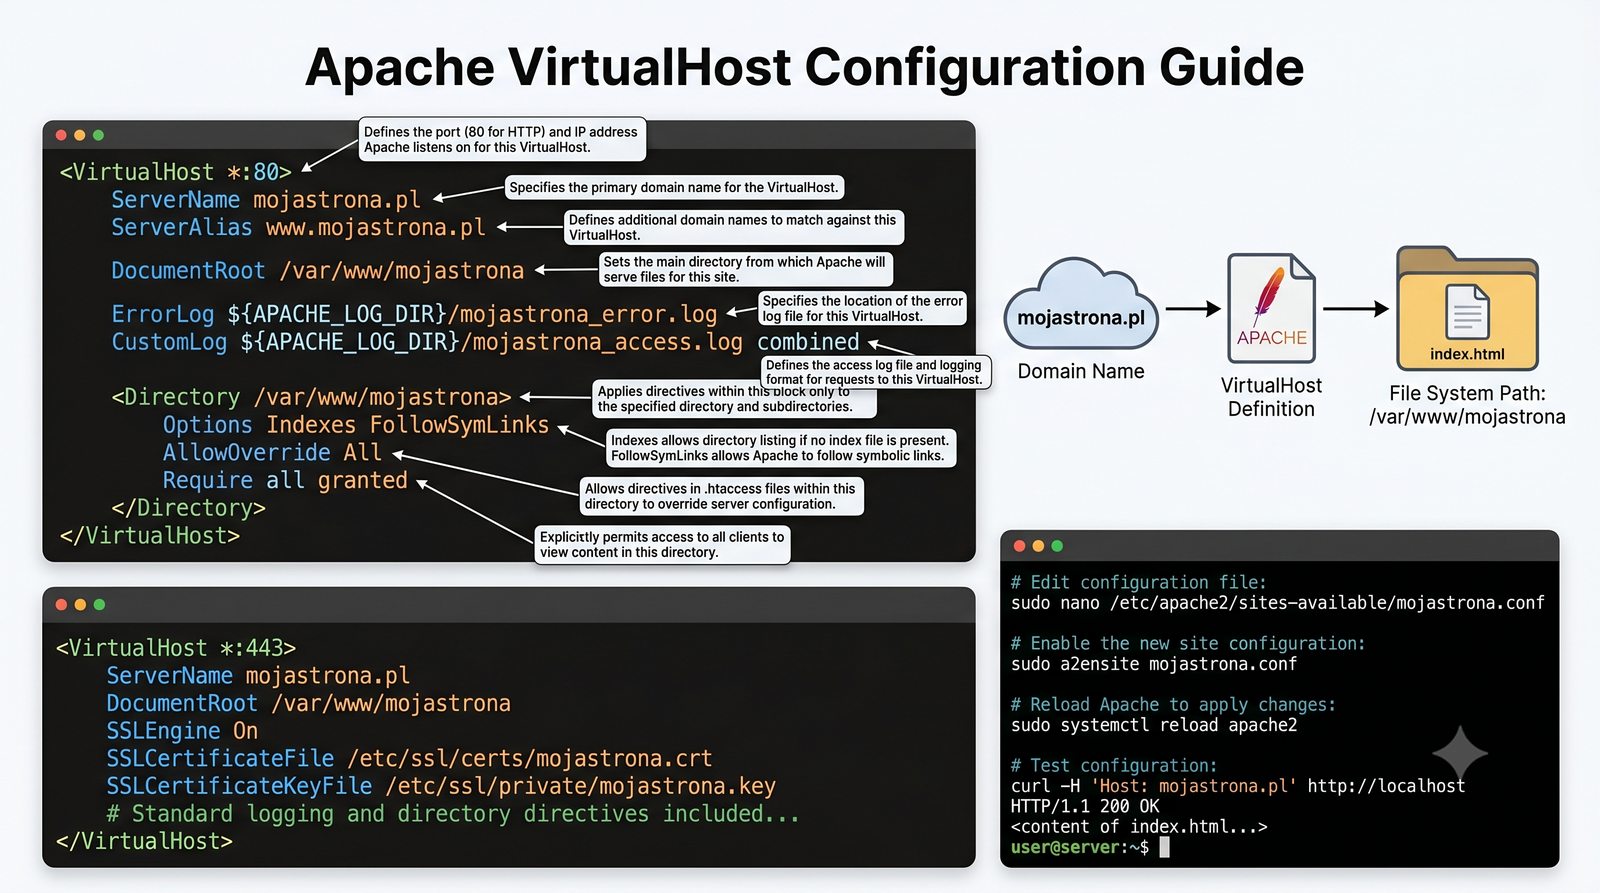
Przykładowy, produkcyjny plik konfiguracyjny hosta wirtualnego HTTP (port 80):

# /etc/apache2/sites-available/mojastrona.conf
<VirtualHost *:80>
    ServerName mojastrona.pl
    ServerAlias www.mojastrona.pl pomoc.mojastrona.pl
    ServerAdmin administrator@mojastrona.pl
    DocumentRoot /var/www/mojastrona/public_html

    ErrorLog ${APACHE_LOG_DIR}/mojastrona_error.log
    CustomLog ${APACHE_LOG_DIR}/mojastrona_access.log combined

    <Directory /var/www/mojastrona/public_html>
        Options -Indexes +FollowSymLinks
        AllowOverride None
        Require all granted
    </Directory>
</VirtualHost>
  • ServerName – kanoniczna domena hosta wirtualnego dopasowywana do nagłówka Host.
  • ServerAlias – alternatywne nazwy domenowe kierowane do tej samej konfiguracji.
  • DocumentRoot – pełna ścieżka w systemie plików serwera, gdzie znajdują się pliki witryny.
  • Directory – blok uprawnień: -Indexes blokuje listowanie katalogu, AllowOverride None wyłącza narzut plików .htaccess, Require all granted zezwala na dostęp.
Apache VirtualHost – przykład: Slajd przedstawia zagadnienie Definiowanie hosta wirtualnego w dyrektywach Apache w ramach tematu Apache VirtualHost – przykład na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
Apache VirtualHost
26/50
Nginx – architektura
Cel slajdu: Slajd omawia zagadnienie „Nginx – architektura” w kontekście: Wysoka wydajność dzięki nieblokującemu wejściu-wyjściu i pętli zdarzeń.

Wysoka wydajność dzięki nieblokującemu wejściu-wyjściu i pętli zdarzeń

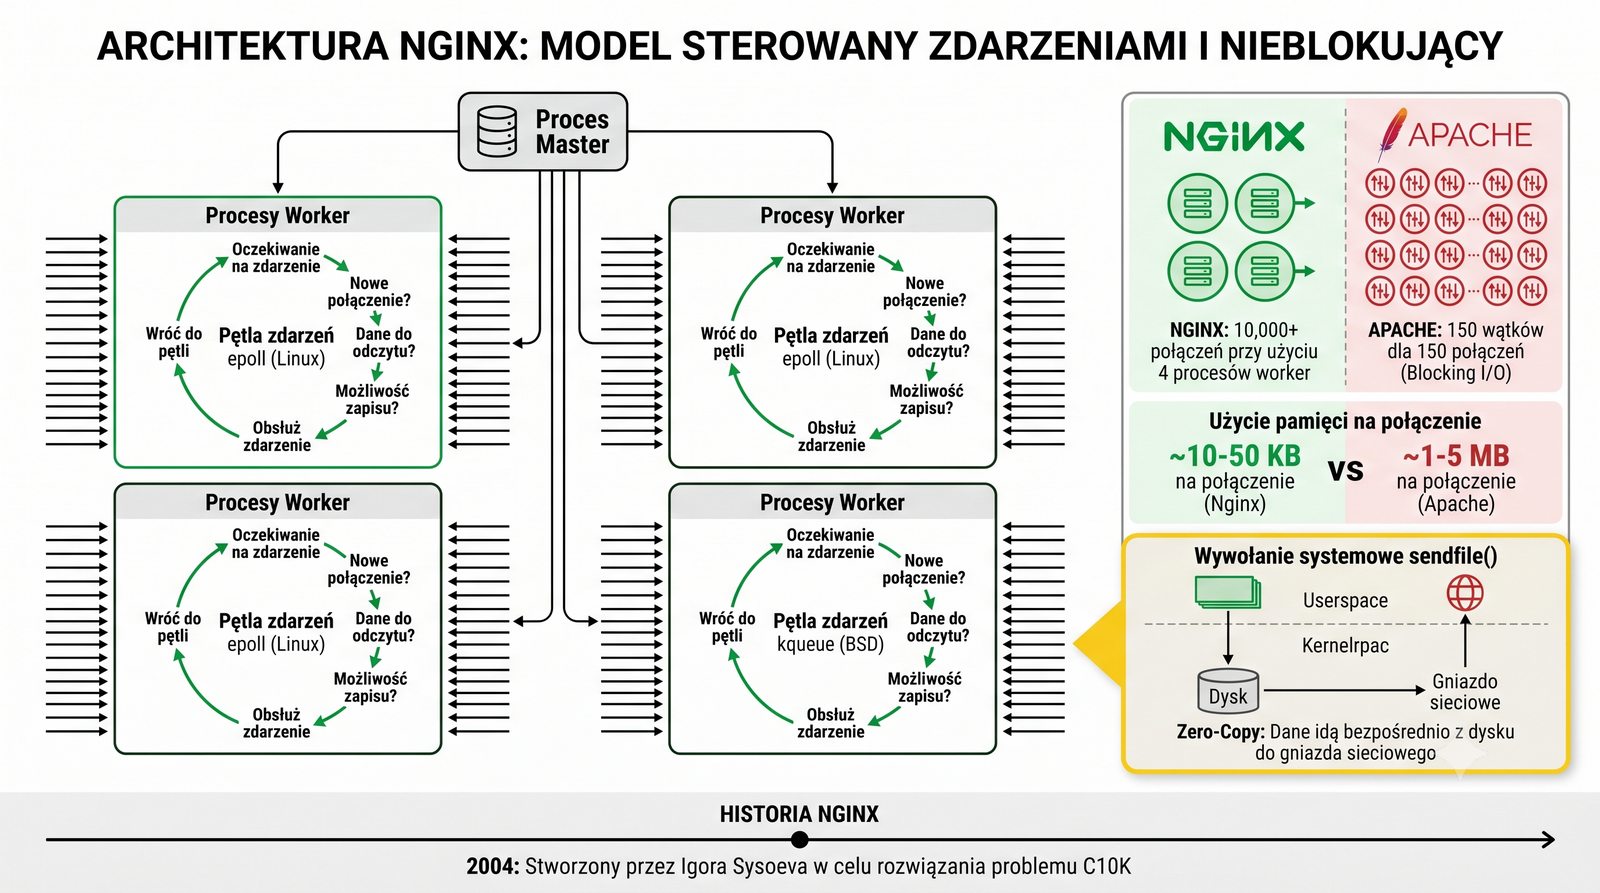
  • Geneza projektu (2002–2004): Serwer Nginx (wymawiany „engine-x”) został zaprojektowany przez Igora Sysoeva jako bezpośrednia odpowiedź na tzw. problem C10K – inżynierskie wyzwanie jednoczesnej obsługi ponad 10 000 równoległych połączeń na pojedynczym serwerze fizycznym.
  • Model asynchroniczny i sterowany zdarzeniami (Event-Driven): Nginx całkowicie odrzuca koncepcję tworzenia odrębnego wątku lub procesu dla każdego przychodzącego klienta na rzecz jednowątkowej pętli zdarzeń.
  • Architektura Master-Worker:
    • Proces Master (uprawnienia root): Odczytuje i waliduje pliki konfiguracyjne, zarządza portami uprzywilejowanymi (80/443), tworzy procesy robocze oraz nadzoruje ich cykl życia i bezprzerwowe przeładowywanie konfiguracji.
    • Procesy Worker (użytkownik nieuprzywilejowany nginx / www-data): W pełni autonomiczne procesy wykonawcze; każdy z nich obsługuje tysiące jednoczesnych połączeń za pomocą mechanizmów multiplexingu I/O: epoll (Linux), kqueue (FreeBSD/macOS).
  • Zasada „jeden proces roboczy na jeden rdzeń procesora”: Dyrektywa worker_processes auto; eliminuje straty wydajności związane z przełączaniem kontekstu w jednostce CPU.
Nginx – architektura: Slajd przedstawia zagadnienie Wysoka wydajność dzięki nieblokującemu wejściu-wyjściu i pętli zdarzeń w ramach tematu Nginx – architektura na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
Nginx architektura
27/50
Nginx – pętla zdarzeń (event loop)
Cel slajdu: Slajd omawia zagadnienie „Nginx – pętla zdarzeń (event loop)” w kontekście: Asynchroniczna obsługa tysięcy połączeń przez mechanizmy epoll/kqueue.

Asynchroniczna obsługa tysięcy połączeń przez mechanizmy epoll/kqueue

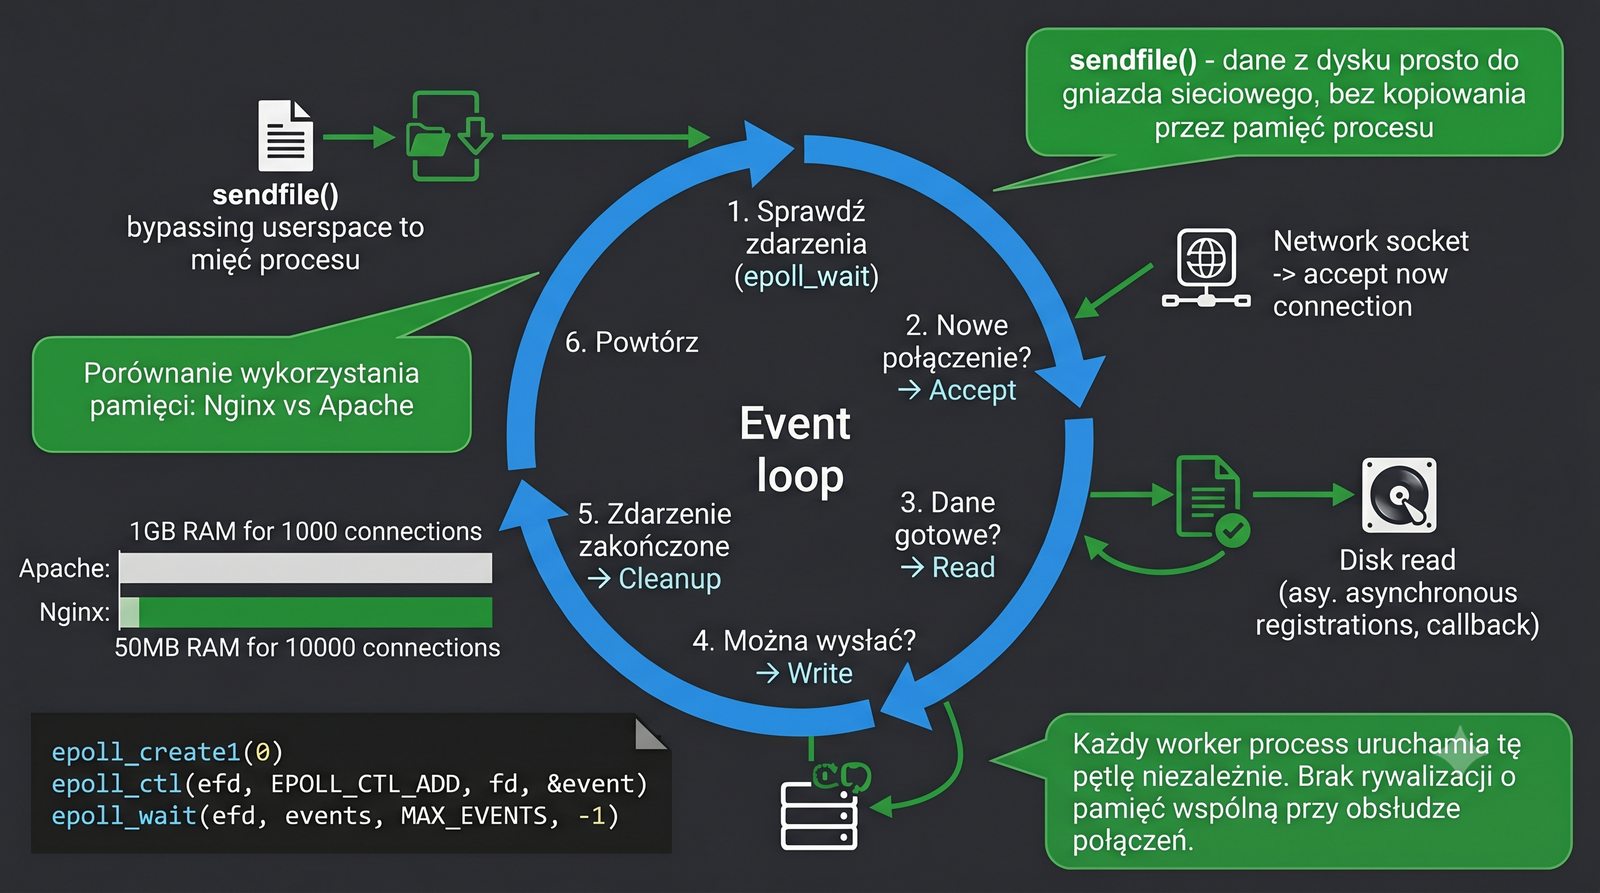
  • Działanie pętli zdarzeń (Event Loop): Pojedynczy proces roboczy Nginx wykonuje nieskończoną pętlę, odpytując jądro systemu operacyjnego o zarejestrowane zdarzenia na obserwowanych deskryptorach gniazd sieciowych.
  • Wywołania systemowe nowej generacji:
    • Linuksy wykorzystują mechanizm epoll o złożoności obliczeniowej O(1) (wywołanie epoll_wait() informuje wyłącznie o gniazdach, na których rzeczywiście pojawiły się dane, eliminując przeszukiwanie tysięcy nieaktywnych deskryptorów znane ze starszego select() o złożoności O(n)).
    • Systemy z rodziny BSD i macOS wykorzystują mechanizm kqueue.
  • Nieblokujące operacje I/O (Non-blocking Sockets): Odczyt i zapis z gniazda nigdy nie zatrzymują procesu – jeśli bufor jest pusty lub pełny, pętla natychmiast przechodzi do obsługi kolejnego klienta.
  • Transmisja bez kopiowania (Zero-Copy Streaming):
    • Wykorzystanie wywołania systemowego sendfile() – transfer plików statycznych z dysku do karty sieciowej odbywa się bezpośrednio w przestrzeni jądra (kernel space), z pominięciem bufora w przestrzeni użytkownika.
    • Dyrektywy tcp_nopush on; oraz tcp_nodelay on; optymalizują upakowanie pakietów TCP.
Nginx – pętla zdarzeń (ang. event loop): Slajd przedstawia zagadnienie Asynchroniczna obsługa tysięcy połączeń przez mechanizmy epoll/kqueue w ramach tematu Nginx – pętla zdarzeń (event loop) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
Event loop Nginx
28/50
Konfiguracja Nginx – pliki
Cel slajdu: Slajd omawia zagadnienie „Konfiguracja Nginx – pliki” w kontekście: Hierarchiczna budowa bloków konfiguracyjnych.

Hierarchiczna budowa bloków konfiguracyjnych

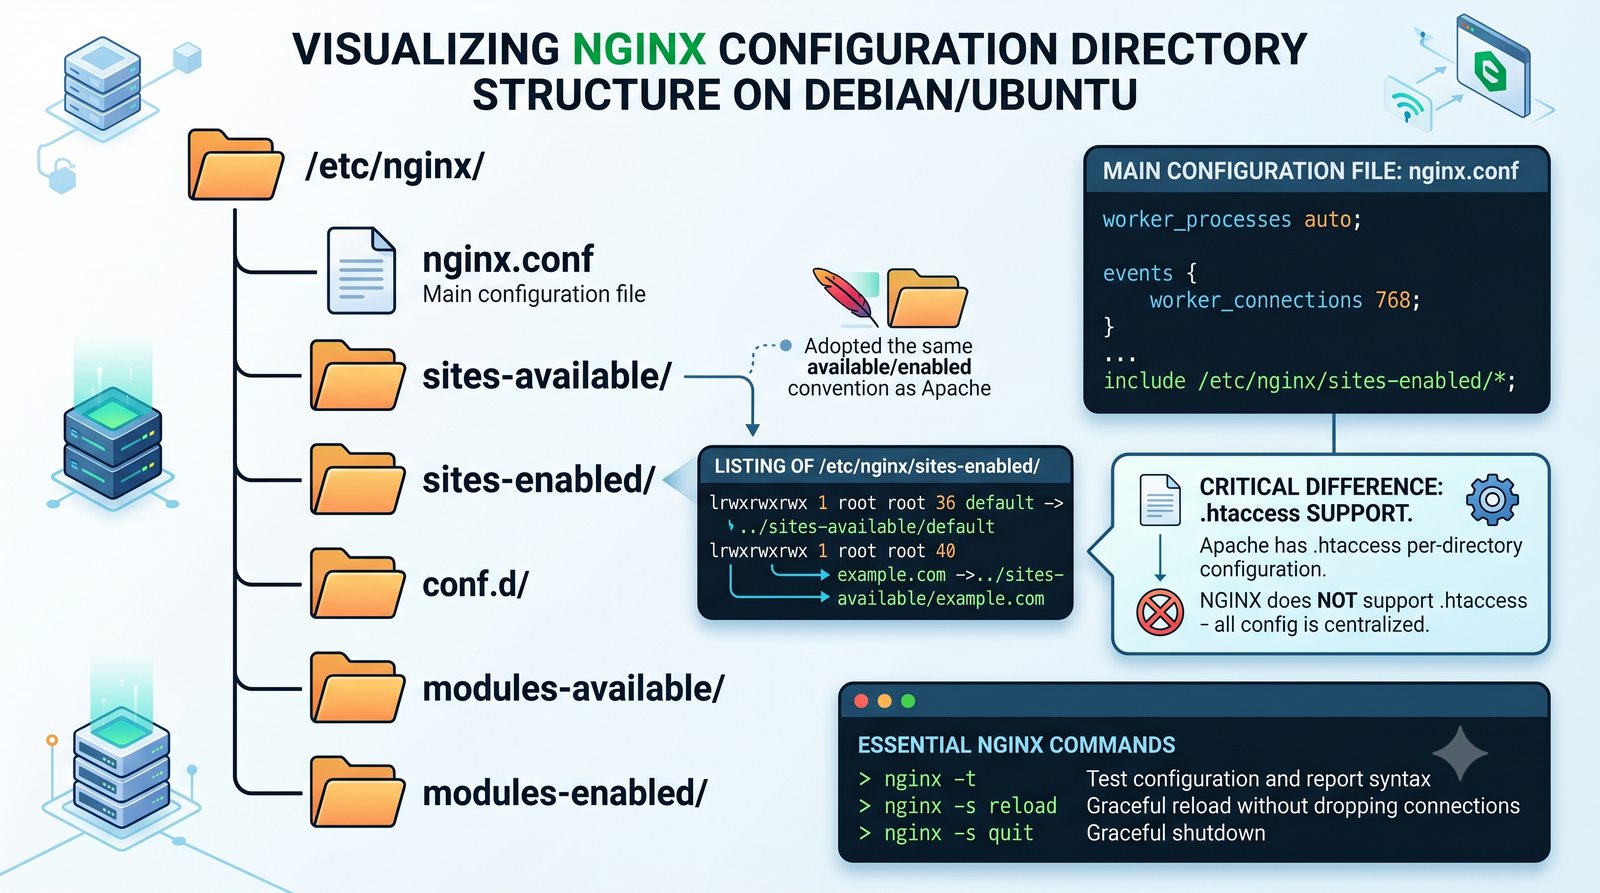
  • Główny plik konfiguracyjny: /etc/nginx/nginx.conf – definiuje kontekst globalny (main), procesy robocze, parametry pętli zdarzeń oraz główny blok http { ... }.
  • Hierarchia kontekstów konfiguracyjnych:
    • main (poza blokami) – dyrektywy globalne: user, worker_processes, pid, error_log.
    • events { ... } – parametry sieciowe: worker_connections 1024;, multi_accept on;.
    • http { ... } – parametry protokołu: obsługa typów MIME, buforowanie, formaty logów, kompresja gzip oraz dyrektywy include.
    • upstream { ... } – definicja puli serwerów backendowych (równoważenie obciążenia).
    • server { ... } – definicja wirtualnego hosta (odpowiednik VirtualHost w Apache).
    • location { ... } – reguły dopasowywania i obsługi konkretnych ścieżek URI.
  • Organizacja plików w systemie Linux: Katalogi /etc/nginx/sites-available/ oraz /etc/nginx/sites-enabled/ (w dystrybucjach Debian/Ubuntu) lub /etc/nginx/conf.d/*.conf (RHEL/CentOS).
  • Procedura weryfikacji i przeładowania (po instalacji pakietu nginx): Obowiązkowy test składni: nginx -t; bezprzerwowe przeładowanie konfiguracji sygnałem SIGHUP: systemctl reload nginx (lub nginx -s reload).
Konfiguracja Nginx – pliki: Slajd przedstawia zagadnienie Hierarchiczna budowa bloków konfiguracyjnych w ramach tematu Konfiguracja Nginx – pliki na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
konfiguracja Nginx
29/50
Nginx server block – przykład
Cel slajdu: Slajd omawia zagadnienie „Nginx server block – przykład” w kontekście: Blok server z dyrektywą server_name i obsługą try_files.

Blok server z dyrektywą server_name i obsługą try_files

Wzorcowy plik konfiguracyjny wirtualnego hosta w serwerze Nginx:

# /etc/nginx/sites-available/mojastrona.conf
server {
    listen 80;
    listen [::]:80;
    server_name mojastrona.pl www.mojastrona.pl;

    root /var/www/mojastrona/public_html;
    index index.html index.htm;

    access_log /var/log/nginx/mojastrona_access.log;
    error_log /var/log/nginx/mojastrona_error.log warn;

    location / {
        try_files $uri $uri/ =404;
    }

    # Blokada dostępu do ukrytych plików (.git, .env)
    location ~ /\. {
        deny all;
        access_log off;
        log_not_found off;
    }
}
  • listen 80 / listen [::]:80 – nasłuchiwanie na porcie 80 w protokołach IPv4 i IPv6.
  • server_name – domeny dopasowywane do nagłówka żądania Host.
  • try_files $uri $uri/ =404; – sekwencyjna próba odnalezienia dokładnego pliku, katalogu, a w przypadku braku zwrot kodu 404.
Nginx server block – przykład: Slajd przedstawia zagadnienie Blok server z dyrektywą server_name i obsługą try_files w ramach tematu Nginx server block – przykład na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
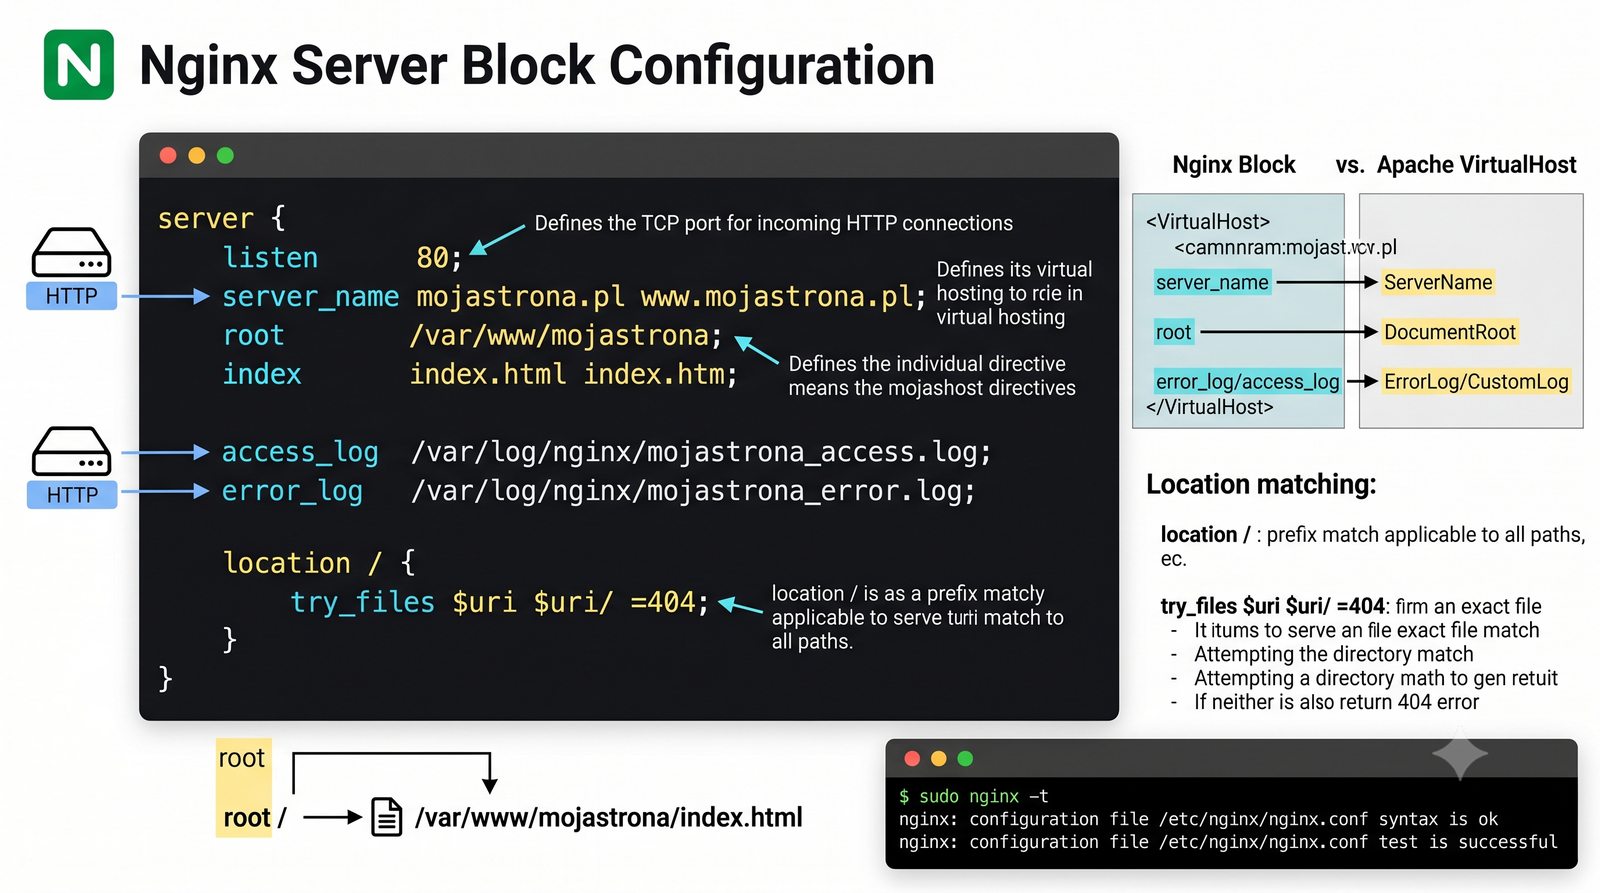
Nginx server block
30/50
Apache vs Nginx – porównanie
Cel slajdu: Slajd omawia zagadnienie „Apache vs Nginx – porównanie” w kontekście: Różnice architektoniczne, profile wydajnościowe i integracja.

Różnice architektoniczne, profile wydajnościowe i integracja

Kryterium oceny Apache HTTP Server (MPM Event) Nginx (Event-Driven)
Model architektury Hybrydowy: procesy + pula wątków + pętla Keep-Alive Czysto asynchroniczna, jednowątkowa pętla zdarzeń
Zużycie RAM na połączenie Średnie (~0.5–2 MB w Worker/Event, ~30 MB w Prefork) Ekstremalnie niskie (~10–50 KB na aktywne gniazdo)
Równoczesne połączenia Rząd wielkości: 1 000 – 10 000 Rząd wielkości: 100 000+ (rozwiązanie C10K)
Serwowanie plików statycznych Bardzo dobre (obsługa sendfile) Niedoścignione (zerowe kopiowanie, minimalny narzut)
Konfiguracja lokalna Pliki .htaccess w katalogach (elastyczność kosztem I/O) Wyłącznie pliki centralne (maksymalna wydajność)
Przetwarzanie PHP mod_proxy_fcgi (PHP-FPM) lub mod_php (tylko Prefork) Wyłącznie zewnętrzne przez FastCGI (PHP-FPM)
Apache vs Nginx – porównanie: Slajd przedstawia zagadnienie Różnice architektoniczne, profile wydajnościowe i integracja w ramach tematu Apache vs Nginx – porównanie na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
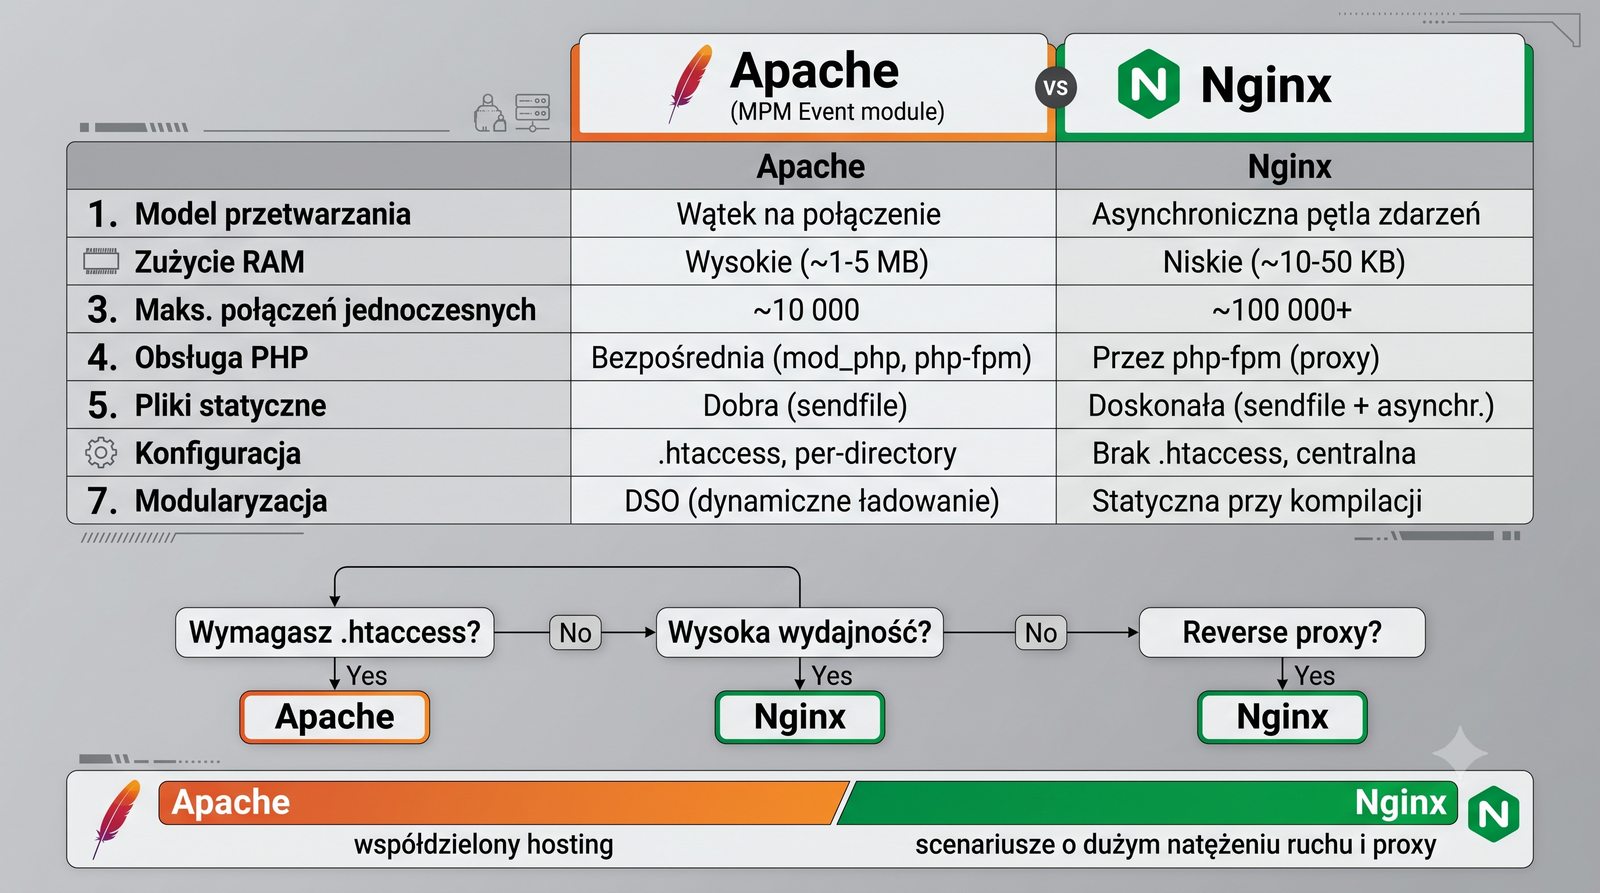
Apache vs Nginx
31/50
Wirtualne hosty – koncepcja
Cel slajdu: Slajd omawia zagadnienie „Wirtualne hosty – koncepcja” w kontekście: Name-based, IP-based i port-based hosting.

Name-based, IP-based i port-based hosting

Technologia wirtualnego hostingu (Virtual Hosting) umożliwia uruchomienie i jednoczesną obsługę setek lub tysięcy niezależnych witryn internetowych na pojedynczej fizycznej lub wirtualnej instancji serwera WWW:

  • Name-based Virtual Hosting (hosting oparty na nazwie):
    • Najbardziej powszechny model hostingowy na świecie. Wiele domen współdzieli dokładnie ten sam adres IP i port (np. port 80 lub 443).
    • Rozróżnienie witryny następuje w warstwie aplikacji na podstawie nagłówka Host protokołu HTTP oraz rozszerzenia SNI (RFC 6066) w protokole TLS.
  • IP-based Virtual Hosting (hosting oparty na adresie IP):
    • Każda domena posiada przypisany unikalny, dedykowany adres IP (na osobnym interfejsie fizycznym lub aliasie logicznym).
    • Serwer określa docelową witrynę już na etapie zestawiania gniazda TCP przez jądro systemu operacyjnego.
  • Port-based Virtual Hosting (hosting oparty na porcie):
    • Poszczególne usługi działają na niestandardowych portach TCP tego samego adresu IP (np. http://serwer.pl:8080, http://serwer.pl:8443). Typowe dla paneli zarządzania i środowisk testowych.
Wirtualne hosty – koncepcja: Slajd przedstawia zagadnienie Name-based, IP-based i port-based hosting w ramach tematu Wirtualne hosty – koncepcja na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
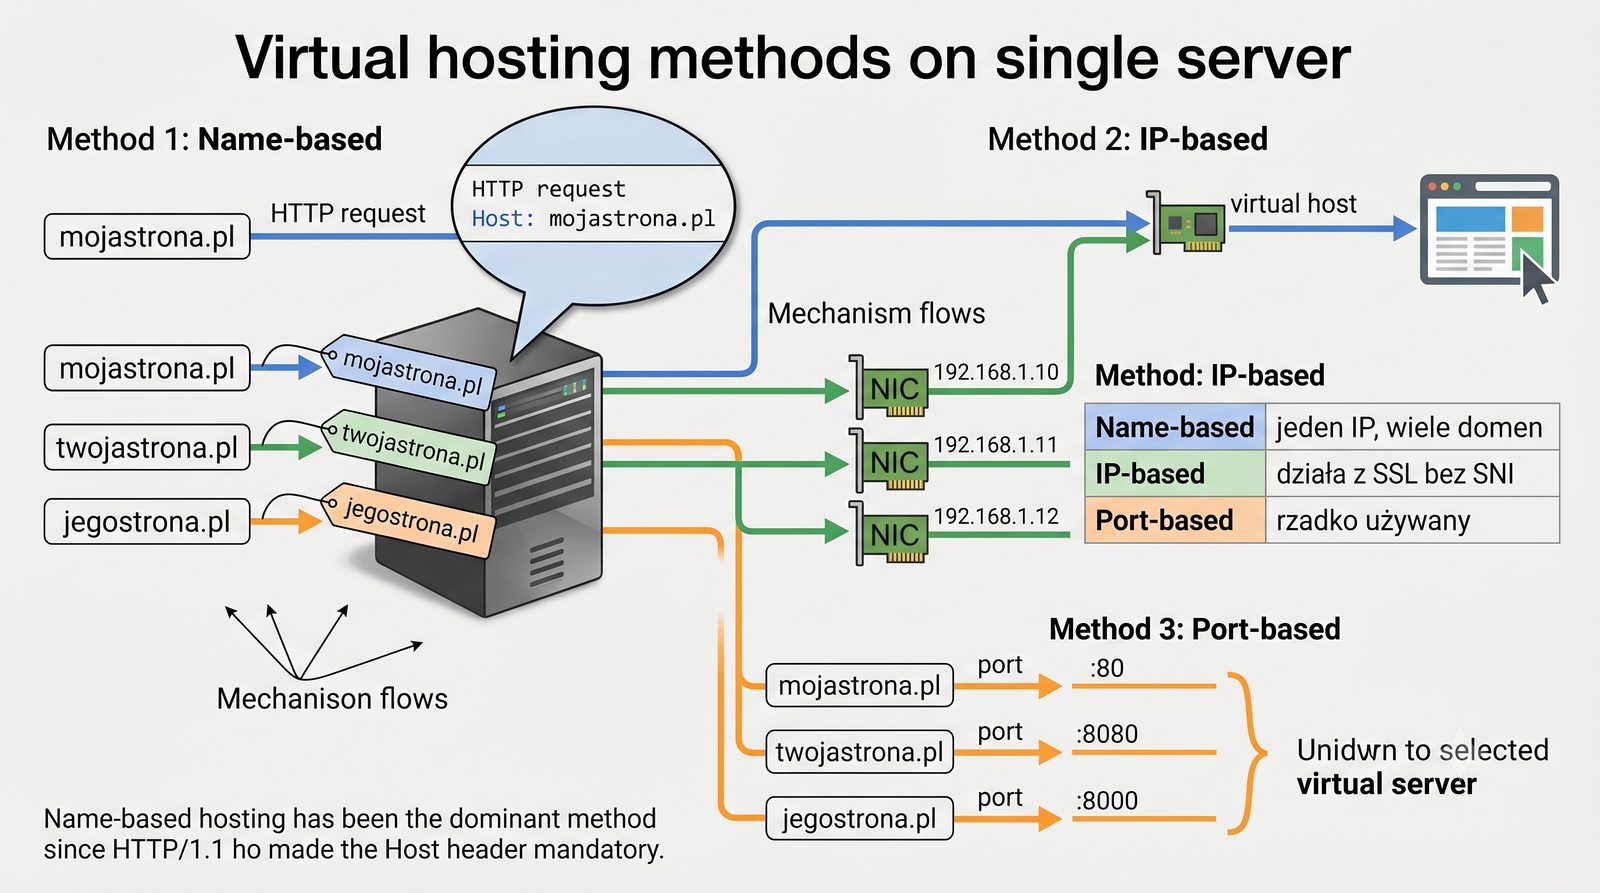
Virtual hosting concept
32/50
Name-based vs IP-based virtual hosting
Cel slajdu: Slajd omawia zagadnienie „Name-based vs IP-based virtual hosting” w kontekście: Nagłówek Host, Server Name Indication a dedykowany adres IP.

Nagłówek Host, Server Name Indication a dedykowany adres IP

Cecha techniczna Name-based (oparty na nazwie) IP-based (oparty na IP)
Nagłówek HTTP Host Obowiązkowo wymagany (RFC 9112) Opcjonalny (wystarcza adres IP gniazda)
Zapotrzebowanie na IP Minimalne (jeden IP dla setek domen) Wysokie (dokładnie 1 adres IP na każdą domenę)
Szyfrowanie TLS/HTTPS Wymaga rozszerzenia SNI (RFC 6066) Działa w pełni bez SNI (starsze systemy embedded)
Ekonomika wdrożenia Bardzo niska (eksploatacja 1 adresu IPv4) Wysoka (koszt zakupu/dzierżawy pul IPv4)
Filtrowanie firewall / QoS Wspólne dla wszystkich witryn Możliwe dedykowane reguły iptables/nftables per IP
Zastosowanie w IPv6 Powszechne Brak barier adresowych (pule /64 na serwer)
Name-based vs IP-based virtual hosting: Slajd przedstawia zagadnienie Nagłówek Host, Server Name Indication a dedykowany adres IP w ramach tematu Name-based vs IP-based virtual hosting na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
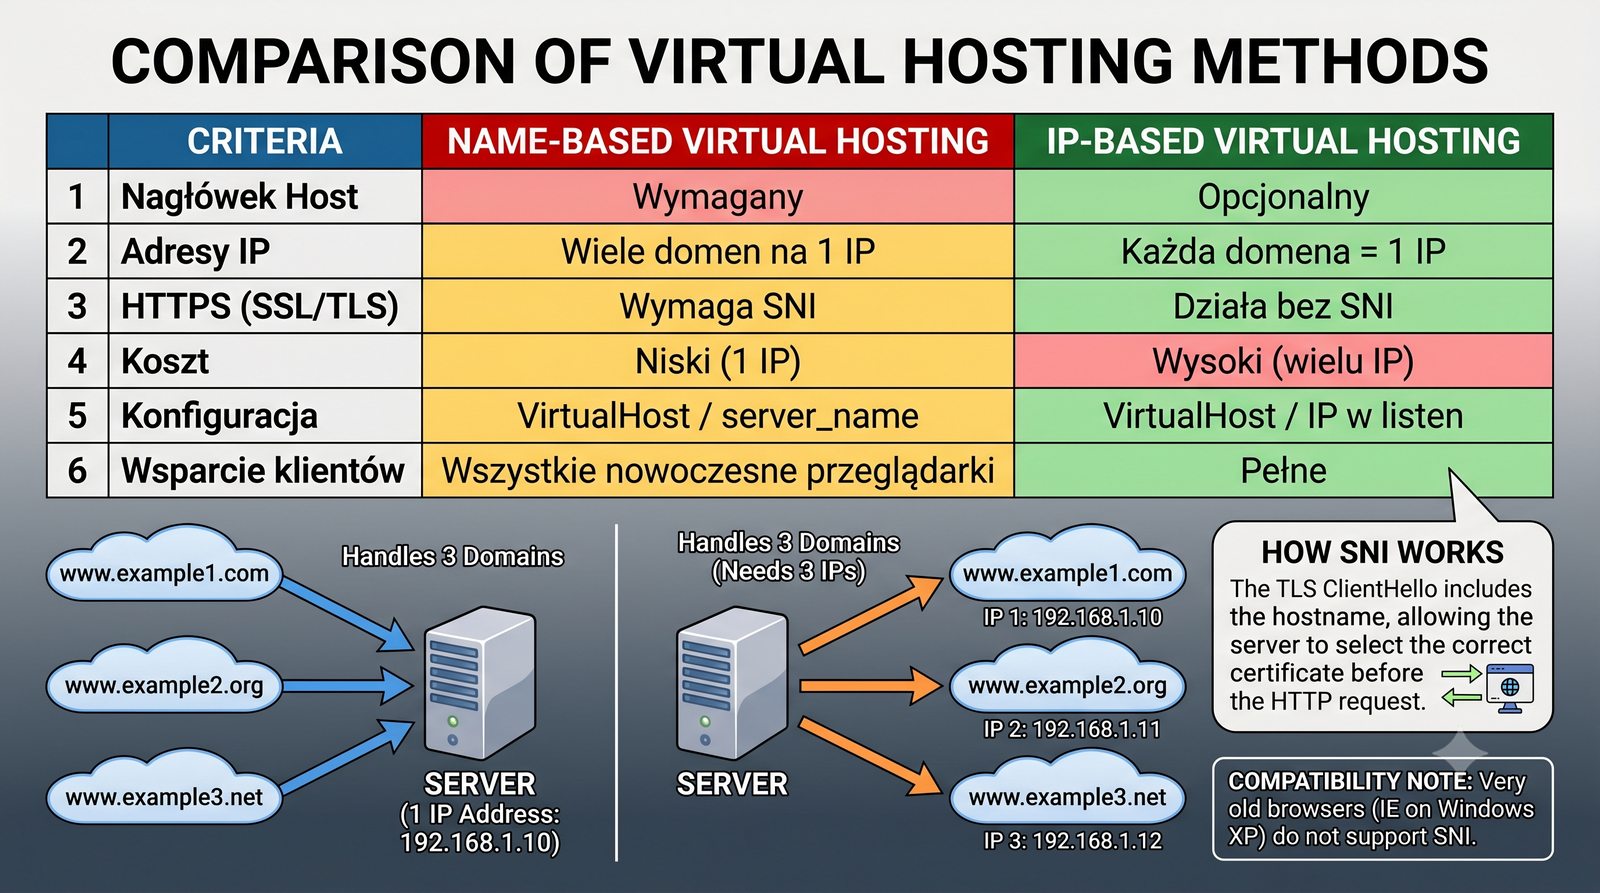
Name-based vs IP-based
33/50
Wirtualne hosty w Apache (szczegóły)
Cel slajdu: Slajd omawia zagadnienie „Wirtualne hosty w Apache (szczegóły)” w kontekście: Konfiguracja VirtualHost, domyślny host i certyfikaty SSL/TLS.

Konfiguracja VirtualHost, domyślny host i certyfikaty SSL/TLS

  • Ewolucja Apache 2.4: Dyrektywa NameVirtualHost (obowiązkowa w Apache 2.2) w wersji 2.4 jest przestarzała i ignorowana – każdy blok <VirtualHost interfejs:port> automatycznie działa w trybie dopasowywania po nazwie.
  • Zasada domyślnego wirtualnego hosta (Default / Fallback Host):
    • Pierwszy wczytany plik konfiguracyjny VirtualHost dla danej kombinacji IP:port staje się hostem domyślnym.
    • Obsługuje wszystkie żądania bez pasującego nagłówka Host (np. bezpośrednie wejścia po adresie IP). W Debianie rolę tę pełni plik 000-default.conf.
  • Konfiguracja HTTPS na porcie 443 (RFC 8446 TLS 1.3):
    <VirtualHost *:443>
        ServerName mojastrona.pl
        DocumentRoot /var/www/mojastrona/public_html
        SSLEngine on
        SSLCertificateFile /etc/ssl/certs/mojastrona_fullchain.pem
        SSLCertificateKeyFile /etc/ssl/private/mojastrona_privkey.pem
        SSLProtocol all -SSLv3 -TLSv1 -TLSv1.1
    </VirtualHost>
  • Inspekcja hierarchii hostów w konsoli: Polecenie apache2ctl -S wyświetla pełne drzewo sparsowanych wirtualnych hostów, ich porty, nazwy i pliki źródłowe.
Wirtualne hosty w Apache (szczegóły): Slajd przedstawia zagadnienie Konfiguracja VirtualHost, domyślny host i certyfikaty SSL/TLS w ramach tematu Wirtualne hosty w Apache (szczegóły) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
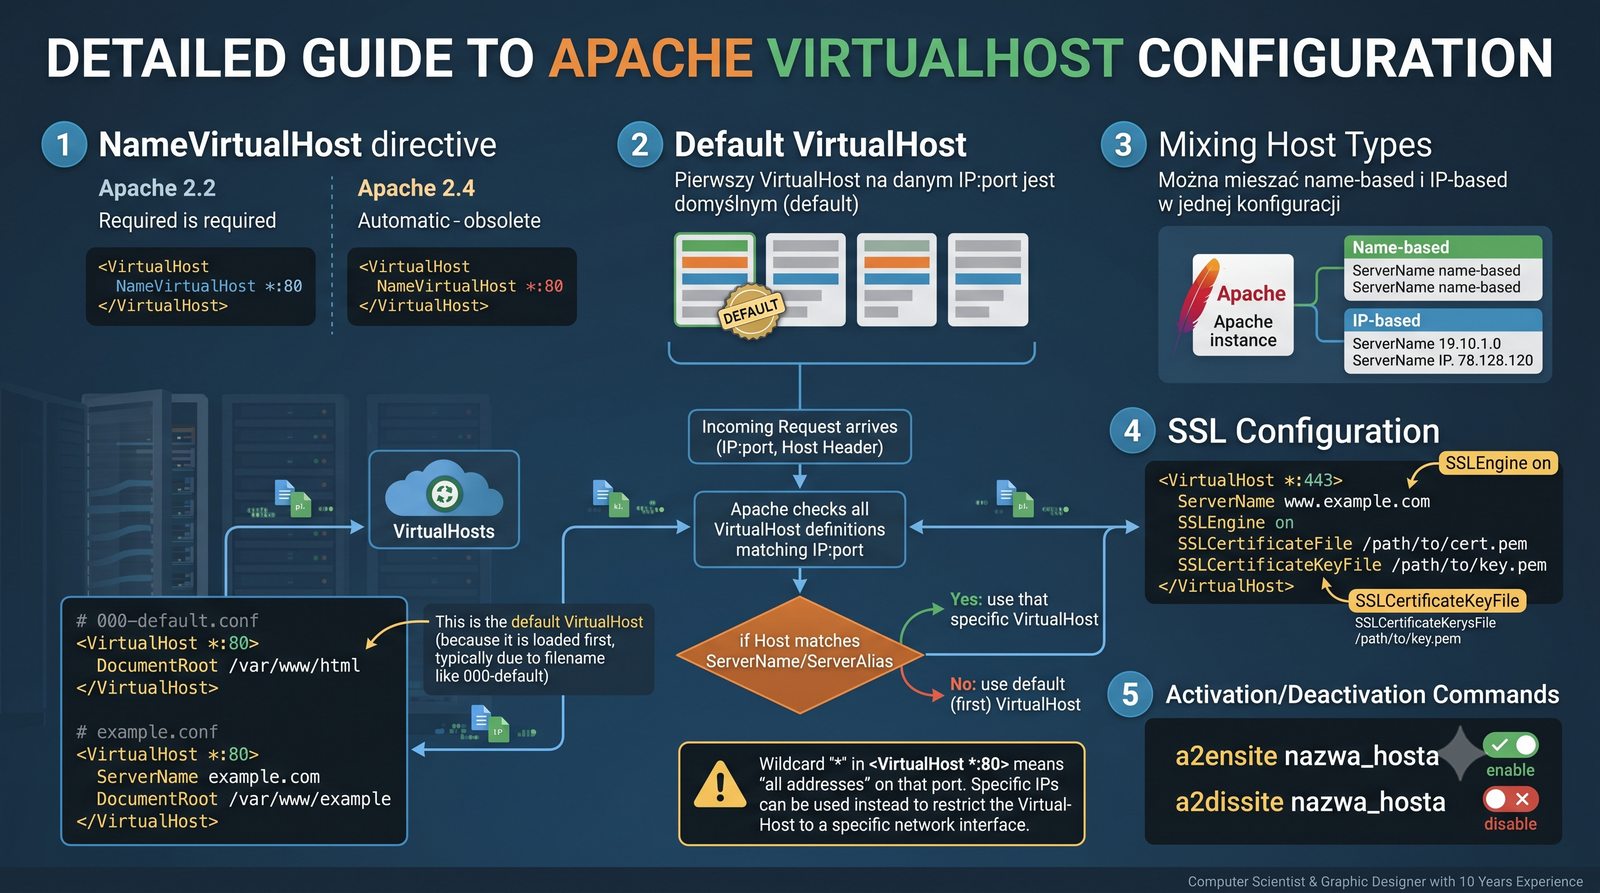
Apache VirtualHost szczegóły
34/50
Wirtualne hosty w Nginx (szczegóły)
Cel slajdu: Slajd omawia zagadnienie „Wirtualne hosty w Nginx (szczegóły)” w kontekście: Dopasowywanie domen w dyrektywie server_name i blok default_server.

Dopasowywanie domen w dyrektywie server_name i blok default_server

W serwerze Nginx sercem wirtualnego hostingu jest dyrektywa server_name w bloku server { ... }. Algorytm weryfikacji domeny realizowany jest w 4 ściśle określonych krokach priorytetu:

  1. Dokładne dopasowanie nazwy (Exact Name): np. server_name example.com www.example.com; (najwyższy priorytet).
  2. Najdłuższa nazwa z gwiazdką na początku (Wildcard Prefix): np. server_name *.example.com;.
  3. Najdłuższa nazwa z gwiazdką na końcu (Wildcard Suffix): np. server_name mail.*;.
  4. Wyrażenia regularne (Regular Expressions): oznaczone tyldą ~, np. server_name ~^(?<subdomena>.+)\.domena\.pl$; (przetwarzane w kolejności zdefiniowania w plikach).
  • Jawna deklaracja hosta domyślnego: Flaga default_server w dyrektywie listen 80 default_server;.
  • Zrzucanie nieautoryzowanych połączeń (ochrona zasobów):
    server {
        listen 80 default_server;
        listen 443 ssl default_server;
        server_name _;
        ssl_certificate /etc/ssl/certs/dummy.crt;
        ssl_certificate_key /etc/ssl/private/dummy.key;
        return 444; # Nierozpoznany host – natychmiastowe zamknięcie gniazda TCP
    }
Wirtualne hosty w Nginx (szczegóły): Slajd przedstawia zagadnienie Dopasowywanie domen w dyrektywie server_name i blok default_server w ramach tematu Wirtualne hosty w Nginx (szczegóły) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
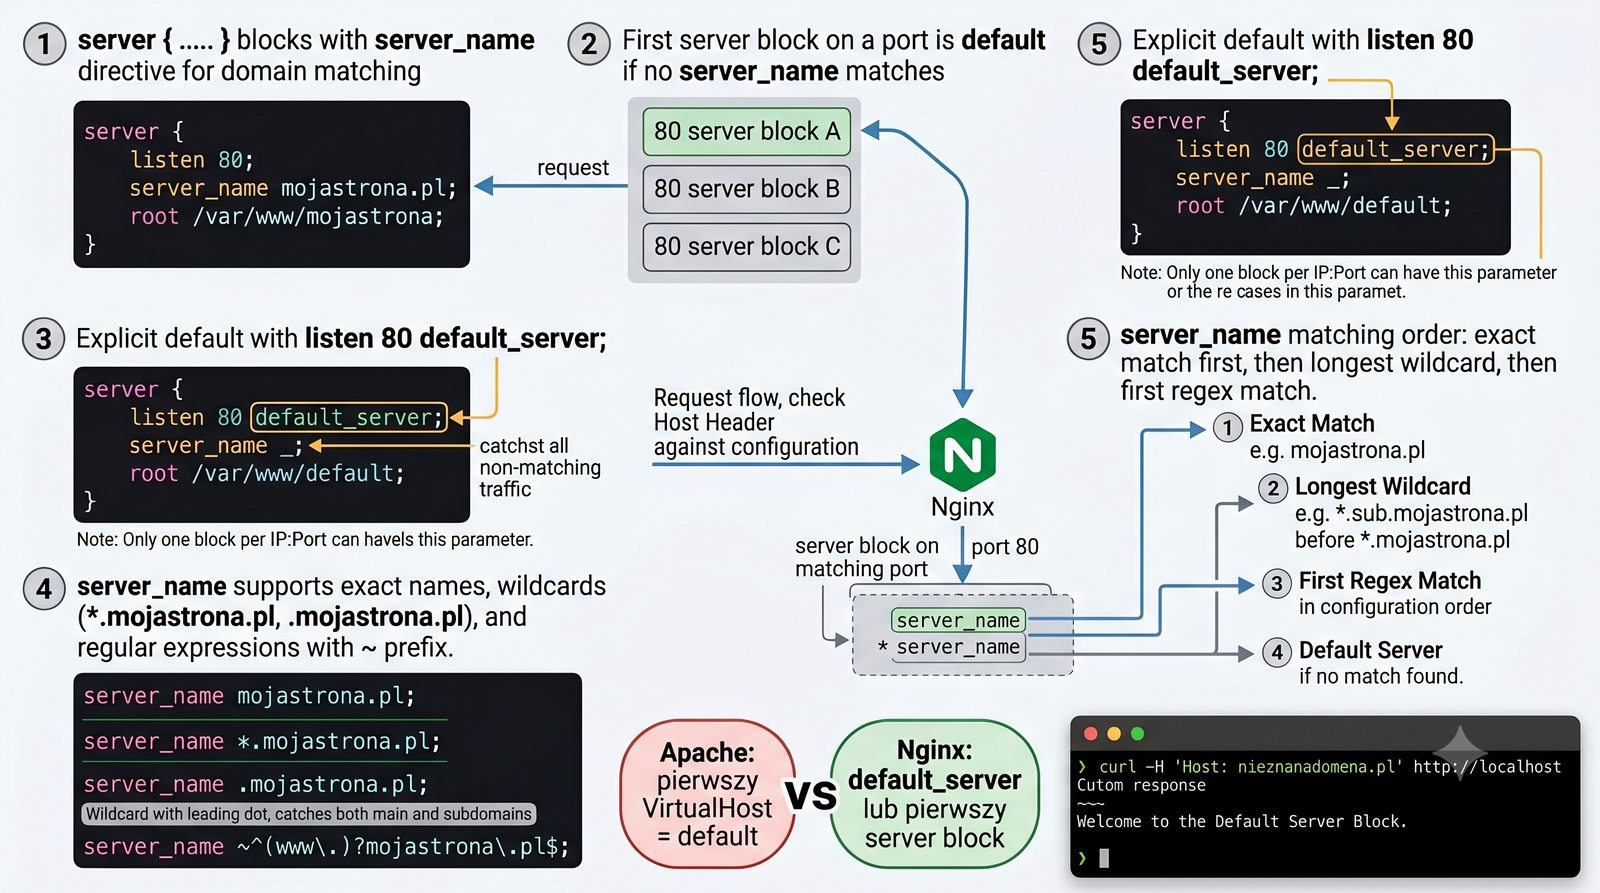
Nginx server_name
35/50
Aliasy interfejsów sieciowych
Cel slajdu: Slajd omawia zagadnienie „Aliasy interfejsów sieciowych” w kontekście: Konfiguracja wielu adresów IP na jednym interfejsie w systemie Linux.

Konfiguracja wielu adresów IP na jednym interfejsie w systemie Linux

Do realizacji wirtualnego hostingu opartego na adresacji IP (IP-based Virtual Hosting) oraz testowania izolacji usług sieciowych niezbędne jest przypisanie wielu adresów IP do pojedynczej fizycznej karty sieciowej:

  • Nowoczesny standard iproute2 (polecenie ip):
    # Dodanie dodatkowego adresu IP (aliasu logicznego)
    sudo ip addr add 192.168.1.10/24 dev enp0s3
    
    # Weryfikacja aktywnych adresów interfejsu (nazwę sprawdź poleceniem ip link)
    ip -brief addr show dev enp0s3
    # enp0s3 UP 192.168.1.5/24 192.168.1.10/24 fe80::.../64
    
    # Usunięcie adresu pomocniczego
    sudo ip addr del 192.168.1.10/24 dev enp0s3
  • Konfiguracja trwała (Debian/Ubuntu – /etc/netplan/*.yaml):
    network:
      version: 2
      ethernets:
        enp0s3: # nazwę interfejsu sprawdź poleceniem ip link
          addresses:
            - 192.168.1.5/24
            - 192.168.1.10/24
  • Wiązanie w serwerach WWW: Apache: <VirtualHost 192.168.1.10:80>; Nginx: listen 192.168.1.10:80;.
Aliasy interfejsów sieciowych: Slajd przedstawia zagadnienie Konfiguracja wielu adresów IP na jednym interfejsie w systemie Linux w ramach tematu Aliasy interfejsów sieciowych na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
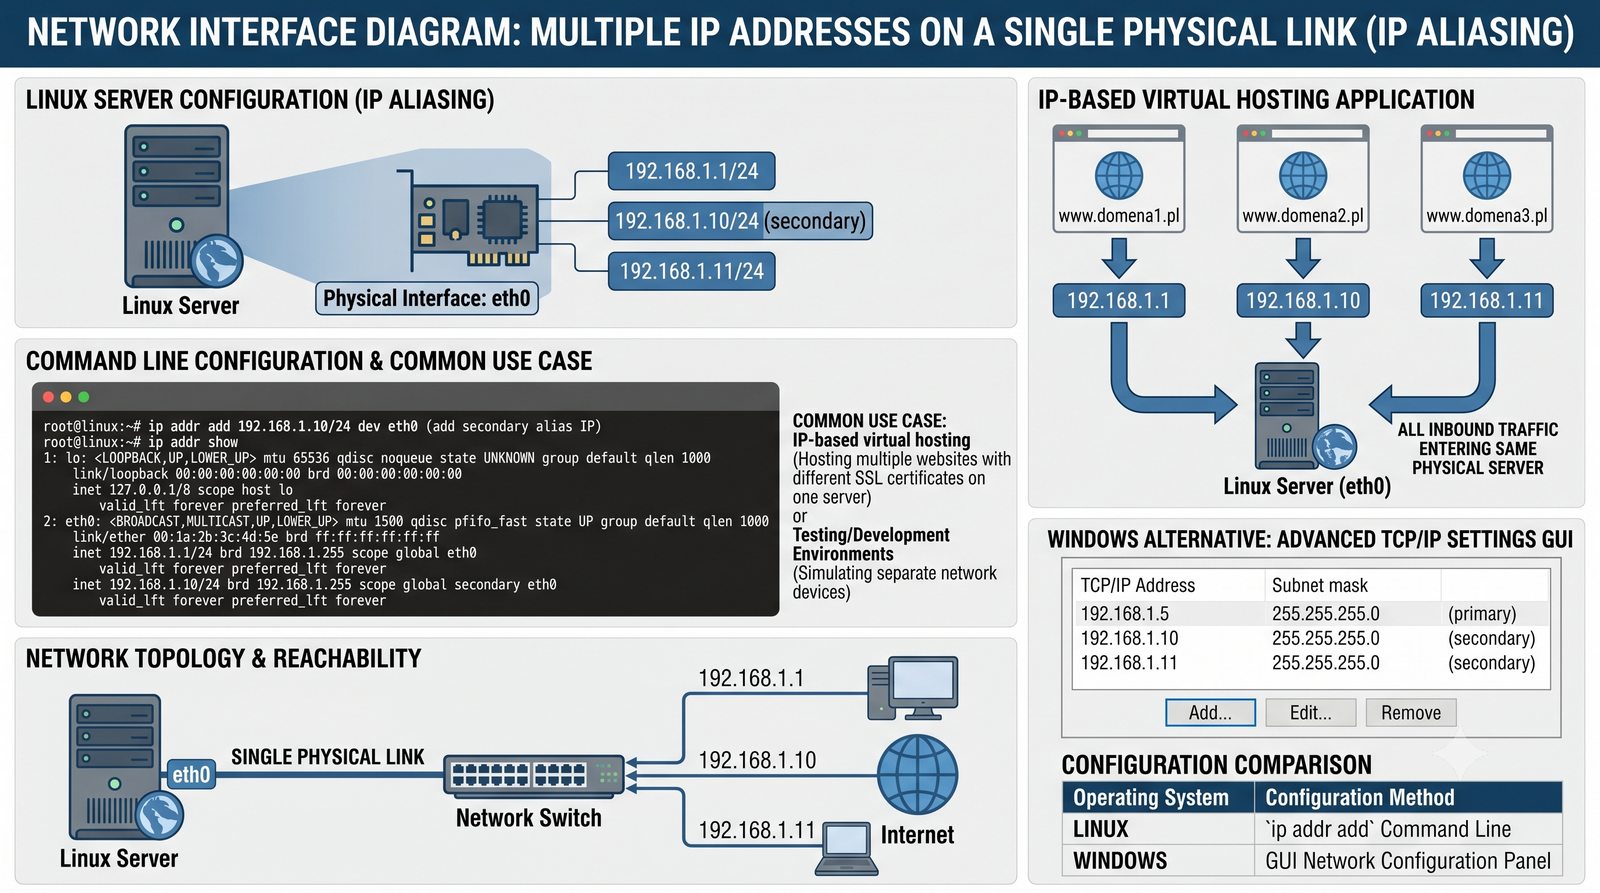
Aliasy interfejsów
36/50
Laboratorium: konfiguracja dwóch wirtualnych hostów
Cel slajdu: Slajd omawia zagadnienie „Laboratorium: konfiguracja dwóch wirtualnych hostów” w kontekście: Tworzenie i aktywacja hostów testowych w serwerze Apache.

Tworzenie i aktywacja hostów testowych w serwerze Apache

Scenariusz inżynierski: Wdrożenie dwóch niezależnych witryn wirtualnych na serwerze Apache 2.4: strona1.local oraz strona2.local.

  1. Przygotowanie struktury katalogów i uprawnień:
    sudo mkdir -p /var/www/strona1/public_html
    sudo mkdir -p /var/www/strona2/public_html
    sudo chown -R www-data:www-data /var/www/strona*
    sudo chmod -R 755 /var/www/strona*
  2. Utworzenie plików indeksowych HTML:
    echo "<h1>Witamy na Stronie 1</h1>" | sudo tee /var/www/strona1/public_html/index.html
    echo "<h1>Witamy na Stronie 2</h1>" | sudo tee /var/www/strona2/public_html/index.html
  3. Lokalna rezolucja nazw w pliku /etc/hosts:
    # Dopisek w /etc/hosts stacji roboczej:
    127.0.0.1   strona1.local strona2.local
  4. Utworzenie konfiguracji, aktywacja witryn i przeładowanie:
    sudo a2ensite strona1.conf strona2.conf
    sudo apache2ctl configtest
    sudo systemctl reload apache2
Laboratorium: konfiguracja dwóch wirtualnych hostów: Slajd przedstawia zagadnienie Tworzenie i aktywacja hostów testowych w serwerze Apache w ramach tematu Laboratorium: konfiguracja dwóch wirtualnych hostów na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
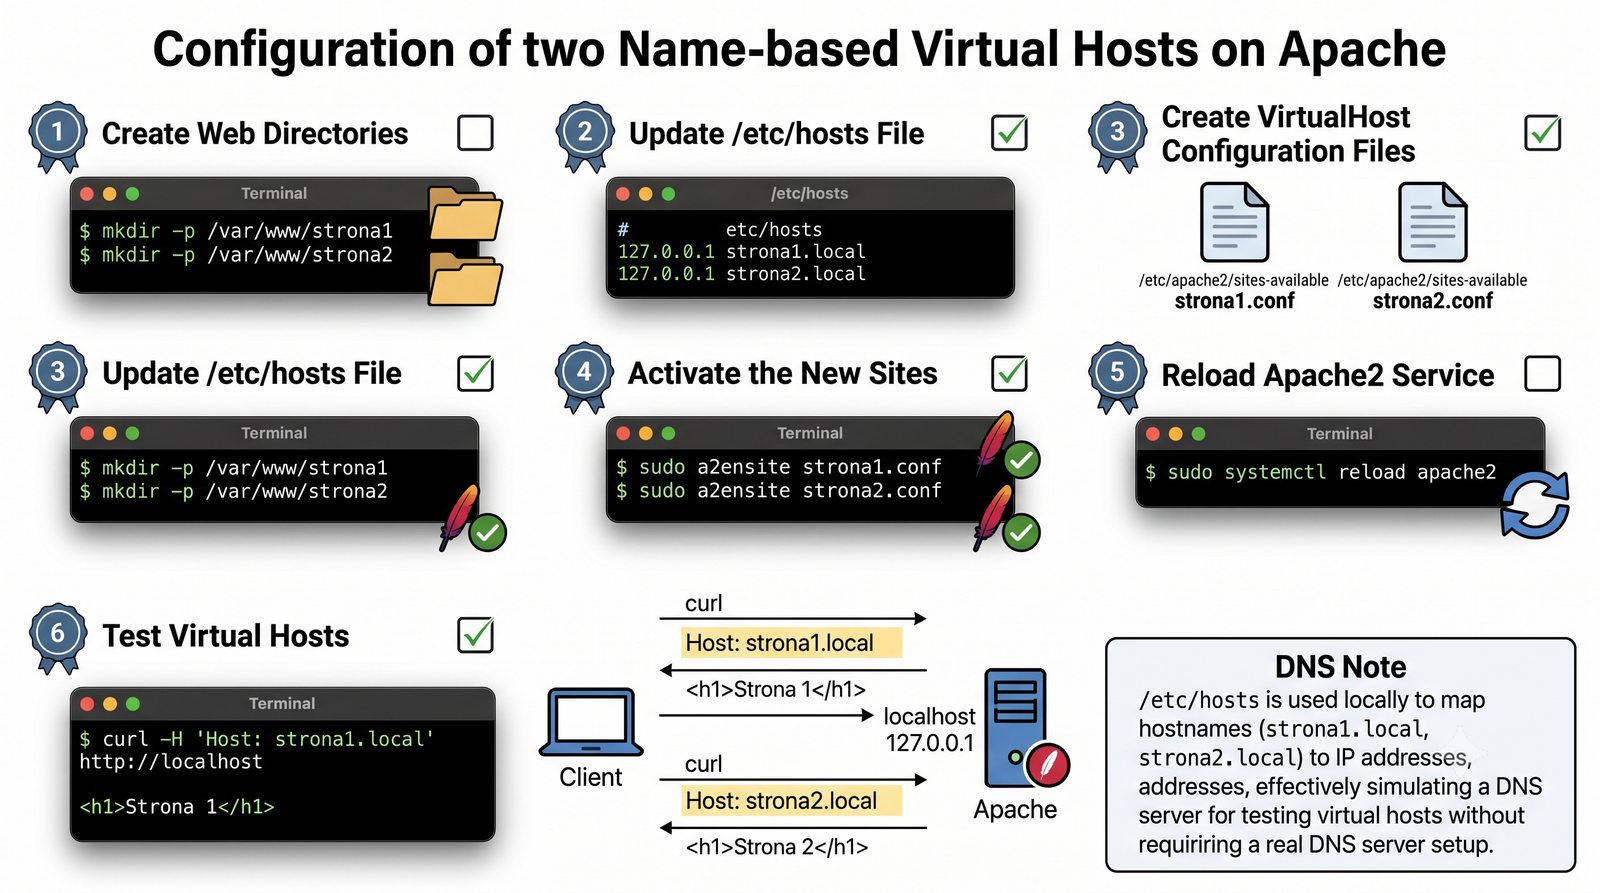
Laboratorium wirtualne hosty
37/50
Laboratorium: pliki VirtualHost dla stron
Cel slajdu: Slajd omawia zagadnienie „Laboratorium: pliki VirtualHost dla stron” w kontekście: Konfiguracja witryn strona1.local i strona2.local.

Konfiguracja witryn strona1.local i strona2.local

Kod pliku /etc/apache2/sites-available/strona1.conf:

<VirtualHost *:80>
    ServerName strona1.local
    ServerAlias www.strona1.local
    ServerAdmin webmaster@strona1.local
    DocumentRoot /var/www/strona1/public_html

    ErrorLog ${APACHE_LOG_DIR}/strona1_error.log
    CustomLog ${APACHE_LOG_DIR}/strona1_access.log combined

    <Directory /var/www/strona1/public_html>
        Options -Indexes +FollowSymLinks
        AllowOverride None
        Require all granted
    </Directory>
</VirtualHost>

Kod pliku /etc/apache2/sites-available/strona2.conf:

<VirtualHost *:80>
    ServerName strona2.local
    ServerAlias www.strona2.local
    DocumentRoot /var/www/strona2/public_html

    ErrorLog ${APACHE_LOG_DIR}/strona2_error.log
    CustomLog ${APACHE_LOG_DIR}/strona2_access.log combined

    <Directory /var/www/strona2/public_html>
        Options -Indexes +FollowSymLinks
        AllowOverride None
        Require all granted
    </Directory>
</VirtualHost>
Laboratorium: pliki VirtualHost dla stron: Slajd przedstawia zagadnienie Konfiguracja witryn strona1.local i strona2.local w ramach tematu Laboratorium: pliki VirtualHost dla stron na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
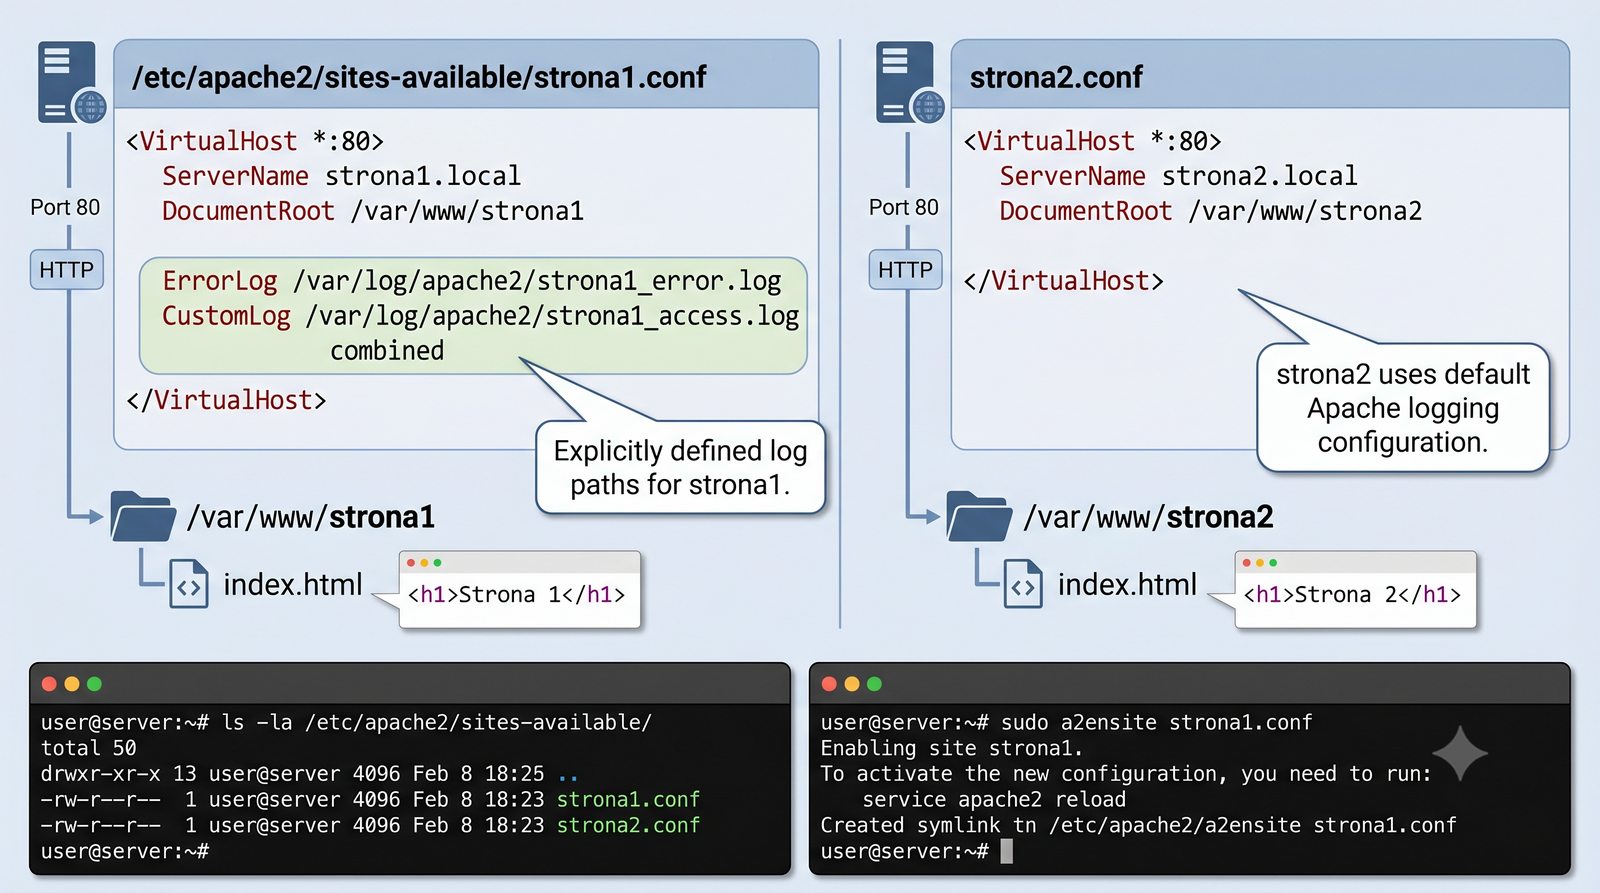
Plik VirtualHost
38/50
Laboratorium: testowanie wirtualnych hostów
Cel slajdu: Slajd omawia zagadnienie „Laboratorium: testowanie wirtualnych hostów” w kontekście: Weryfikacja działania hostów wirtualnych narzędziem curl.

Weryfikacja działania hostów wirtualnych narzędziem curl

Weryfikacja poprawności routingu domenowego bez konieczności modyfikowania wpisów w systemowym pliku /etc/hosts:

# Test 1: Wstrzyknięcie nagłówka Host dla strony 1
curl -H "Host: strona1.local" http://127.0.0.1/
# Wynik: <h1>Witamy na Stronie 1</h1>

# Test 2: Wstrzyknięcie nagłówka Host dla strony 2
curl -H "Host: strona2.local" http://127.0.0.1/
# Wynik: <h1>Witamy na Stronie 2</h1>

# Test 3: Profesjonalne obejście DNS za pomocą parametru --resolve (zgodnie z RFC)
curl -v --resolve strona1.local:80:127.0.0.1 http://strona1.local/

# Test 4: Zapytanie z nieznanym nagłówkiem Host (odpowiedź hosta domyślnego 000-default)
curl -H "Host: nieznana-domena.pl" http://127.0.0.1/
  • Flaga -H "Host: ..." instruuje serwer WWW, który VirtualHost ma obsłużyć zapytanie.
  • Opcja --resolve wymusza powiązanie domeny, portu i adresu IP wewnątrz biblioteki libcurl, co jest kluczowe w testach SNI/HTTPS.
Laboratorium: testowanie wirtualnych hostów: Slajd przedstawia zagadnienie Weryfikacja działania hostów wirtualnych narzędziem curl w ramach tematu Laboratorium: testowanie wirtualnych hostów na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
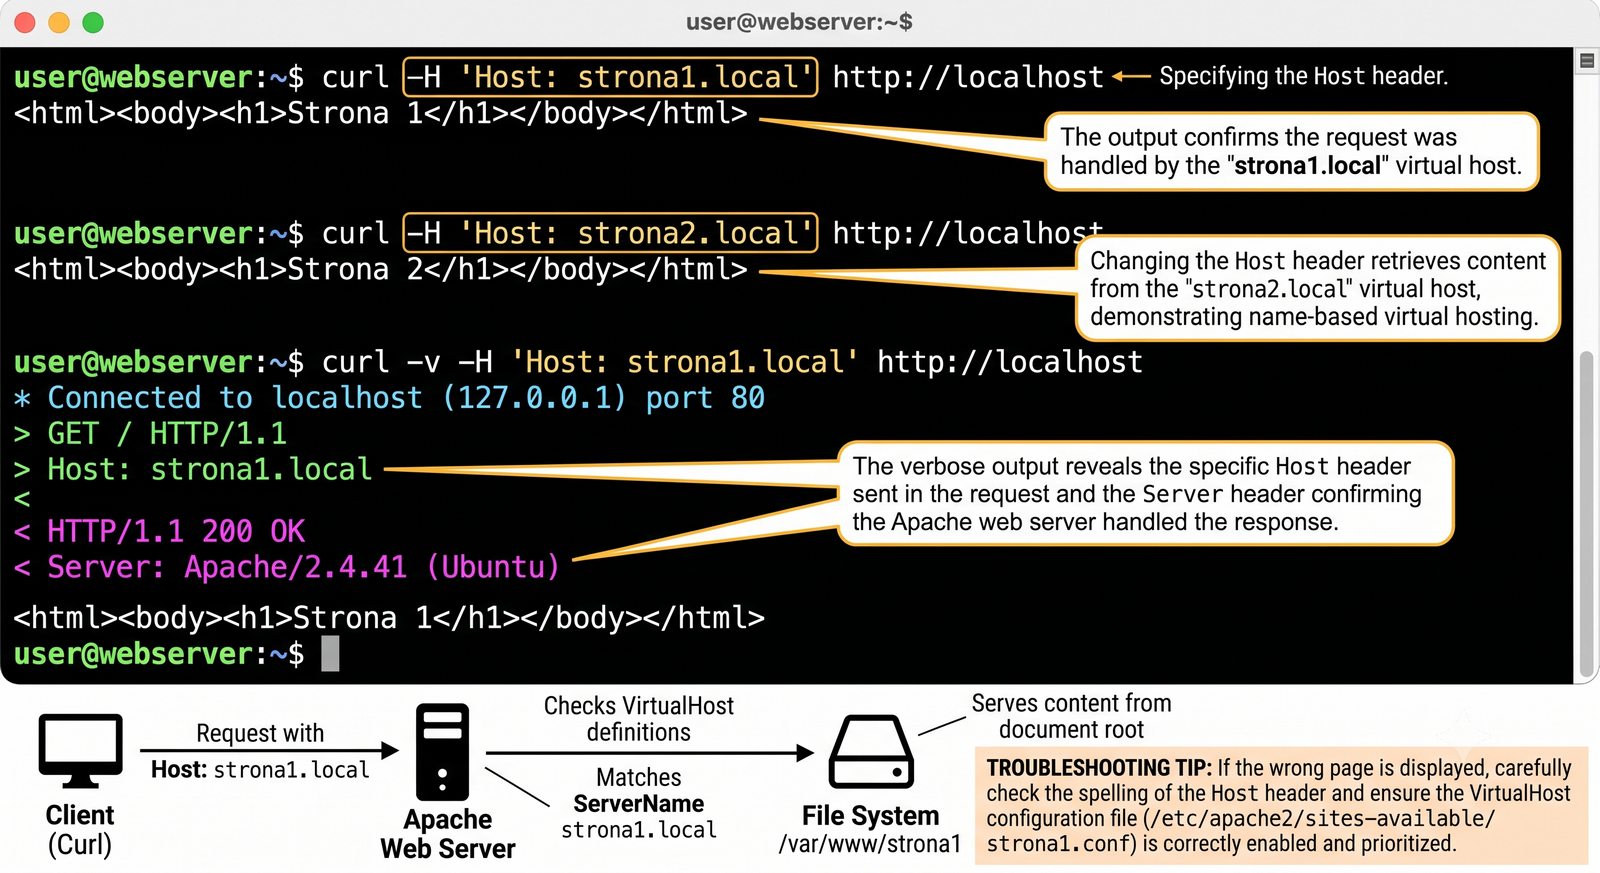
Testowanie hostów
39/50
Nagłówki HTTP – przegląd i znaczenie
Cel slajdu: Slajd omawia zagadnienie „Nagłówki HTTP – przegląd i znaczenie” w kontekście: Klasyfikacja nagłówków według ról i funkcji protokołu.

Klasyfikacja nagłówków według ról i funkcji protokołu

Zgodnie ze standardem RFC 9110 nagłówki HTTP to ustrukturyzowane metadane sterujące przebiegiem transakcji. Dzielą się na cztery główne kategorie funkcjonalne:

  • Nagłówki reprezentacji / ładunku (Representation / Payload Headers):
    • Dotyczą bezpośrednio przesyłanego ciała wiadomości: Content-Type (typ MIME zasobu), Content-Length (rozmiar w bajtach), Content-Encoding (kompresja: gzip, br), Content-Language.
  • Nagłówki żądania (Request Headers):
    • Wysyłane wyłącznie przez klienta: Host (domena wirtualnego hosta), User-Agent (identyfikacja klienta), Accept (preferowane typy MIME), Authorization (poświadczenia), Referer (adres URL źródła), If-None-Match (walidacja świeżości).
  • Nagłówki odpowiedzi (Response Headers):
    • Odsyłane przez serwer: Server (oprogramowanie WWW), Location (docelowy URL w przekierowaniach 3xx), Set-Cookie (inicjacja sesji), Allow (dozwolone metody w kodzie 405).
  • Nagłówki sterowania połączeniem (Connection Management):
    • Connection: keep-alive / close, Keep-Alive: timeout=5, max=100, Upgrade.
Nagłówki HTTP – przegląd i znaczenie: Slajd przedstawia zagadnienie Klasyfikacja nagłówków według ról i funkcji protokołu w ramach tematu Nagłówki HTTP – przegląd i znaczenie na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
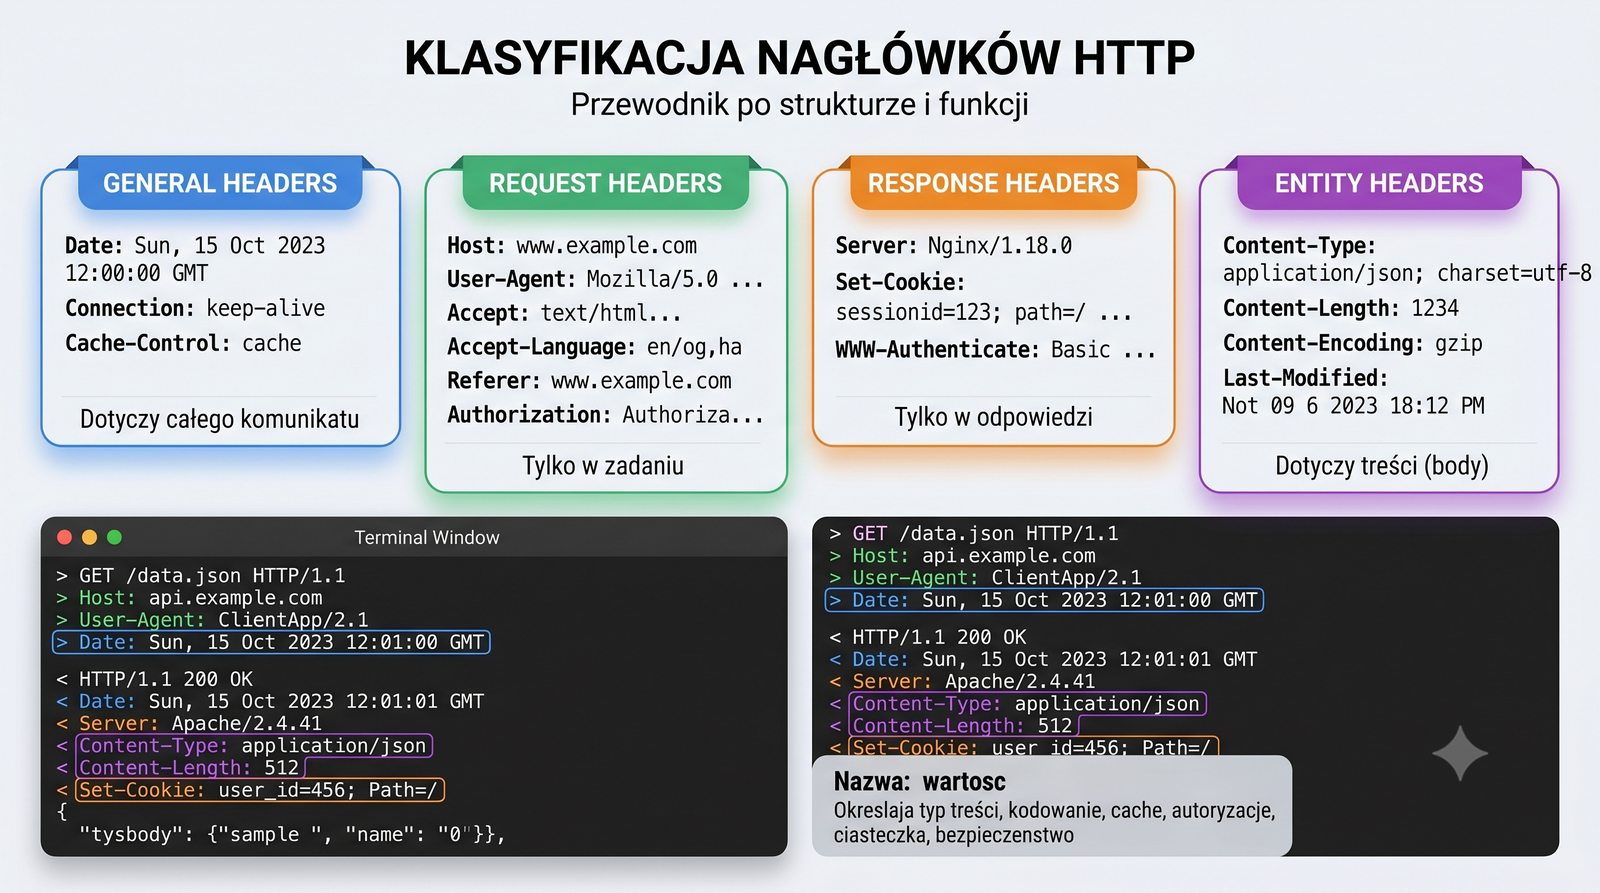
nagłówki HTTP
40/50
Nagłówki bezpieczeństwa HTTP
Cel slajdu: Slajd omawia zagadnienie „Nagłówki bezpieczeństwa HTTP” w kontekście: CSP, HSTS, X-Frame-Options i ochrona przed atakami webowymi.

CSP, HSTS, X-Frame-Options i ochrona przed atakami webowymi

Prawidłowo skonfigurowane nagłówki bezpieczeństwa stanowią pierwszą, krytyczną linię obrony przeglądarki przed atakami XSS, clickjackingiem i podsłuchem sieciowym:

  • Content-Security-Policy (CSP):
    • Restrykcyjna biała lista dozwolonych źródeł skryptów, stylów, obrazów i połączeń: default-src 'self'; script-src 'self' https://trusted.cdn.com; object-src 'none';.
    • Definitywnie eliminuje ataki XSS (Cross-Site Scripting) poprzez blokadę wykonywania nieautoryzowanych skryptów wstrzykniętych w treść strony.
  • Strict-Transport-Security (HSTS – RFC 6797):
    • max-age=31536000; includeSubDomains; preload – obowiązek łączenia się wyłącznie przez HTTPS przez zadeklarowany czas (np. 1 rok); uniemożliwia ataki SSL Stripping.
  • X-Frame-Options: DENY lub SAMEORIGIN – uniemożliwia osadzenie witryny w elemencie <iframe> na obcej domenie, neutralizując ataki Clickjacking (w nowoczesnych przeglądarkach uzupełniane przez dyrektywę CSP frame-ancestors 'self').
  • X-Content-Type-Options: nosniff – blokuje automatyczne zgadywanie typu pliku (MIME sniffing).
Nagłówki bezpieczeństwa HTTP: Slajd przedstawia zagadnienie CSP, HSTS, X-Frame-Options i ochrona przed atakami webowymi w ramach tematu Nagłówki bezpieczeństwa HTTP na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
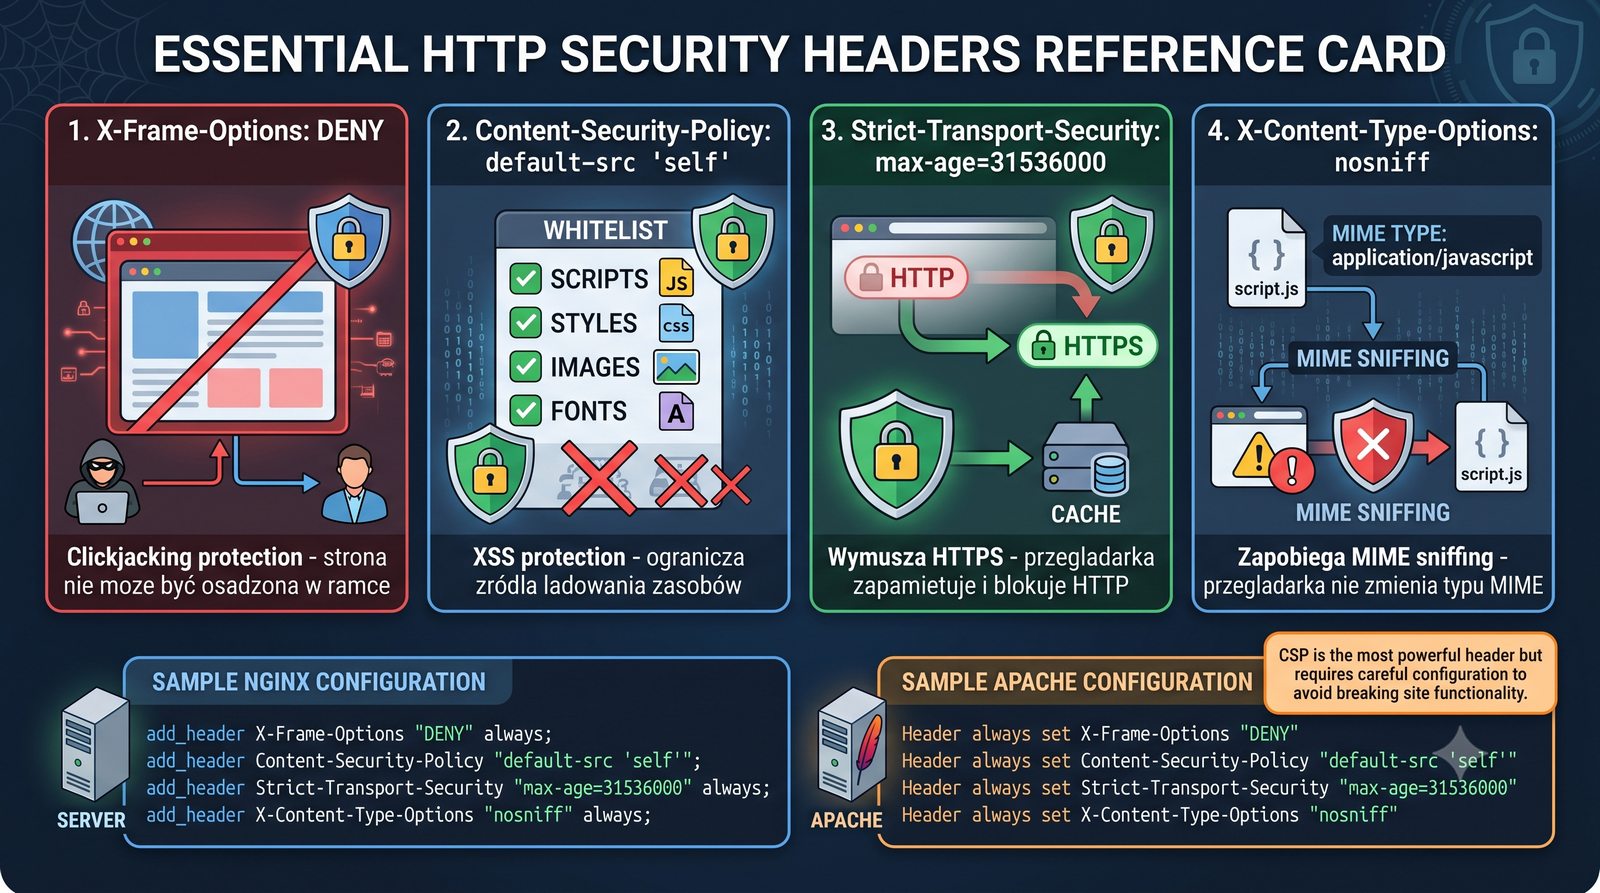
nagłówki bezpieczeństwa
41/50
Nagłówki pamięci podręcznej HTTP
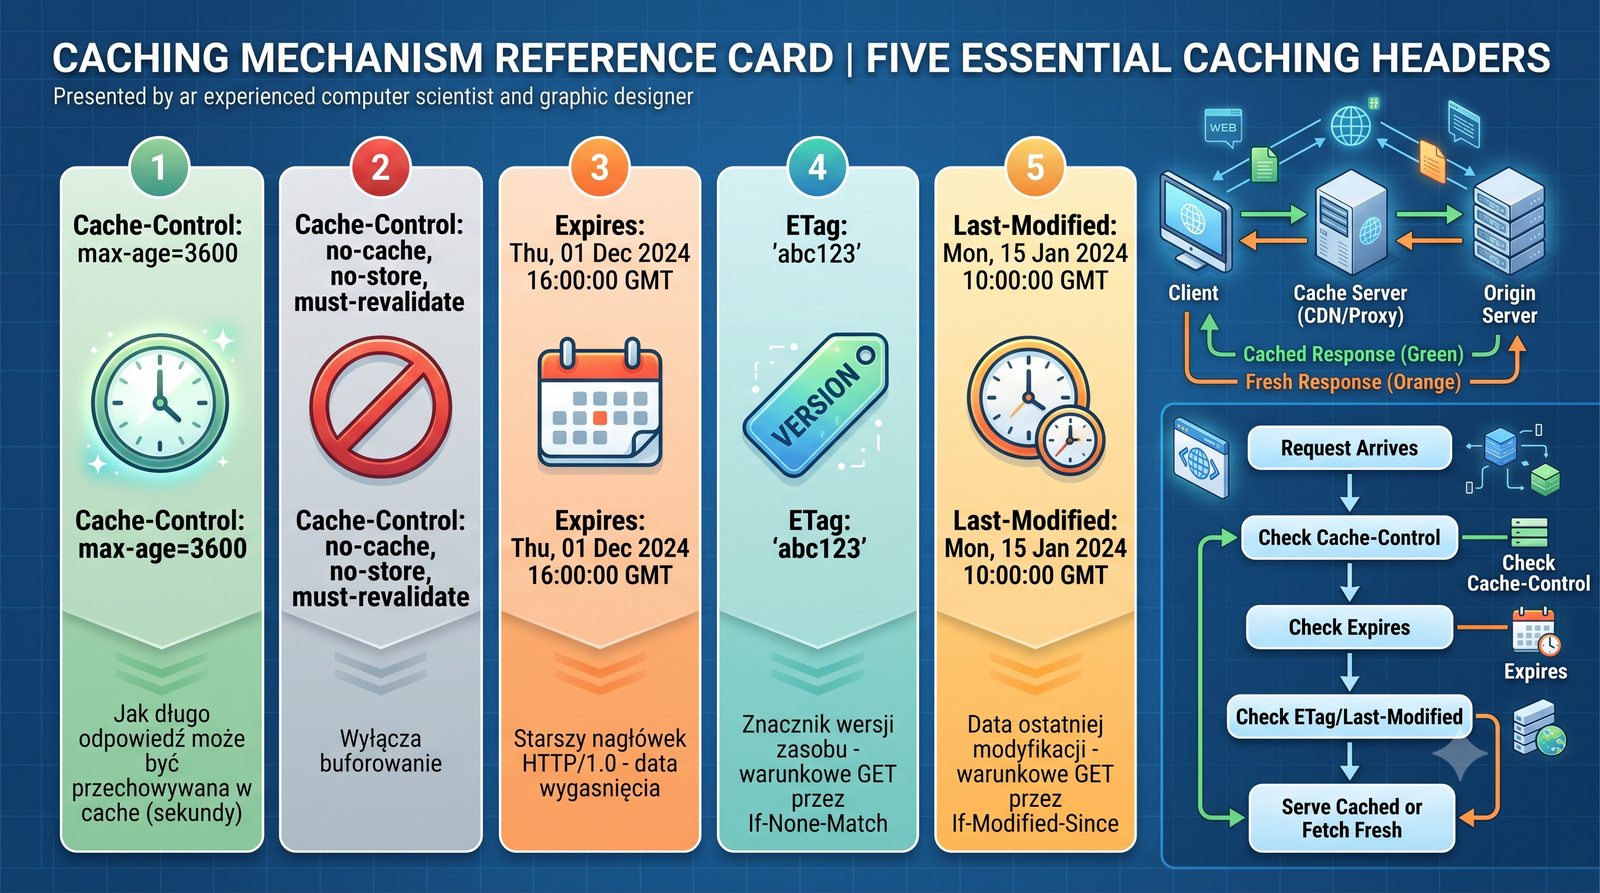
Cel slajdu: Slajd omawia zagadnienie „Nagłówki pamięci podręcznej HTTP” w kontekście: Sterowanie buforowaniem: Cache-Control, ETag i walidacja warunkowa.

Sterowanie buforowaniem: Cache-Control, ETag i walidacja warunkowa

Zgodnie ze standardem RFC 9111 (HTTP Caching) pamięć podręczna drastycznie redukuje opóźnienia i obciążenie łączy sieciowych:

  • Dyrektywa Cache-Control:
    • max-age=3600 – czas świeżości zasobu w sekundach (1 godzina) dla pamięci lokalnej przeglądarki.
    • s-maxage=86400 – czas świeżości dedykowany dla współdzielonych serwerów proxy i sieci CDN.
    • public / private – zezwolenie na buforowanie przez serwery pośredniczące lub zastrzeżenie wyłącznie dla przeglądarki klienta.
    • no-cache – nakaz każdorazowej revalidacji świeżości z serwerem źródłowym przed użyciem zasobu (nie oznacza zakazu zapisu!).
    • no-store – całkowity zakaz zapisywania zasobu w jakiejkolwiek pamięci trwałej (dla danych wrażliwych, transakcji bankowych).
  • Mechanizmy walidacji warunkowej (żądania Conditional GET):
    • Silna walidacja: Serwer odsyła znacznik ETag: "hash314". Klient przy kolejnym zapytaniu wysyła nagłówek If-None-Match: "hash314".
    • Słaba walidacja: Serwer odsyła Last-Modified: Date. Klient wysyła If-Modified-Since: Date.
    • Gdy zasób nie uległ zmianie, serwer odsyła lekki kod 304 Not Modified (bez ciała).
Nagłówki pamięci podręcznej HTTP: Slajd przedstawia zagadnienie Sterowanie buforowaniem: Cache-Control, ETag i walidacja warunkowa w ramach tematu Nagłówki pamięci podręcznej HTTP na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
Nagłówki cache
42/50
Najważniejsze nagłówki żądania i odpowiedzi
Cel slajdu: Slajd omawia zagadnienie „Najważniejsze nagłówki żądania i odpowiedzi” w kontekście: Zestawienie kluczowych nagłówków w protokole HTTP.

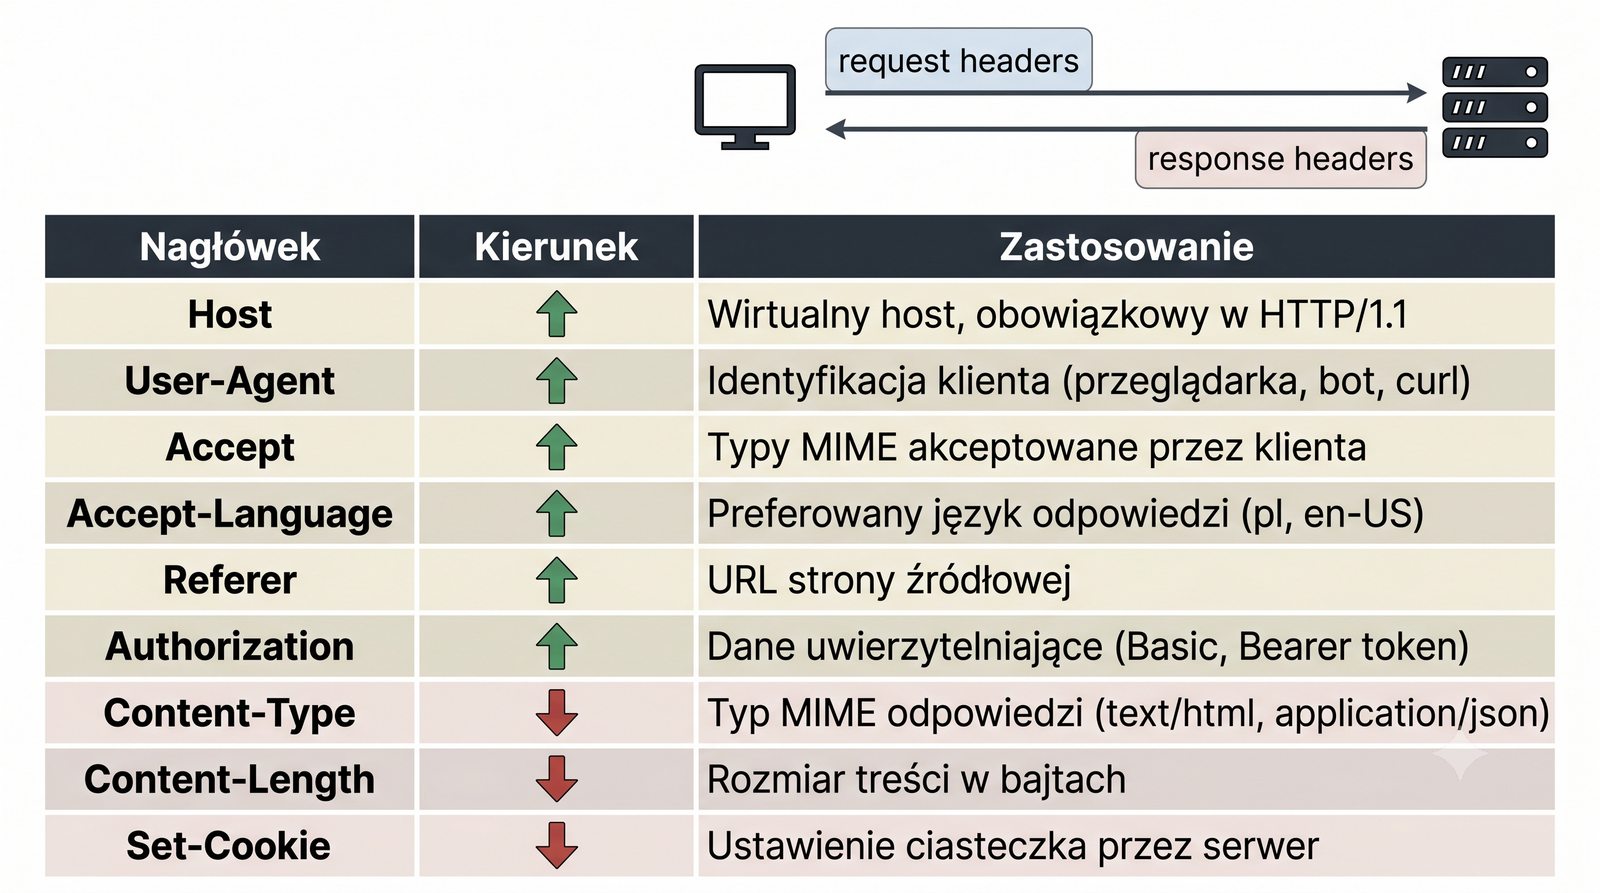
Zestawienie kluczowych nagłówków w protokole HTTP

Nagłówek Kierunek Rola i znaczenie semantyczne
Host Żądanie Wybór wirtualnego hosta; obowiązkowy w HTTP/1.1
User-Agent Żądanie Identyfikacja oprogramowania klienta (przeglądarka, robot indeksujący)
Accept Żądanie Typy MIME akceptowane przez klienta (np. text/html, application/json)
Authorization Żądanie Poświadczenia uwierzytelniające (schemat Basic, Bearer <token>)
Content-Type Oba Typ MIME przesyłanego ładunku oraz kodowanie znaków (np. charset=UTF-8)
Content-Length Oba Dokładny rozmiar ciała wiadomości wyrażony w bajtach
Set-Cookie Odpowiedź Inicjalizacja ciasteczka w przeglądarce (atrybuty Secure, HttpOnly, SameSite)
Location Odpowiedź Docelowy adres URL w przekierowaniach 3xx lub adres nowego zasobu w kodzie 201
Server Odpowiedź Identyfikator oprogramowania serwera (np. nginx, Apache/2.4.58)
Najważniejsze nagłówki żądania i odpowiedzi: Slajd przedstawia zagadnienie Zestawienie kluczowych nagłówków w protokole HTTP w ramach tematu Najważniejsze nagłówki żądania i odpowiedzi na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
Kompendium nagłówków
43/50
Negocjacja treści (content negotiation)
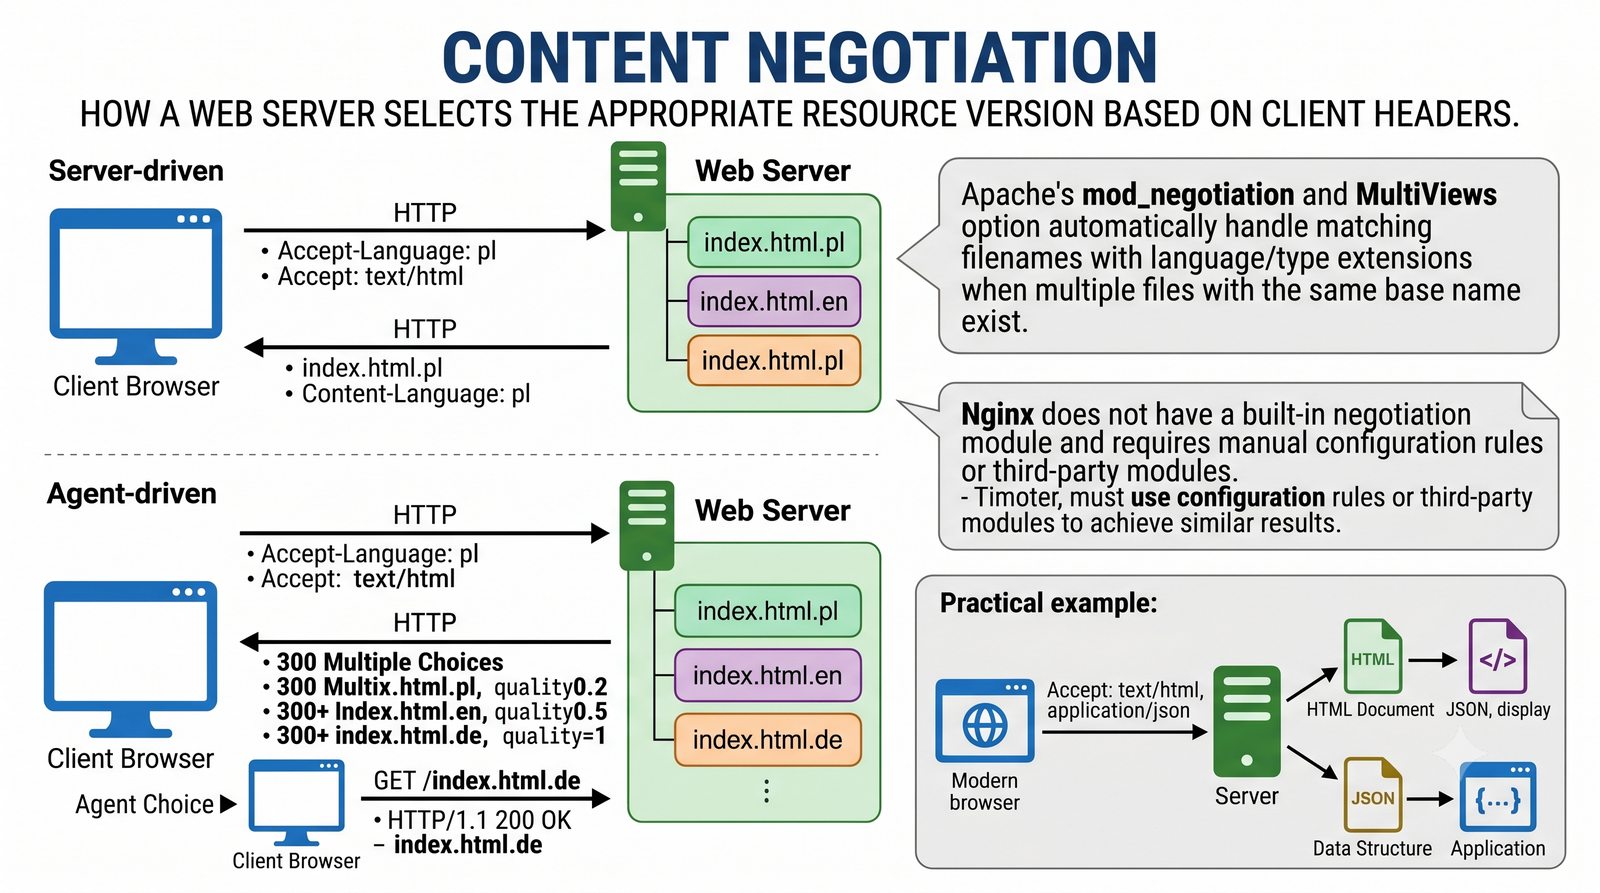
Cel slajdu: Slajd omawia zagadnienie „Negocjacja treści (content negotiation)” w kontekście: Mechanizmy doboru reprezentacji zasobu: język, format, kodowanie.

Mechanizmy doboru reprezentacji zasobu: język, format, kodowanie

Zgodnie ze standardem RFC 9110 negocjacja treści umożliwia serwerowi zwrócenie najbardziej dopasowanej postaci zasobu pod tym samym adresem URI w oparciu o preferencje klienta:

  • Negocjacja proaktywna (Server-driven):
    • Klient przekazuje w nagłówkach żądania swoje możliwości wraz ze współczynnikami wag (q-factor z zakresu 0.0–1.0):
    • Accept-Language: pl,en-US;q=0.8,en;q=0.6 – preferowany język polski, dopuszczalny angielski amerykański (waga 0.8) i ogólny angielski (0.6).
    • Accept: text/html, application/xhtml+xml, application/json;q=0.9.
    • Accept-Encoding: gzip, deflate, br, zstd – akceptowane algorytmy kompresji strumienia danych.
  • Rola nagłówka Vary w pamięci podręcznej:
    • Serwer musi odesłać nagłówek informujący węzły cache, na podstawie których kryteriów dokonano wyboru: Vary: Accept-Encoding, Accept-Language.
    • Zapobiega to katastrofalnemu zaserwowaniu wersji skompresowanej klientowi, który nie potrafi jej zdekompresować.
  • Implementacja: Apache: moduł mod_negotiation i dyrektywa MultiViews; Nginx: obsługa przez dyrektywy map i moduły gzip/brotli.
Negocjacja treści (ang. content negotiation): Slajd przedstawia zagadnienie Mechanizmy doboru reprezentacji zasobu: język, format, kodowanie w ramach tematu Negocjacja treści (content negotiation) na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
Negocjacja tresci
44/50
Diagnostyka HTTP – DevTools przeglądarki
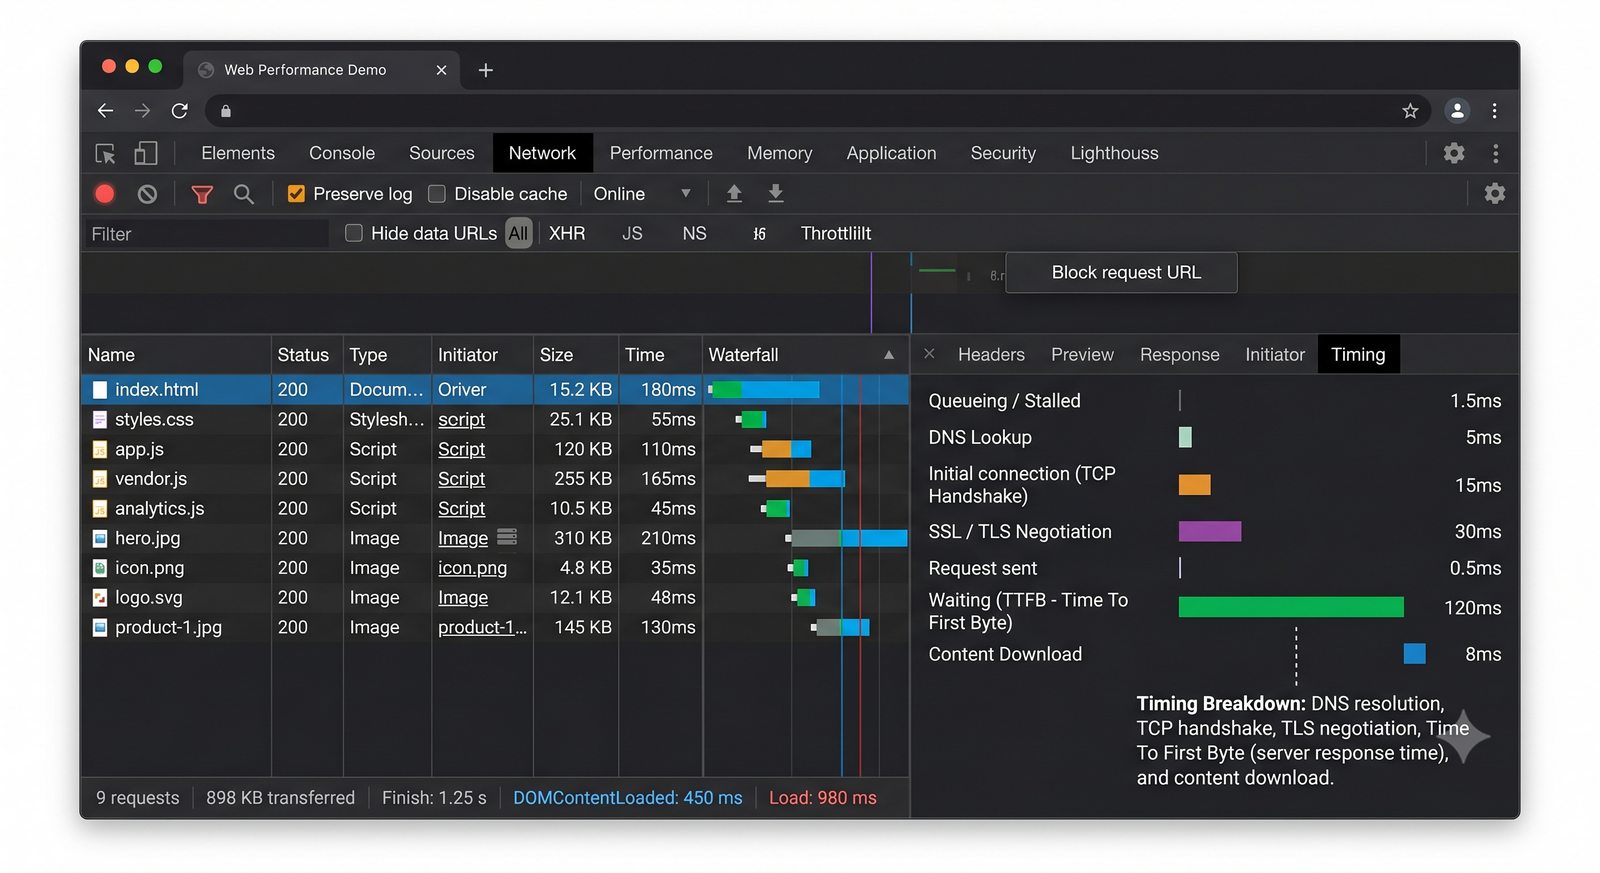
Cel slajdu: Slajd omawia zagadnienie „Diagnostyka HTTP – DevTools przeglądarki” w kontekście: Panel Network: inspekcja żądań, nagłówków i czasów TTFB.

Panel Network: inspekcja żądań, nagłówków i czasów TTFB

Panel sieciowy narzędzi deweloperskich (skrót F12 → zakładka Network w przeglądarkach Chrome, Firefox, Edge) to podstawowe narzędzie analizy interakcji klient-serwer:

  • Tabela żądań i filtracja: Podgląd wszystkich pobieranych zasobów: metoda, kod statusu, protokół (h2, h3), typ MIME, rozmiar transferu oraz całkowity czas. Możliwość filtrowania wg typu (Doc, JS, CSS, Img, Fetch/XHR, WS).
  • Inspekcja szczegółowa wybranego żądania:
    • Headers: Pełny podgląd nagłówków surowych (Raw Headers) żądania i odpowiedzi oraz linii statusu.
    • Payload / Response: Podgląd przesłanych parametrów POST/JSON oraz surowego ciała odpowiedzi.
    • Initiator: Drzewo wywołań w kodzie źródłowym wskazujące, która linia skryptu wygenerowała dane połączenie.
  • Wodospad czasowy (Timing Breakdown):
    • Queueing i Stalled – oczekiwanie w kolejce przeglądarki na wolne gniazdo TCP.
    • DNS Lookup & Initial Connection – czas rezolucji DNS i trójstopniowego uzgadniania TCP.
    • SSL / TLS Handshake – czas negocjacji kryptograficznej certyfikatu i kluczy sesji.
    • Waiting for server response (TTFB): Czas oczekiwania na pierwszy bajt odpowiedzi z backendu serwera.
    • Content Download – czas fizycznego pobierania strumienia danych z łącza.
Diagnostyka HTTP – DevTools przeglądarki: Slajd przedstawia zagadnienie Panel Network: inspekcja żądań, nagłówków i czasów TTFB w ramach tematu Diagnostyka HTTP – DevTools przeglądarki na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
DevTools
45/50
Laboratorium: analiza ruchu HTTP
Cel slajdu: Slajd omawia zagadnienie „Laboratorium: analiza ruchu HTTP” w kontekście: Zestaw pięciu ćwiczeń diagnostycznych z użyciem curl i DevTools.

Zestaw pięciu ćwiczeń diagnostycznych z użyciem curl i DevTools

  1. Ćwiczenie 1 (Inspekcja surowego protokołu): Wykonaj curl -v http://example.com. Zidentyfikuj fazę rezolucji DNS, adres IP, port, linię żądania oraz nagłówki odpowiedzi.
  2. Ćwiczenie 2 (Śledzenie łańcucha przekierowań): Wykonaj curl -v -L http://example.com. Przeanalizuj odpowiedź 301 Moved Permanently, nagłówek Location oraz kolejne zestawienie połączenia na porcie HTTPS/443. Uwaga: example.com zwraca obecnie bezpośrednio kod 200 bez przekierowania; łańcuch przekierowań 301 przećwiczysz np. na http://github.com.
  3. Ćwiczenie 3 (Wstrzykiwanie nagłówków autoryzacji i debugowania): Wykonaj zapytanie z własnymi metadanymi:
    curl -H "X-Debug-Mode: 1" -H "Accept: application/json" http://127.0.0.1/
    Sprawdź w logu access.log serwera, jak żądanie zostało zarejestrowane.
  4. Ćwiczenie 4 (Inspekcja dozwolonych metod): Wyślij zapytanie curl -X OPTIONS http://example.com -v. Odczytaj dozwolone metody w nagłówku Allow. Uwaga: example.com odpowiada kodem 405 bez nagłówka Allow; pełną odpowiedź z nagłówkiem Allow przećwiczysz na własnym serwerze laboratoryjnym.
  5. Ćwiczenie 5 (Ekstrakcja precyzyjnych metryk czasowych): Zmierz czas TTFB i DNS poleceniem:
    curl -s -w "DNS: %{time_namelookup}s | TCP: %{time_connect}s | TLS: %{time_appconnect}s | TTFB: %{time_starttransfer}s | Całkowity czas: %{time_total}s\n" -o /dev/null https://example.com
Laboratorium: analiza ruchu HTTP: Slajd przedstawia zagadnienie Zestaw pięciu ćwiczeń diagnostycznych z użyciem curl i DevTools w ramach tematu Laboratorium: analiza ruchu HTTP na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
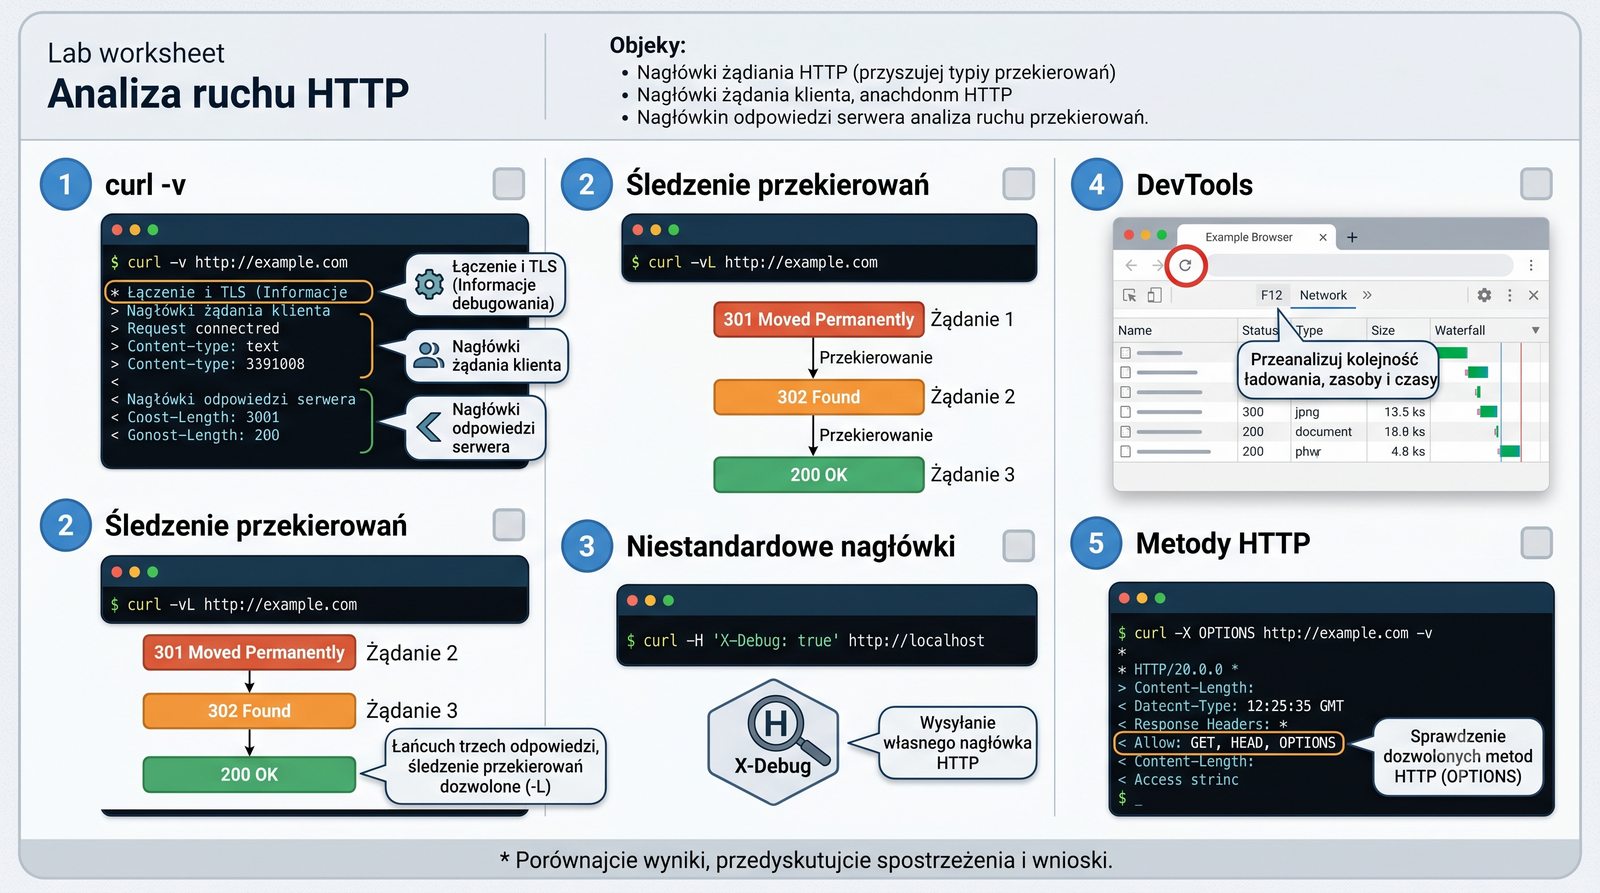
Laboratorium analiza
46/50
Najczęstsze problemy HTTP i diagnostyka
Cel slajdu: Slajd omawia zagadnienie „Najczęstsze problemy HTTP i diagnostyka” w kontekście: Identyfikacja awarii, pętli przekierowań i błędów konfiguracyjnych.

Identyfikacja awarii, pętli przekierowań i błędów konfiguracyjnych

Symptom awarii Prawdopodobna przyczyna Metodyka diagnostyki i rozwiązanie
Błędny VirtualHost (zła strona) Niedopasowany ServerName; zadziałał host domyślny Weryfikacja nagłówka Host; polecenie apache2ctl -S lub sprawdzenie default_server w Nginx
403 Forbidden Błędne uprawnienia plików; brak Require all granted; brak index.html Sprawdzenie uprawnień chmod 755/644; dodanie dyrektywy dostępu; wyłączenie -Indexes
500 Internal Error Błąd składni w .htaccess; awaria backendu; brak RAM Inspekcja pliku error.log; weryfikacja dopuszczalności dyrektyw w AllowOverride
Pętla przekierowań (ERR_TOO_MANY_REDIRECTS) Zapętlenie reguł HTTP↔HTTPS za proxy terminującym SSL Śledzenie z curl -vL; weryfikacja nagłówka X-Forwarded-Proto https w konfiguracji proxy
502 Bad Gateway Proces PHP-FPM / upstream nie działa lub gniazdo nie istnieje Sprawdzenie systemctl status php-fpm; weryfikacja uprawnień do socketu uniksowego
504 Gateway Timeout Backend nie odpowiedział w zadanym limicie czasu Analiza zapytań SQL do bazy danych; zwiększenie proxy_read_timeout / fastcgi_read_timeout
Najczęstsze problemy HTTP i diagnostyka: Slajd przedstawia zagadnienie Identyfikacja awarii, pętli przekierowań i błędów konfiguracyjnych w ramach tematu Najczęstsze problemy HTTP i diagnostyka na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
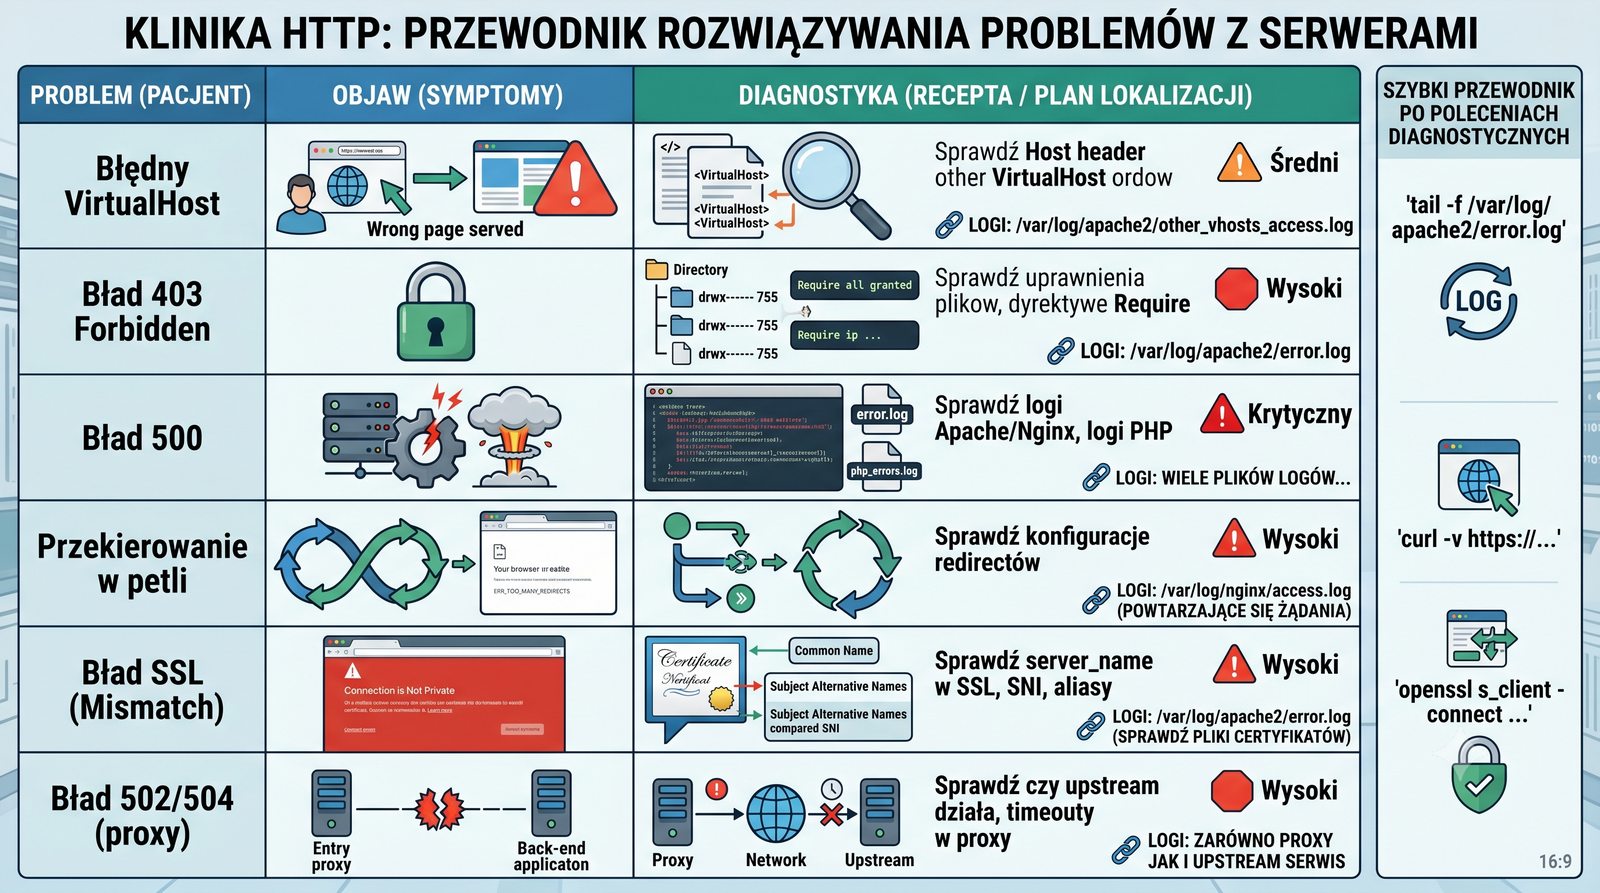
Problemy HTTP
47/50
Logi serwera – jak czytać?
Cel slajdu: Slajd omawia zagadnienie „Logi serwera – jak czytać?” w kontekście: Formaty access log i error log w serwerach Apache i Nginx.

Formaty access log i error log w serwerach Apache i Nginx

Rejestrowanie zdarzeń to kluczowy element telemetrii, bezpieczeństwa i audytu każdego serwera WWW:

  • Access Log (Dziennik dostępu): Rejestruje każde odebrane żądanie HTTP.
    • Standardowy format Combined Log Format:
    192.168.1.10 - jnowak [01/Oct/2026:12:00:00 +0200] "GET /index.html HTTP/1.1" 200 1420 "https://google.com/" "Mozilla/5.0 (X11; Linux x86_64)..."
    • Struktura pól: IP klienta → tożsamość identd (-) → zalogowany użytkownik (jnowak) → znacznik czasu z przesunięciem UTC → linia żądania → kod statusu HTTP (200) → rozmiar ciała odpowiedzi (1420 bajtów) → nagłówek Referer → nagłówek User-Agent.
  • Error Log (Dziennik błędów): Rejestruje awarie procesu, błędy konfiguracji, przekroczenia limitów czasu oraz błędy uprawnień:
    [Thu Oct 01 12:00:00.123456 2026] [core:error] [pid 1234] [client 192.168.1.10:54321] AH00128: File does not exist: /var/www/strona1/sekret.html
  • Analiza w czasie rzeczywistym: tail -f /var/log/apache2/access.log, filtrowanie: grep " 500 " access.log, generowanie statystyk konsolowych (po instalacji pakietu goaccess): goaccess access.log -c.
Logi serwera – jak czytać?: Slajd przedstawia zagadnienie Formaty access log i error log w serwerach Apache i Nginx w ramach tematu Logi serwera – jak czytać? na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
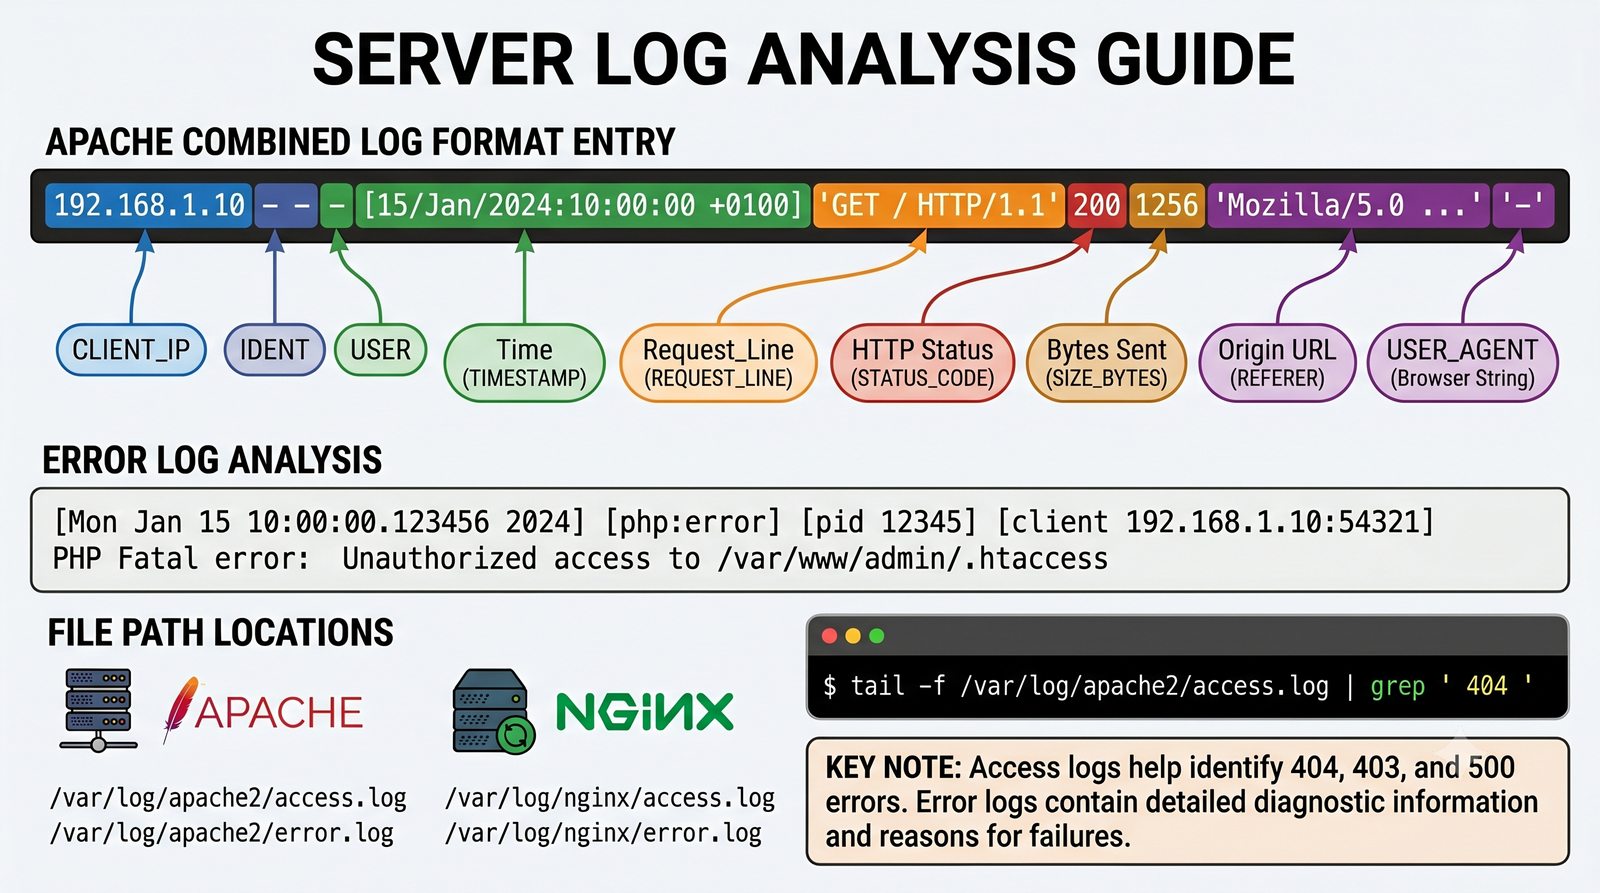
Logi serwera
48/50
Narzędzia do testowania i diagnostyki HTTP
Cel slajdu: Slajd omawia zagadnienie „Narzędzia do testowania i diagnostyki HTTP” w kontekście: curl, openssl s_client, httpie, DevTools i tcpdump/Wireshark.

curl, openssl s_client, httpie, DevTools i tcpdump/Wireshark

Kompleksowy zestaw narzędziowy inżyniera sieci do diagnostyki protokołów warstwy aplikacji i transportu:

  • curl: Wszechstronny, skryptowalny klient wiersza poleceń obsługujący HTTP/1.1, HTTP/2, HTTP/3, przesyłanie certyfikatów klienckich mTLS, ciasteczek i formularzy.
  • openssl s_client: Bezpośrednia inspekcja warstwy kryptograficznej TLS (RFC 8446):
    openssl s_client -connect example.com:443 -servername example.com -showcerts
    Weryfikacja łańcucha certyfikatów X.509, daty ważności, obsługiwanych zestawów szyfrów oraz parametrów SNI i ALPN.
  • httpie: Nowoczesna konsolowa alternatywa dla curl (instalowana osobno, np. apt install httpie) z automatycznym kolorowaniem składni, natywną obsługą formatu JSON i uproszczoną notacją nagłówków.
  • DevTools przeglądarki (F12): Graficzna inspekcja drzewa DOM, pobierania zasobów, czasów TTFB i symulacji ograniczeń sieciowych.
  • tcpdump / Wireshark: Niskopoziomowy sniffer pakietów sieciowych. Analiza flag TCP (SYN, ACK, FIN, RST), retransmisji, okna TCP (TCP Window Scaling) oraz ramek QUIC na porcie UDP/443.
  • Weryfikacja portów w systemie Linux: Polecenie ss -tulpn | grep -E ':80\b|:443\b'.
Narzędzia do testowania i diagnostyki HTTP: Slajd przedstawia zagadnienie curl, openssl s_client, httpie, DevTools i tcpdump/Wireshark w ramach tematu Narzędzia do testowania i diagnostyki HTTP na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
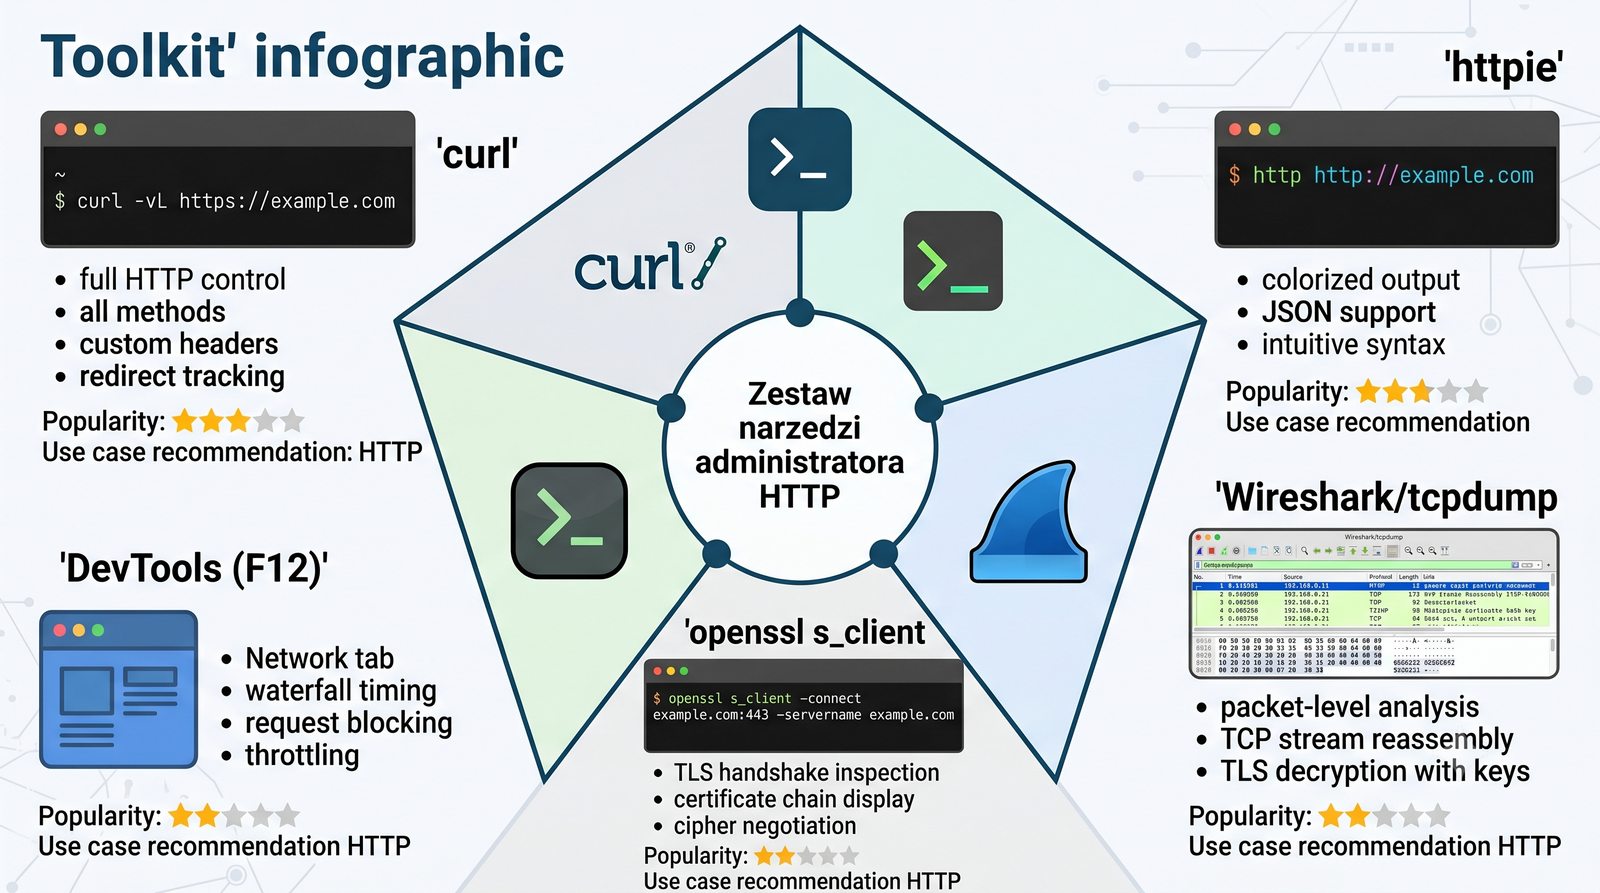
Narzędzia HTTP
49/50
Podsumowanie
Cel slajdu: Slajd omawia zagadnienie „Podsumowanie” w kontekście: Kluczowe wnioski architektoniczne i syntetyczny bilans wiedzy.

Kluczowe wnioski architektoniczne i syntetyczny bilans wiedzy

  • Paradygmat protokołu HTTP: Protokół bezstanowy działający w asymetrycznym modelu żądanie-odpowiedź (RFC 9110). Ciągłość transakcyjna realizowana jest w warstwie aplikacji za pomocą bezpiecznych ciasteczek (RFC 6265) lub kryptograficznych tokenów JWT (RFC 7519).
  • Ewolucja wydajnościowa: Przejście od pojedynczych połączeń TCP w HTTP/1.0, przez trwałe sesje Keep-Alive w HTTP/1.1 (RFC 9112) i multipleksowanie strumieni w HTTP/2 (RFC 9113), aż po eliminację blokowania czoła kolejki w HTTP/3 na fundamencie transportu UDP/QUIC (RFC 9114).
  • Architektura serwerów WWW:
    • Apache HTTP Server: Modularny system DSO; model hybrydowy MPM Event z dedykowanym wątkiem dla połączeń Keep-Alive; niezastąpiony przy obsłudze dynamicznych plików .htaccess.
    • Nginx: Skrajnie zoptymalizowana, jednowątkowa asynchroniczna pętla zdarzeń (epoll/kqueue); niedościgniona wydajność w roli reverse proxy, terminatora TLS i serwera plików statycznych (Zero-Copy sendfile).
  • Hosting wirtualny i bezpieczeństwo: Hosting oparty na nazwie (nagłówek Host i rozszerzenie SNI RFC 6066) stanowi standard rynkowy. Ochrona witryn wymaga wdrożenia nagłówków CSP, HSTS (RFC 6797), X-Frame-Options oraz certyfikatów TLS 1.3 (RFC 8446).
Podsumowanie: Slajd przedstawia zagadnienie Kluczowe wnioski architektoniczne i syntetyczny bilans wiedzy w ramach tematu Podsumowanie na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
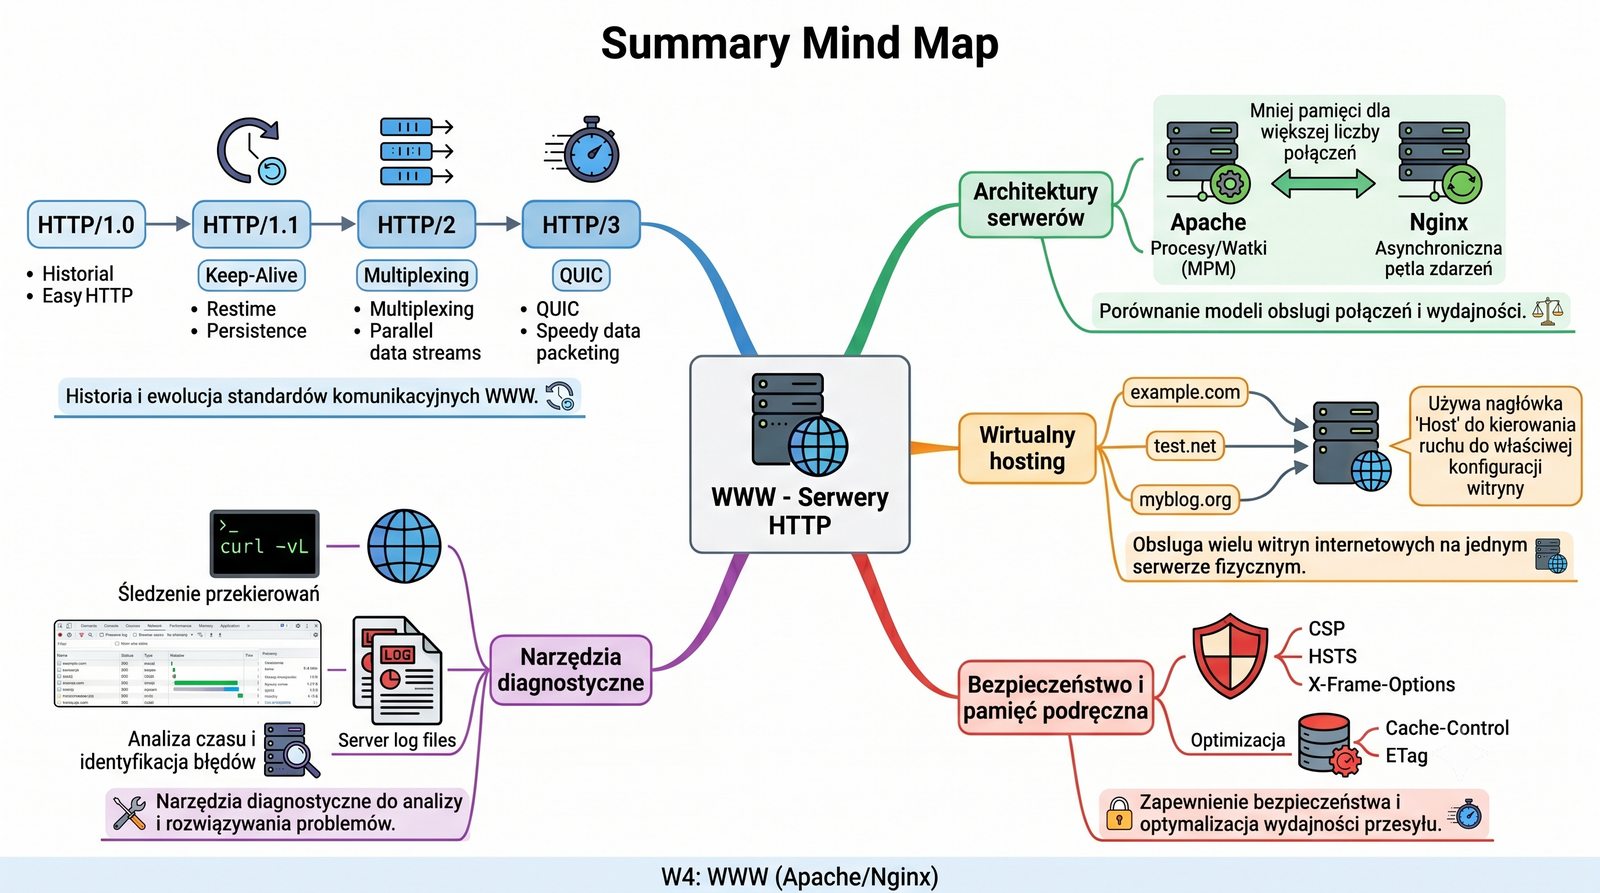
Podsumowanie
50/50
Zadanie domowe / Pytania kontrolne
Cel slajdu: Slajd omawia zagadnienie „Zadanie domowe / Pytania kontrolne” w kontekście: Pytania weryfikujące wiedzę teoretyczną i praktyczną inżyniera sieci.

Pytania weryfikujące wiedzę teoretyczną i praktyczną inżyniera sieci

  1. Architektura MPM: Wyjaśnij fundamentalne różnice w alokacji zasobów pamięciowych pomiędzy modułami mpm_prefork, mpm_worker a mpm_event w serwerze Apache 2.4. W jakich specyficznych scenariuszach wdrożeniowych zastosowanie modelu Prefork pozostaje jedynym technicznym wyborem?
  2. Skalowalność C10K: Jaką rolę w architekturze serwera Nginx odgrywa mechanizm jądra Linuksa epoll? Dlaczego Nginx charakteryzuje się stałym zużyciem pamięci RAM przy wzroście liczby połączeń z 1 000 do 50 000?
  3. Semantyka kodów przekierowań: Porównaj zachowanie klienta przy odbiorze kodów 301 Moved Permanently oraz 308 Permanent Redirect w świetle standardu RFC 9110. Jaki problem rozwiązuje kod 308 w formularzach przesyłanych metodą POST?
  4. Hosting wirtualny a TLS: Wyjaśnij mechanizm działania rozszerzenia SNI (RFC 6066). Co stanie się w sytuacji, gdy klient nieobsługujący SNI wyśle żądanie HTTPS do serwera utrzymującego 50 różnych wirtualnych hostów na jednym adresie IP?
  5. Diagnostyka awarii upstreamu: Jaka jest precyzyjna różnica techniczna pomiędzy błędem 502 Bad Gateway a 504 Gateway Timeout w tandemie Nginx + PHP-FPM? Jakie kroki diagnostyczne należy podjąć w celu usunięcia każdego z nich?
  6. Zadanie laboratoryjne CLI: Skonstruuj jedno polecenie curl, które wyśle zapytanie metodą GET do wybranej witryny, przekaże niestandardowy nagłówek X-Student-ID: 12345, podąży za przekierowaniami, a na wyjściu wyświetli wyłącznie czas trwania negocjacji TLS (time_appconnect) oraz czas TTFB (time_starttransfer), przekierowując ciało odpowiedzi do /dev/null.
Zadanie domowe / Pytania kontrolne: Slajd przedstawia zagadnienie Pytania weryfikujące wiedzę teoretyczną i praktyczną inżyniera sieci w ramach tematu Zadanie domowe / Pytania kontrolne na przykładach konfiguracji i diagnostyki w systemie Linux. Składnię komunikatów, semantykę metod i kodów statusu opisano współcześnie w RFC 9110, a implementacje serwerowe dostarczają między innymi Apache i Nginx.
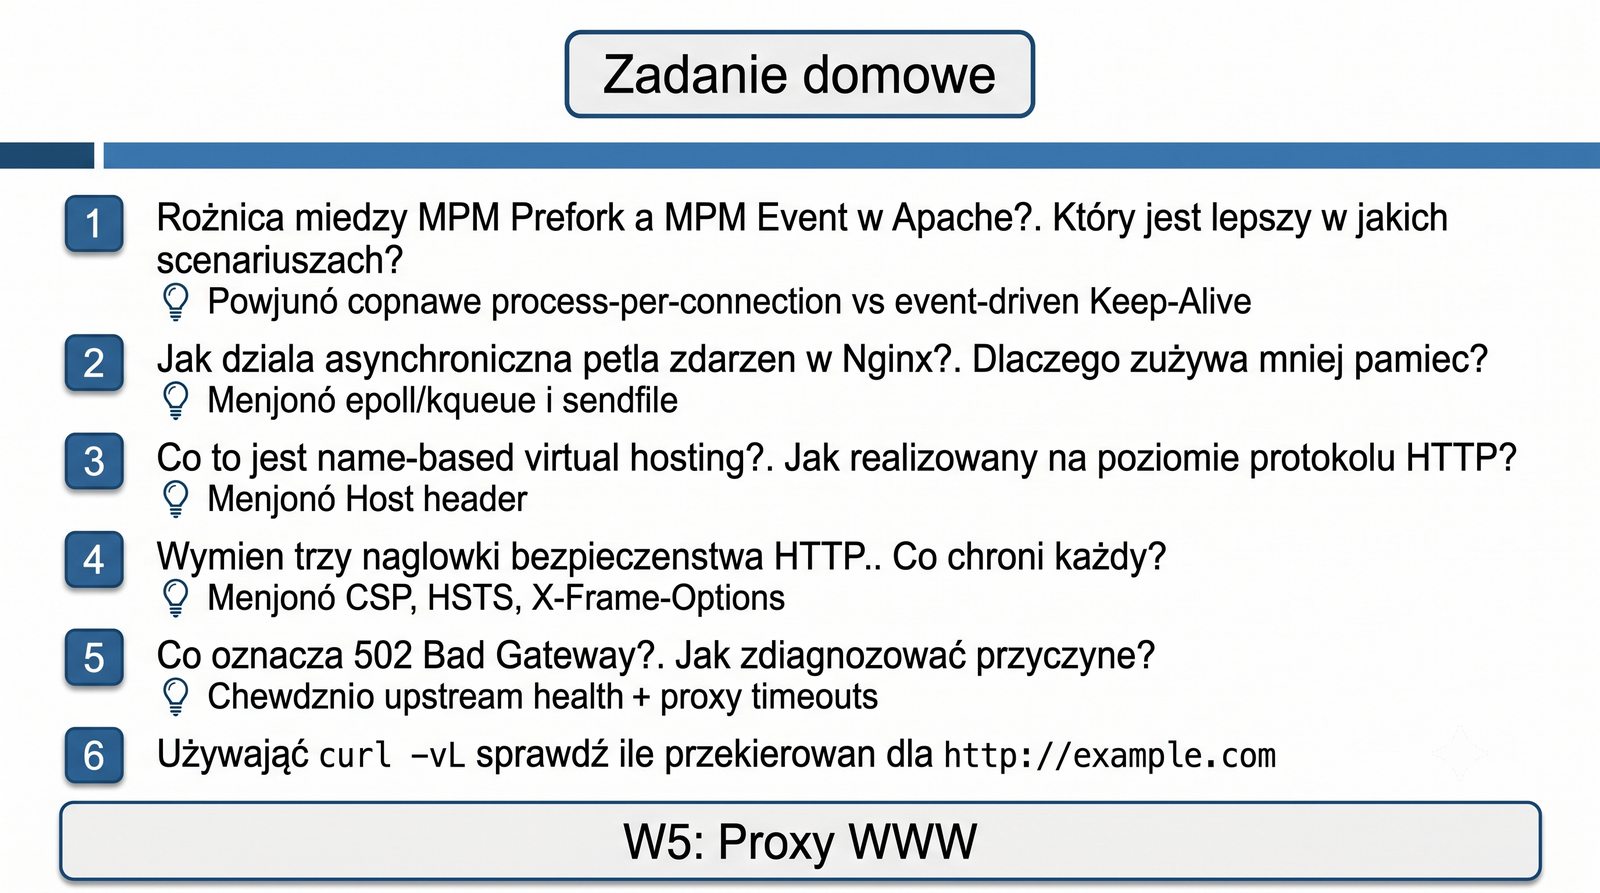
Zadanie domowe