1/50
Proxy WWW – Reverse Proxy i Forward Proxy
Cel slajdu: Slajd omawia zagadnienie „Proxy WWW – Reverse Proxy i Forward Proxy” w kontekście: Rola pośredników w architekturze protokołu HTTP.

Rola pośredników w architekturze protokołu HTTP

Pośrednictwo warstwy aplikacji, buforowanie i równoważenie obciążenia (Load Balancing)

  • Serwer proxy (pośrednik) to węzeł sieciowy pośredniczący w wymianie komunikatów protokołu HTTP/HTTPS pomiędzy klientem a serwerem docelowym, operujący na warstwie 7 (aplikacji) modelu ISO/OSI zgodnie ze standardem RFC 9110.
  • Dwie fundamentalne topologie:
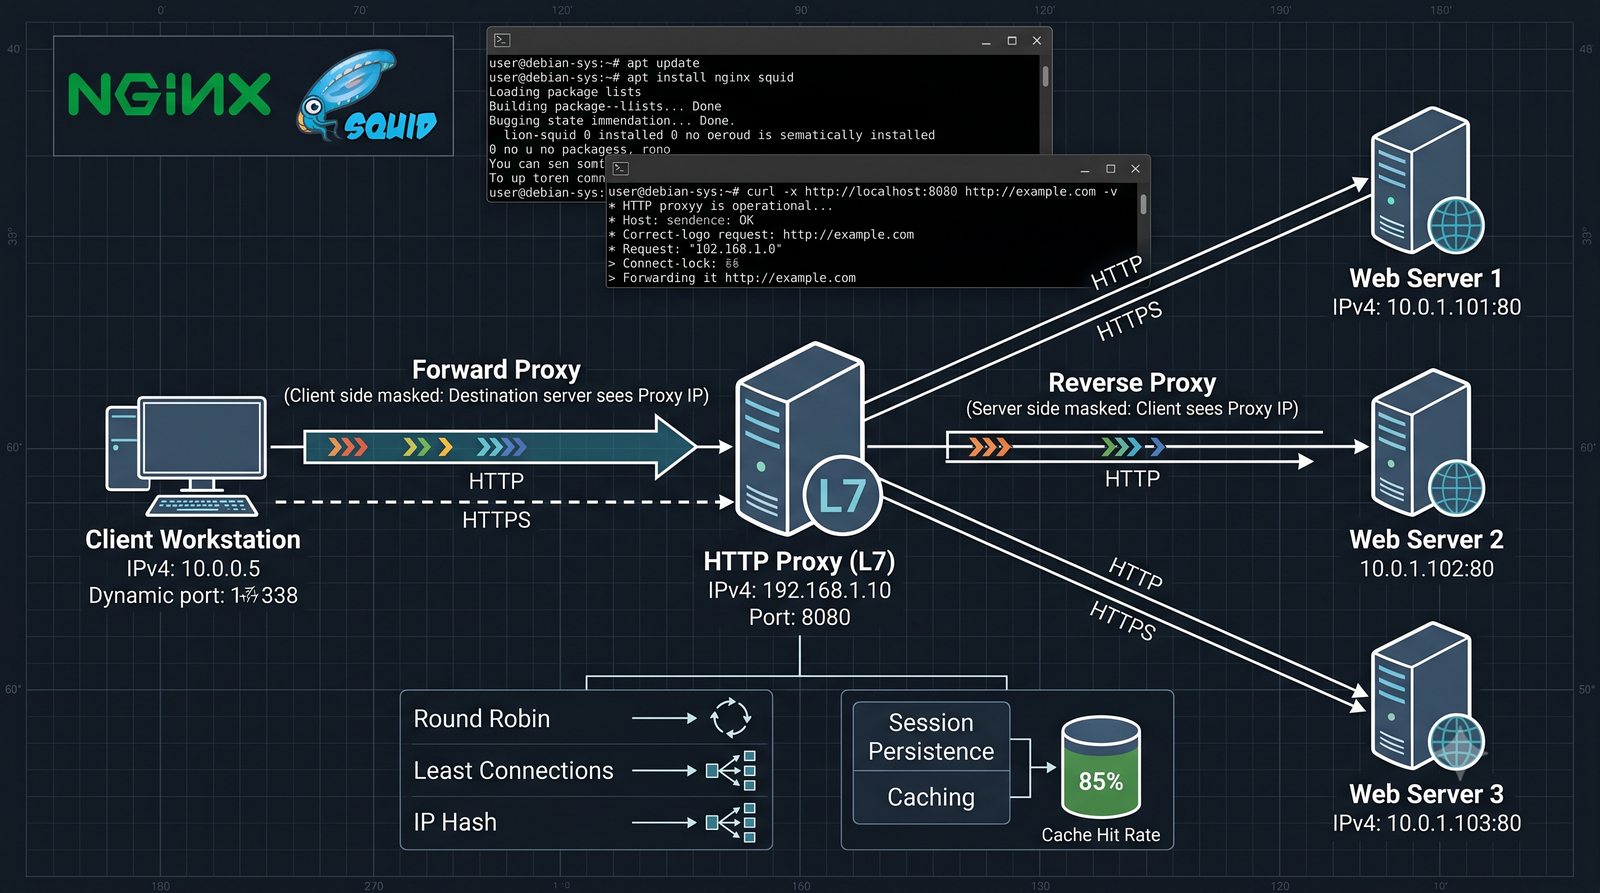
    • Forward Proxy (pośrednik wychodzący): reprezentuje klientów sieci lokalnej (LAN), maskuje ich tożsamość przed serwerami zewnętrznymi, filtruje treść i buforuje zasoby WAN.
    • Reverse Proxy (pośrednik odwrotny): reprezentuje serwery zaplecza (backend), maskuje strukturę wewnętrzną klastra, optymalizuje ruch, terminując połączenia SSL/TLS i równoważąc obciążenie.
  • Niniejszy moduł prezentuje zaawansowane algorytmy równoważenia obciążenia (Round Robin, Least Connections, IP Hash), utrzymywanie spójności sesji (Session Persistence) oraz buforowanie brzegowe (RFC 9111).
  • W części warsztatowej przeprowadzona zostanie konfiguracja serwerów Nginx oraz HAProxy, analiza nagłówków identyfikacyjnych (X-Forwarded-For, Forwarded wg RFC 7239) oraz diagnostyka awarii węzłów zaplecza.
Proxy WWW – Reverse Proxy i Forward Proxy: Slajd przedstawia zagadnienie Rola pośredników w architekturze protokołu HTTP w ramach tematu Proxy WWW – Reverse Proxy i Forward Proxy na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Proxy WWW - grafika tytułowa
2/50
Cel warsztatu
Cel slajdu: Slajd określa wymagane efekty uczenia się, czyli wiedzę i umiejętności, które uczestnik opanuje po zajęciach i laboratorium.

Inżynierskie i operacyjne cele modułu proxy

Architektura, optymalizacja i bezpieczeństwo wejścia aplikacji internetowych

  • Zrozumienie zagadnień rozwiązywanych przez pośredników warstwy L7: bezpieczeństwo, izolacja sieciowa, wysoka dostępność (High Availability) oraz skalowalność horyzontalna.
  • Praktyczne opanowanie konfiguracji serwera Nginx w roli odwrotnego proxy: definicja bloków upstream, dyrektywy proxy_pass, obsługa protokołu WebSocket oraz buforowanie odpowiedzi.
  • Implementacja zaawansowanego równoważenia obciążenia i mechanizmów inspekcji w oprogramowaniu HAProxy: separacja sekcji frontend i backend, aktywny monitoring stanu, czyli okresowe kontrole dostępności (ang. health checks), oraz statystyki operacyjne.
  • Opanowanie metodyki diagnostycznej (troubleshooting): rozwiązywanie problemu utraty adresu źródłowego klienta za pośrednikiem, weryfikacja nagłówków X-Forwarded-For i Forwarded (RFC 7239) oraz izolacja awarii węzłów aplikacyjnych.
Cel warsztatu: Slajd przedstawia zagadnienie Inżynierskie i operacyjne cele modułu proxy w ramach tematu Cel warsztatu na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Cel warsztatu
3/50
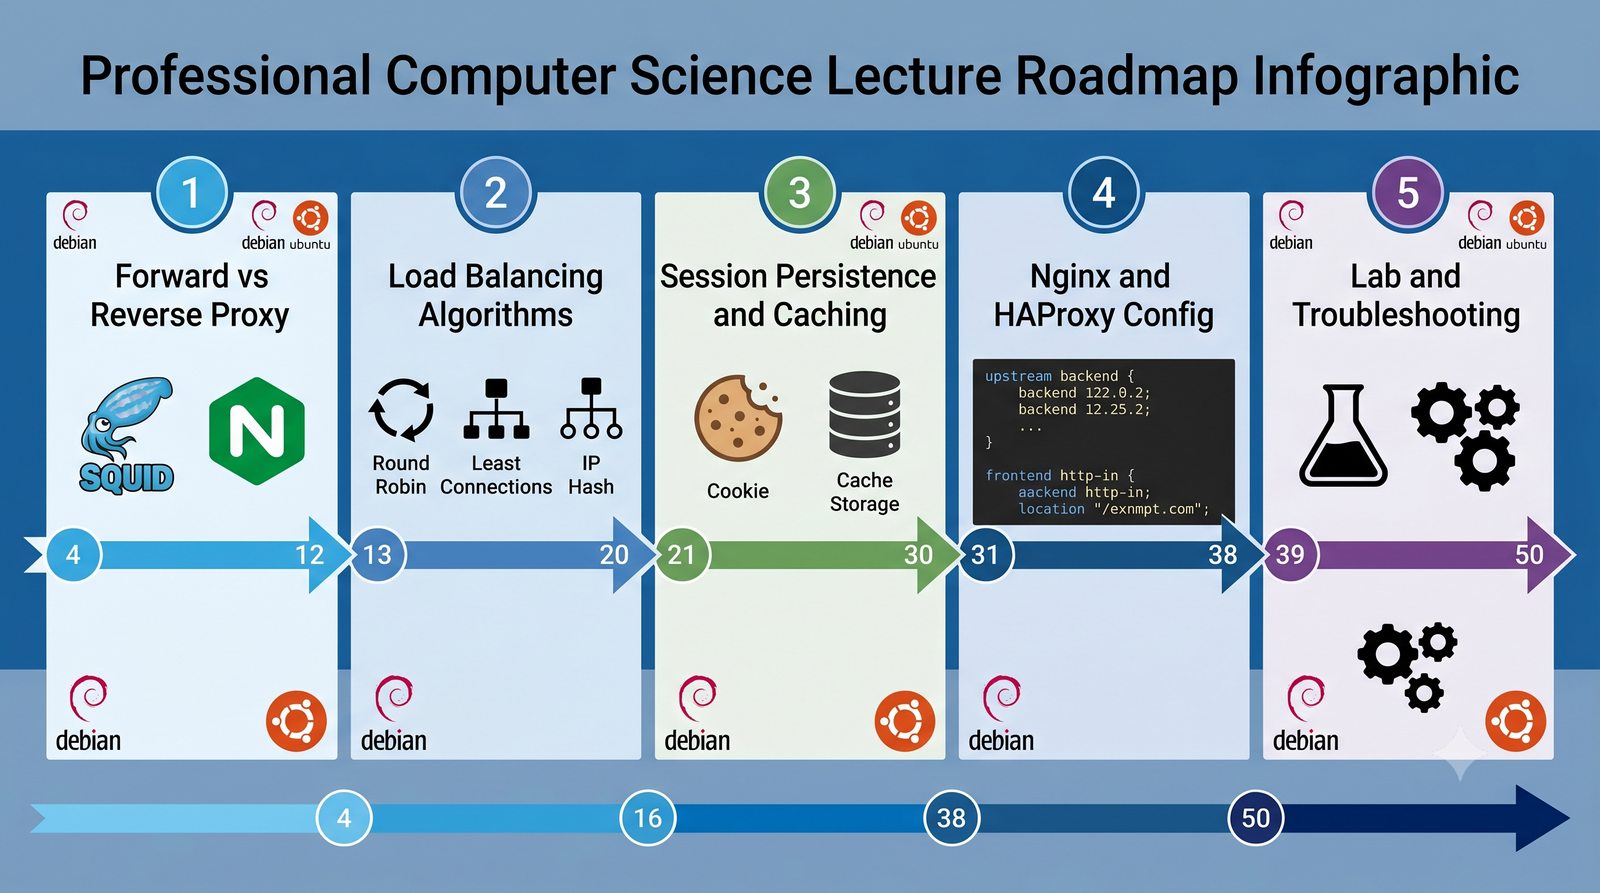
Agenda spotkania
Cel slajdu: Slajd przedstawia kolejność omawianych zagadnień i wskazuje miejsce bieżącego tematu w strukturze wykładu.

Struktura merytoryczna programu szkoleniowego

Pięć zintegrowanych bloków tematycznych od teorii do wdrożeń laboratoryjnych

  • Blok I (slajdy 4–12): Fundamenty pośrednictwa L7 – różnice architektoniczne między Forward Proxy a Reverse Proxy, mechanizmy kontroli dostępu w serwerze Squid oraz topologie sieciowe.
  • Blok II (slajdy 13–20): Skalowanie horyzontalne i algorytmy równoważenia obciążenia (Load Balancing L4 vs L7) – Round Robin, Weighted Round Robin, Least Connections, IP Hash oraz system decyzyjny.
  • Blok III (slajdy 21–30): Zarządzanie stanem i optymalizacja wydajności – lepkość sesji (Sticky Sessions, cookie insert), buforowanie brzegowe HTTP (RFC 9111), wzorce TTL oraz terminacja TLS/SSL.
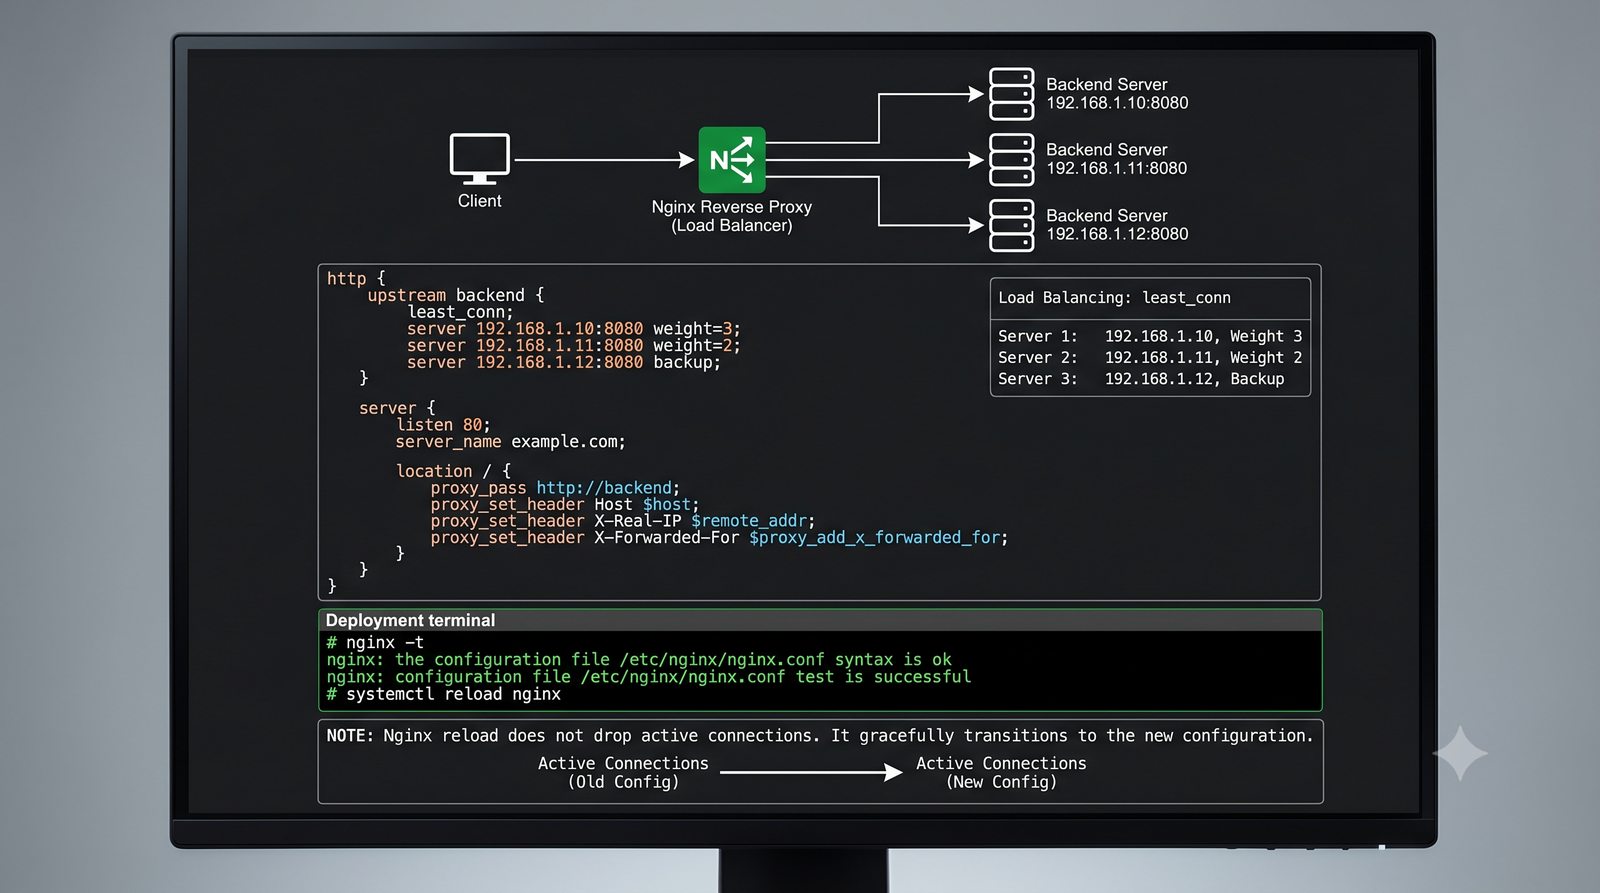
  • Blok IV (slajdy 31–38): Wdrożenia serwerowe – konfiguracja Nginx (upstream, proxy_pass, WebSockets), architektura blokowa HAProxy (frontend, backend) oraz monitoring telemetryczny.
  • Blok V (slajdy 39–50): Laboratorium wdrożeniowe i metodyka troubleshooting – uruchomienie klastra, testy obciążeniowe, nagłówki identyfikacyjne (X-Forwarded-For, RFC 7239), diagnostyka awarii i zestawienie dyrektyw administratora.
Agenda spotkania: Slajd przedstawia zagadnienie Struktura merytoryczna programu szkoleniowego w ramach tematu Agenda spotkania na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Agenda spotkania
4/50
Model komunikacji bez pośrednika
Cel slajdu: Slajd omawia zagadnienie „Model komunikacji bez pośrednika” w kontekście: Bezpośrednia relacja klient–serwer i jej ograniczenia.

Bezpośrednia relacja klient–serwer i jej ograniczenia

Scenariusz bazowy komunikacji w architekturze punkt–punkt

  • Bezpośrednie nawiązanie połączenia: klient (przeglądarka) rozwiązuje nazwę FQDN serwera w systemie DNS, uzyskując jego publiczny adres IP, po czym nawiązuje połączenie TCP w trzech krokach, tzw. three-way handshake (SYN, SYN-ACK, ACK), bezpośrednio z maszyną docelową.
  • Pełne obciążenie serwera aplikacyjnego: pojedynczy serwer WWW/aplikacji musi we własnym zakresie obsłużyć:
    • negocjację kryptograficzną TLS (kosztowny obliczeniowo handshake asymetryczny RSA/ECDHE);
    • utrzymywanie otwartych gniazd sieciowych dla tysięcy jednoczesnych klientów;
    • serwowanie statycznych zasobów (HTML, CSS, JS, grafika) oraz generowanie dynamicznego kodu.
  • Pojedynczy punkt awarii (Single Point of Failure – SPOF): awaria sprzętowa, błąd oprogramowania lub przeciążenie jednego węzła skutkuje całkowitą niedostępnością usługi dla użytkowników.
  • Brak elastyczności i ochrony: publiczny adres IP serwera jest bezpośrednio wyeksponowany na ataki wolumetryczne DDoS oraz skanowanie podatności.
Model komunikacji bez pośrednika: Slajd przedstawia zagadnienie Bezpośrednia relacja klient–serwer i jej ograniczenia w ramach tematu Model komunikacji bez pośrednika na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
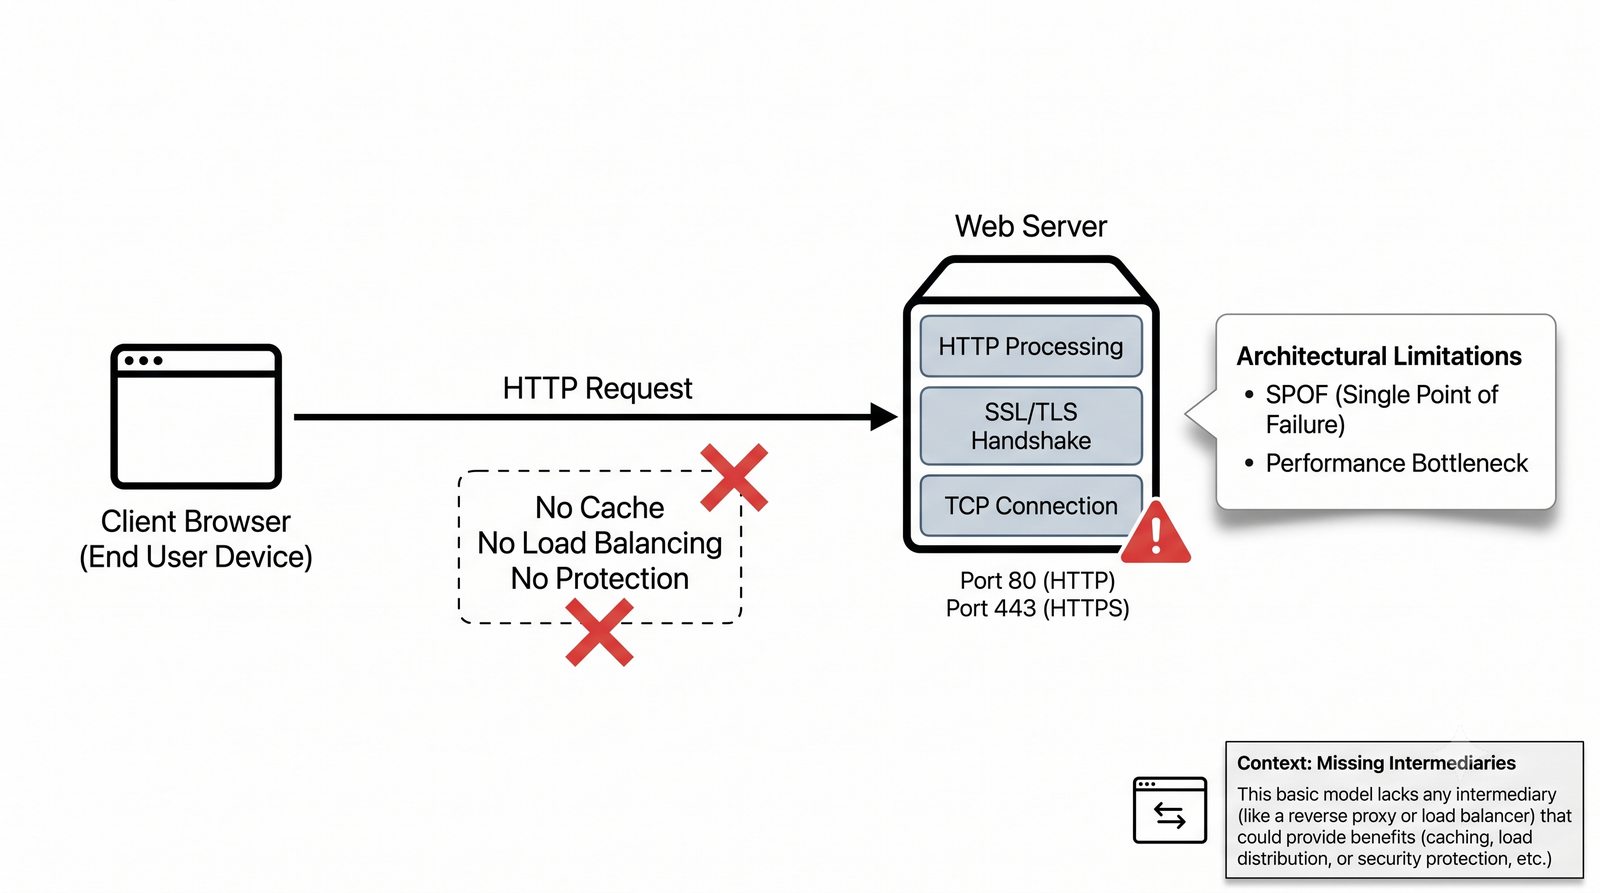
Model komunikacji bez pośrednika
5/50
Czym jest proxy na warstwie 7?
Cel slajdu: Slajd omawia zagadnienie „Czym jest proxy na warstwie 7?” w kontekście: Pośrednik o pełnej świadomości semantyki protokołu HTTP.

Pośrednik o pełnej świadomości semantyki protokołu HTTP

Różnice w działaniu urządzeń trasujących i pośredników aplikacyjnych

  • Definicja wg RFC 9110: proxy to program pośredniczący w architekturze klient–serwer, który działa zarówno jako serwer (odbierając żądania od klienta), jak i jako klient (wysyłając żądania do serwera docelowego).
  • Rozdzielenie połączeń TCP (Dual-Leg Connection):
    • Połączenie 1 (Front-end): Klient ↔ Serwer Proxy (odrębna sesja TCP, własne parametry MTU, RTT i bufor gniazda).
    • Połączenie 2 (Back-end): Serwer Proxy ↔ Serwer Docelowy (niezależna, zoptymalizowana sesja TCP w sieci lokalnej).
  • Pełna inspekcja L7: pośrednik parsuje metodę HTTP (GET, POST, PUT), ścieżkę URI, nagłówki (Host, User-Agent, Cookie) oraz treść wiadomości, co umożliwia inteligentny routing i filtrację.
  • Przykłady oprogramowania: Nginx, HAProxy, Envoy Proxy, Traefik, Apache HTTP Server (z modułami mod_proxy i mod_proxy_balancer) oraz Squid.
Czym jest proxy na warstwie 7?: Slajd przedstawia zagadnienie Pośrednik o pełnej świadomości semantyki protokołu HTTP w ramach tematu Czym jest proxy na warstwie 7? na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
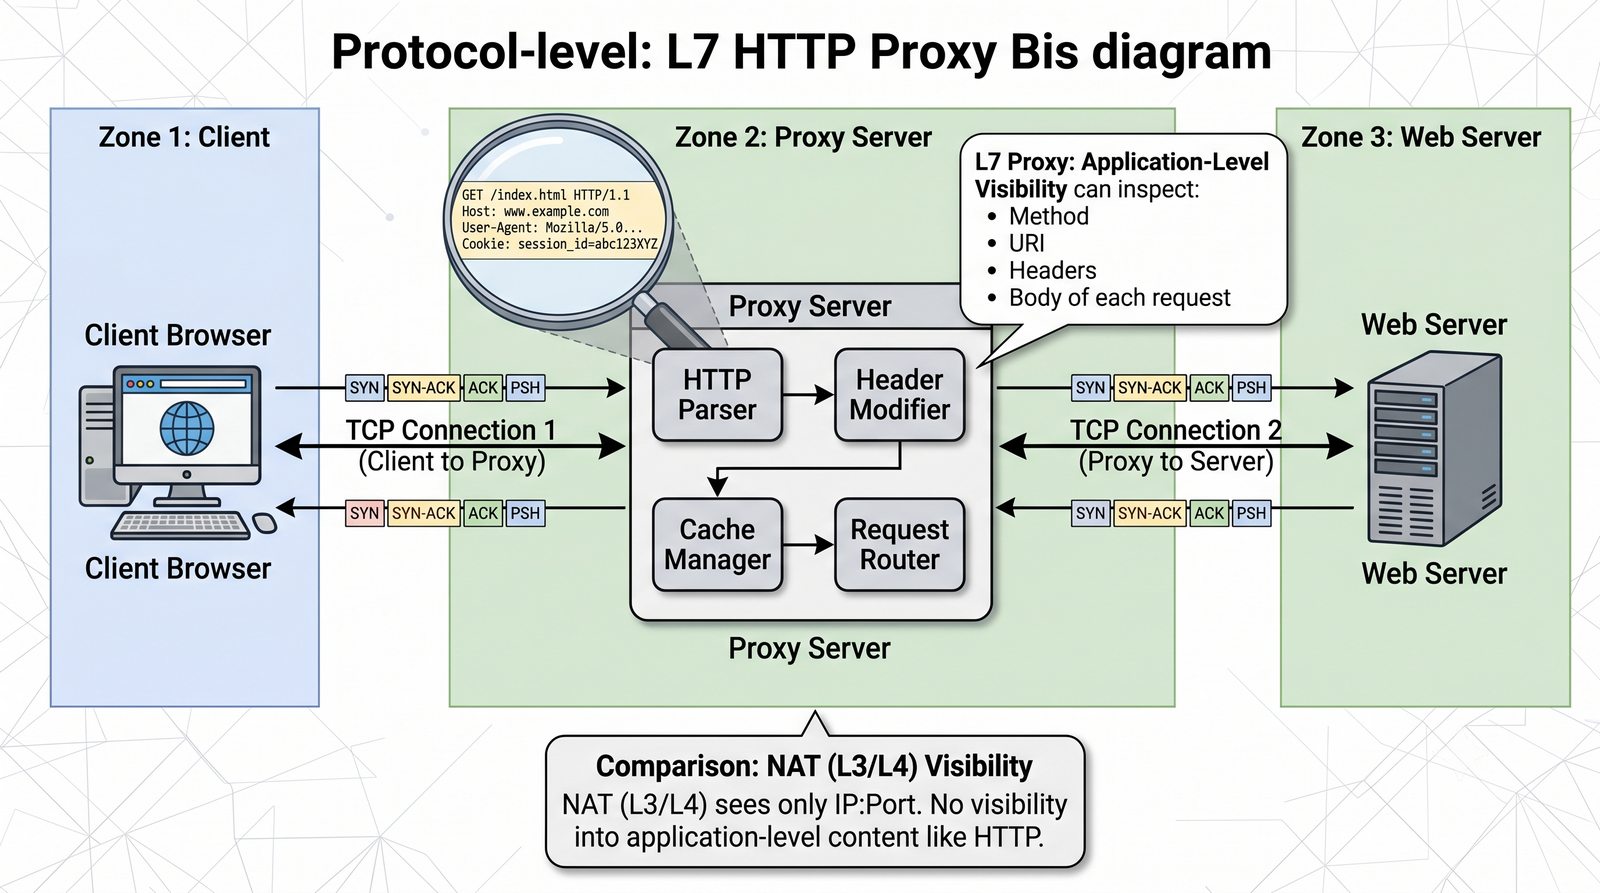
Czym jest proxy na warstwie 7?
6/50
Topologia: Forward Proxy (Pośrednik wychodzący)
Cel slajdu: Slajd omawia zagadnienie „Topologia: Forward Proxy (Pośrednik wychodzący)” w kontekście: Architektura ochrony i kontroli ruchu wychodzącego z sieci LAN.

Architektura ochrony i kontroli ruchu wychodzącego z sieci LAN

Reprezentacja klientów wewnętrznych wobec zewnętrznych usług sieci Internet

  • Kierunek pośrednictwa: obsługa ruchu wychodzącego z chronionej sieci lokalnej (LAN / Enterprise) do publicznej sieci Internet.
  • Maskowanie tożsamości klienta: zewnętrzne serwery WWW widzą wyłącznie adres IP serwera proxy; wewnętrzna adresacja IP stacji roboczych pozostaje całkowicie ukryta.
  • Metody wdrożenia w infrastrukturze:
    • Jawne (Explicit Proxy): ręczna konfiguracja adresu proxy i portu w systemie operacyjnym lub przeglądarce klienta; często automatyzowana za pomocą skryptów PAC (Proxy Auto-Configuration) oraz protokołu WPAD (Web Proxy Auto-Discovery) dystrybuowanego przez DHCP/DNS.
    • Przezroczyste (Transparent / Interception Proxy): ruchu HTTP/HTTPS jest przechwytywany na bramie domyślnej routera za pomocą reguł zapory ogniowej (np. sudo iptables -t nat -A PREROUTING -p tcp --dport 80 -j REDIRECT --to-port 3128; w MikroTik RouterOS odpowiednikiem jest /ip firewall nat add chain=dstnat dst-port=80 protocol=tcp action=redirect to-ports=8080) i przekierowywany do proxy bez konieczności rekonfiguracji urządzeń końcowych. Tryb TPROXY jest rozwiązaniem zaawansowanym i wymaga dodatkowej konfiguracji routingu.
  • Główne funkcje: egzekwowanie polityk dostępu (blokowanie witryn niepożądanych), audyt aktywności, centralne buforowanie oraz ochrona antywirusowa pobieranych plików.
Topologia: Forward Proxy (Pośrednik wychodzący): Forward Proxy, czyli pośrednik wychodzący: Slajd przedstawia zagadnienie Architektura ochrony i kontroli ruchu wychodzącego z sieci LAN w ramach tematu Topologia: Forward Proxy (Pośrednik wychodzący) na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
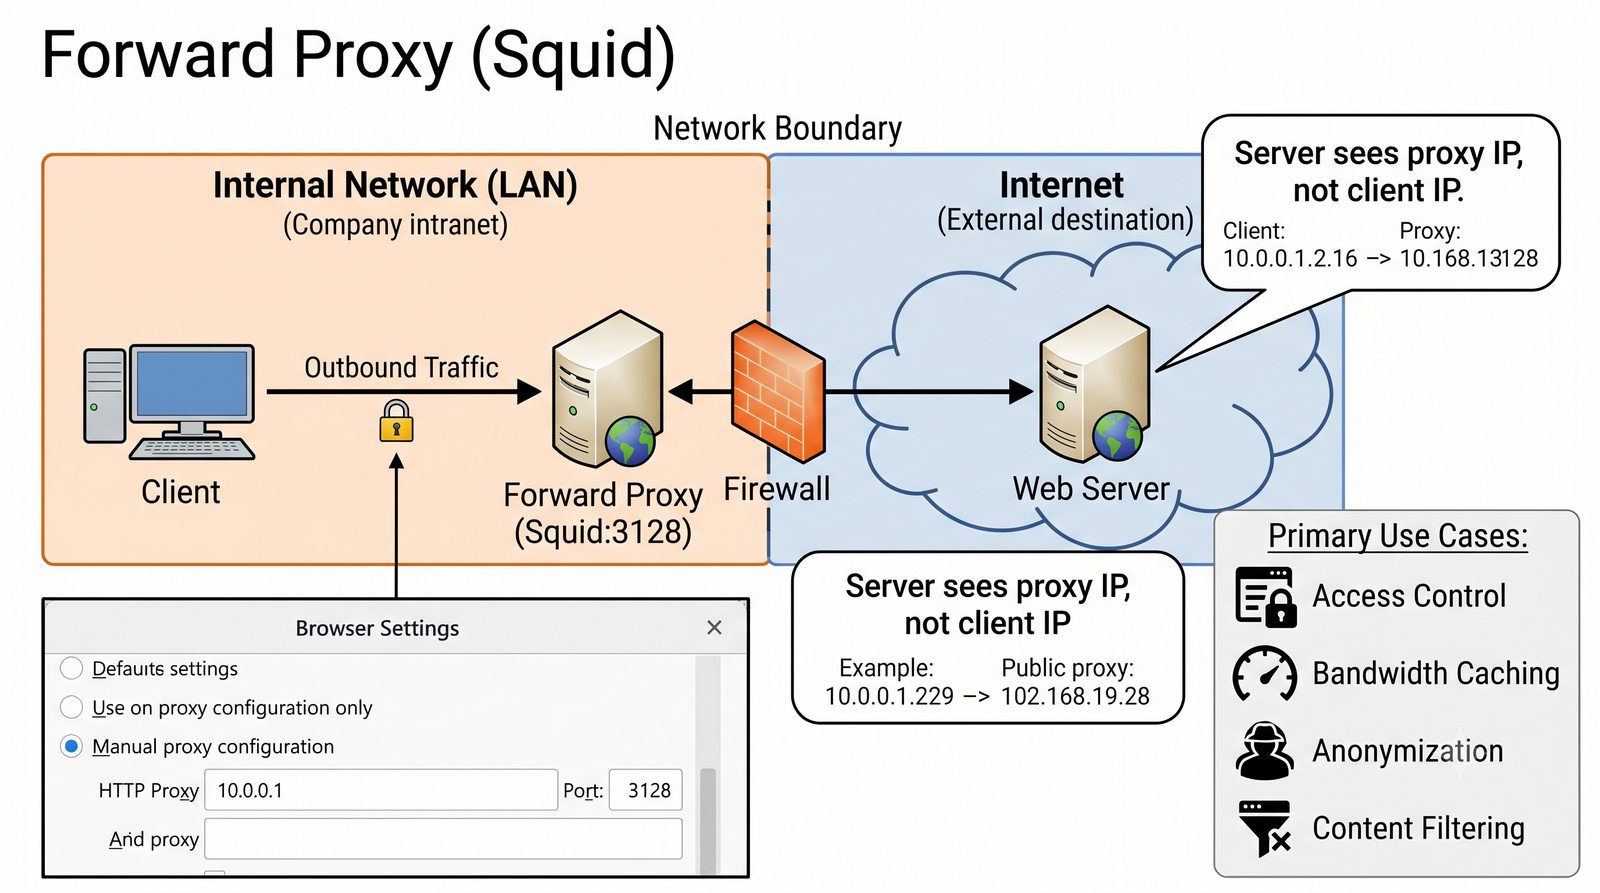
Topologia: Forward Proxy (Pośrednik wychodzący)
7/50
Forward Proxy w praktyce – Squid jako system kontroli i buforowania
Cel slajdu: Slajd omawia zagadnienie „Forward Proxy w praktyce – Squid jako system kontroli i buforowania” w kontekście: Implementacja reguł ACL, buforowanie i obsługa protokołu HTTPS w serwerze Squid.

Implementacja reguł ACL, buforowanie i obsługa protokołu HTTPS w serwerze Squid

Konfiguracja reguł dostępu, pamięci podręcznej i tunelowania połączeń szyfrowanych

  • Serwer Squid: wiodące oprogramowanie open-source dla węzłów Forward Proxy, oferujące wielopoziomowe listy kontroli dostępu (ACL) oraz zaawansowaną pamięć podręczną na dysku i w pamięci RAM.
  • Architektura list ACL (Access Control Lists):
    • Definicja kryteriów: adres źródłowy klienta (src), domena docelowa (dstdomain), ramy czasowe (time), typ MIME (rep_mime_type).
    • Kolejność przetwarzania: dyrektywy http_access allow/deny sprawdzane są sekwencyjnie od góry do dołu (reguła pierwszego dopasowania; na końcu zalecane domyślne http_access deny all).
  • Obsługa ruchu szyfrowanego HTTPS:
    • Tunelowanie ślepe (HTTP CONNECT wg RFC 9110): proxy zestawia tunel TCP bez wglądu w przesyłaną treść szyfrowaną TLS.
    • Inspekcja SSL (SSL-Bump / MITM): proxy deszyfruje ruch w celach analitycznych przy użyciu własnego, zaufanego certyfikatu lokalnego urzędu certyfikacji (CA).
  • Diagnostyka i statystyki (po instalacji pakietu squid): analiza pliku zdarzeń sudo tail -f /var/log/squid/access.log (znaczniki TCP_HIT, TCP_MISS, TCP_DENIED) oraz narzędzie squidclient, np. squidclient -h 127.0.0.1 -p 3128 mgr:info.
Forward Proxy w praktyce – Squid jako system kontroli i buforowania: Slajd przedstawia zagadnienie Implementacja reguł ACL, buforowanie i obsługa protokołu HTTPS w serwerze Squid w ramach tematu Forward Proxy w praktyce – Squid jako system kontroli i buforowania na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
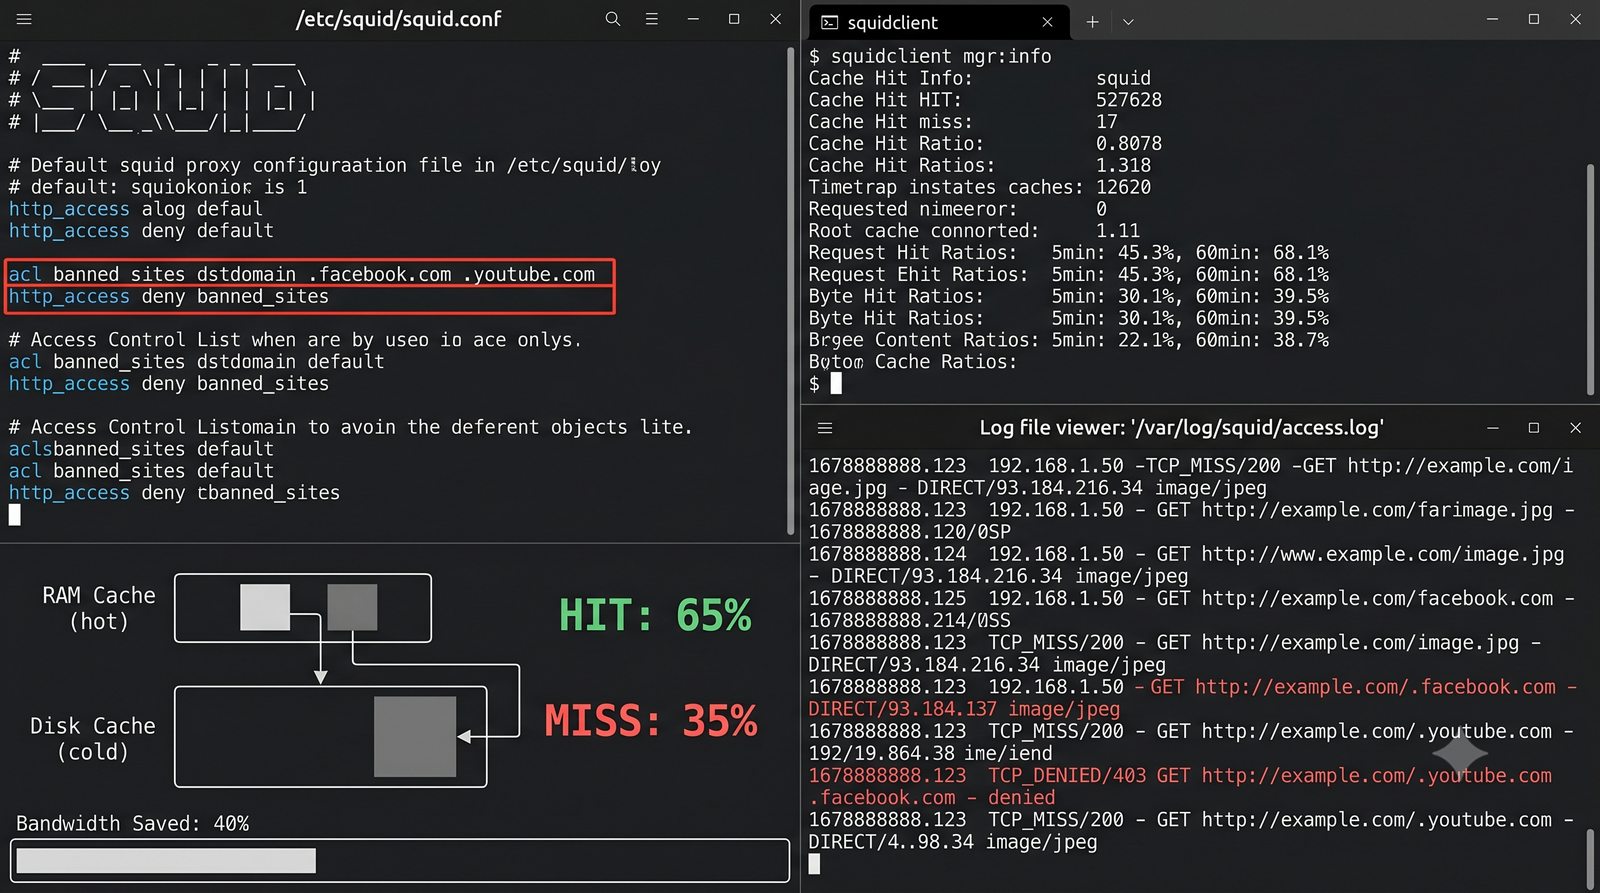
Forward Proxy w praktyce - Squid jako kontrola pracownika
8/50
Topologia: Reverse Proxy (Pośrednik odwrotny)
Cel slajdu: Slajd omawia zagadnienie „Topologia: Reverse Proxy (Pośrednik odwrotny)” w kontekście: Architektura bramy wejściowej i ochrony serwerów zaplecza.

Architektura bramy wejściowej i ochrony serwerów zaplecza

Reprezentacja serwerów wewnętrznych wobec zewnętrznych klientów sieci Internet

  • Kierunek pośrednictwa: obsługa ruchu przychodzącego z publicznego Internetu do wewnętrznych serwerów usługowych (serwerów zaplecza / backendu).
  • Maskowanie infrastruktury wewnętrznej: użytkownik komunikuje się wyłącznie z pojedynczym publicznym adresem IP lub nazwą FQDN serwera proxy; fizyczna liczba, architektura oraz adresy IP maszyn zaplecza pozostają całkowicie ukryte.
  • Separacja stref sieciowych: serwery zaplecza umieszczane są w izolowanych podsieciach prywatnych (DMZ / VLAN), bez trasowania do publicznego Internetu; jedynym węzłem posiadającym do nich dostęp jest reverse proxy.
  • Zintegrowane zadania:
    • równoważenie obciążenia (Load Balancing) pomiędzy wieloma instancjami aplikacji;
    • terminacja szyfrowania SSL/TLS (odciążenie CPU backendu);
    • buforowanie odpowiedzi statycznych i dynamicznych;
    • kompresja danych (gzip, brotli) oraz ochrona przed atakami warstwy 7.
Topologia: Reverse Proxy (Pośrednik odwrotny): Reverse Proxy, czyli pośrednik odwrotny: Slajd przedstawia zagadnienie Architektura bramy wejściowej i ochrony serwerów zaplecza w ramach tematu Topologia: Reverse Proxy (Pośrednik odwrotny) na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
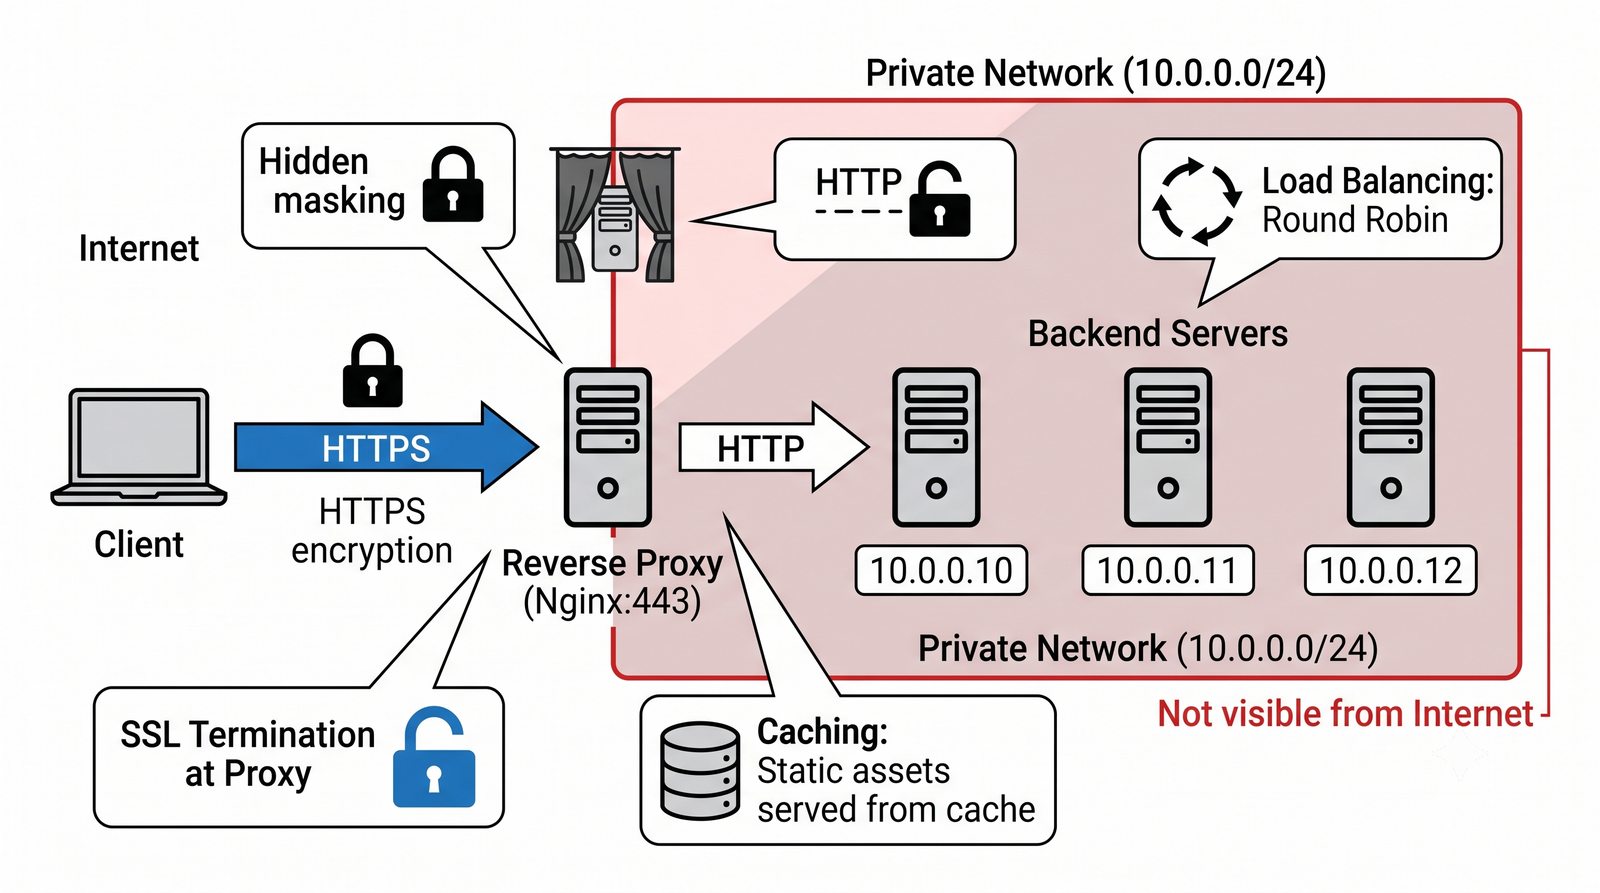
Topologia: Reverse Proxy (Pośrednik odwrotny)
9/50
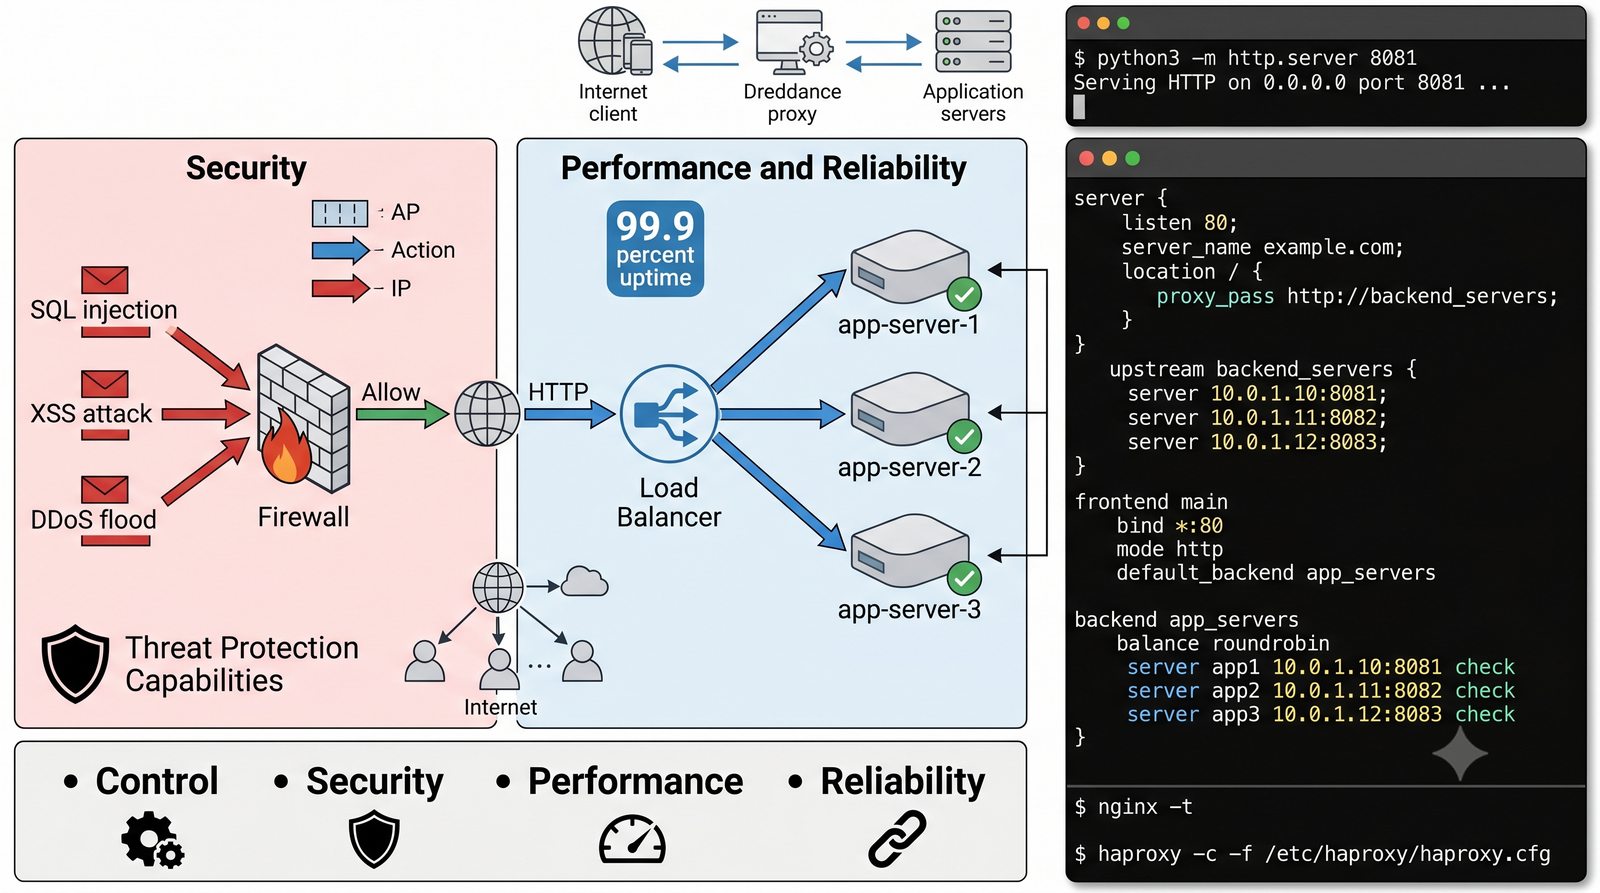
Reverse Proxy jako pierwsza linia obrony
Cel slajdu: Slajd omawia zagadnienie „Reverse Proxy jako pierwsza linia obrony” w kontekście: Mechanizmy bezpieczeństwa, filtracji i odciążenia aplikacji.

Mechanizmy bezpieczeństwa, filtracji i odciążenia aplikacji

Tarcza ochronna chroniąca środowisko wykonawcze przed zagrożeniami sieciowymi

  • Izolacja architektury systemowej: ukrycie stosu technologicznego (wersji interpreterów, frameworków, systemów bazodanowych) oraz struktury wewnętrznych mikroserwisów przed rekonesansem adwersarza.
  • Terminacja kryptograficzna SSL/TLS (Offloading): proxy przejmuje obliczeniowo wymagające operacje kryptograficzne uzgadniania kluczy asymetrycznych (ECDHE, RSA), odciążając procesory serwerów aplikacyjnych.
  • Ograniczanie częstotliwości żądań (Rate Limiting): dławienie nadmiarowego ruchu per źródłowy adres IP klienta lub klucz sesji, chroniące serwery przed atakami typu brute-force oraz scrapingiem zasobów.
  • Web Application Firewall (WAF) i filtracja L7: analiza struktury żądań HTTP pod kątem sygnatur ataków SQL Injection, Cross-Site Scripting (XSS), Path Traversal oraz blokowanie złośliwych botów internetowych.
Reverse Proxy jako pierwsza linia obrony: Slajd przedstawia zagadnienie Mechanizmy bezpieczeństwa, filtracji i odciążenia aplikacji w ramach tematu Reverse Proxy jako pierwsza linia obrony na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
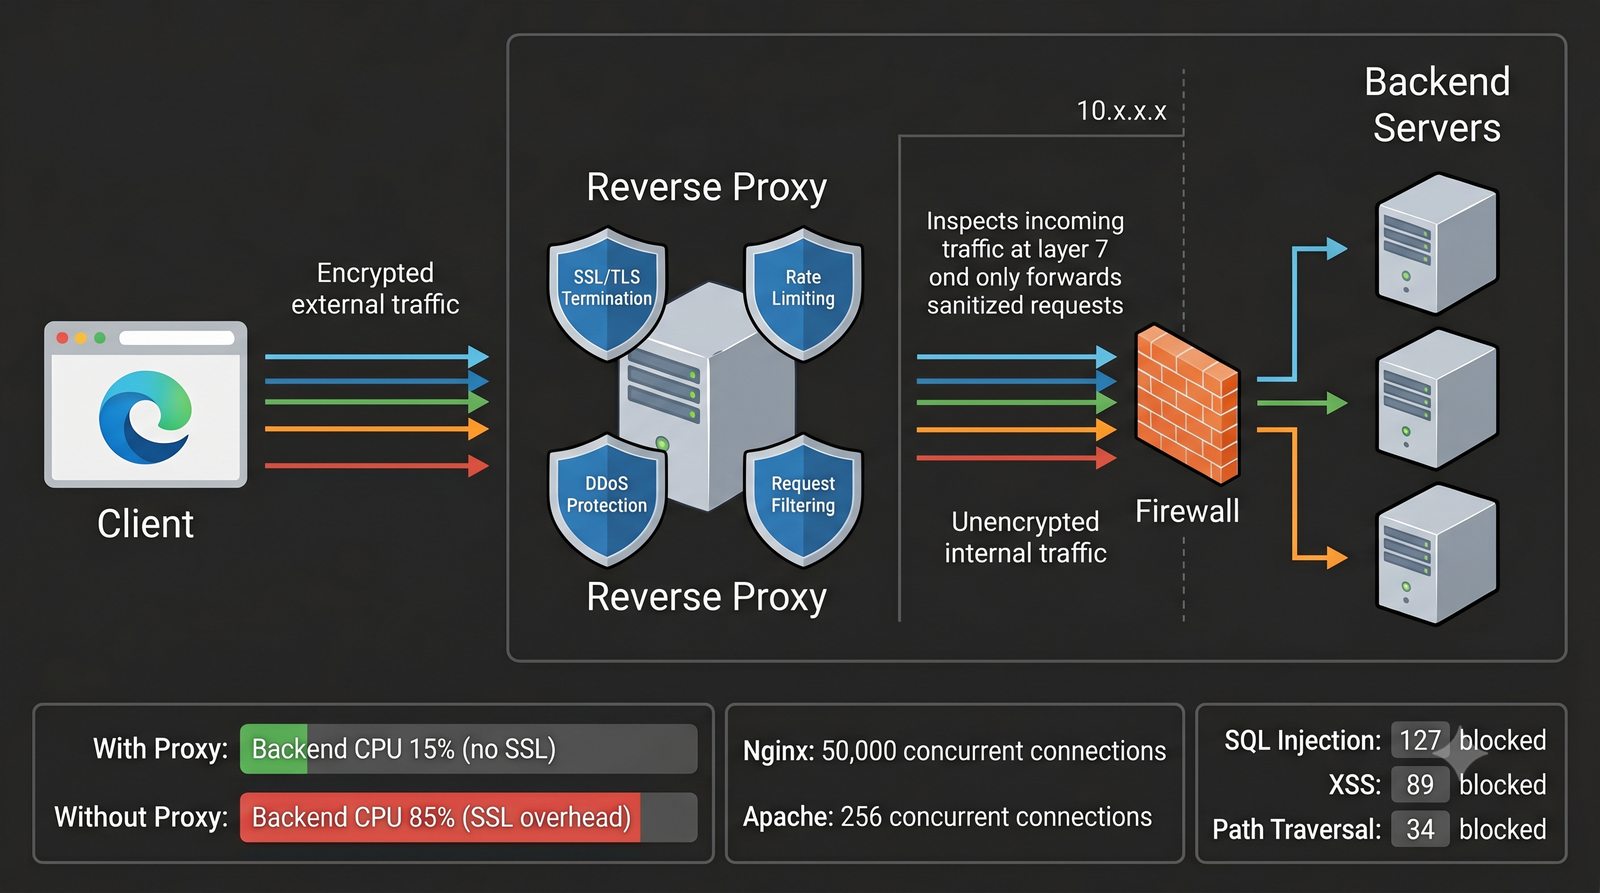
Reverse Proxy jako pierwsza linia obrony
10/50
Forward Proxy vs Reverse Proxy – porównanie
Cel slajdu: Slajd omawia zagadnienie „Forward Proxy vs Reverse Proxy – porównanie” w kontekście: Zestawienie cech architektonicznych i scenariuszy wdrożeniowych.

Zestawienie cech architektonicznych i scenariuszy wdrożeniowych

Syntetyczna analiza porównawcza dwóch wariantów pośrednictwa L7

  • Kryterium Forward Proxy Reverse Proxy
    Kierunek ruchu Wychodzący: LAN → Internet (WAN) Przychodzący: Internet (WAN) → LAN / DMZ
    Kto jest maskowany Klient (serwer widzi wyłącznie IP proxy) Serwery backendu (klient widzi wyłącznie IP proxy)
    Konfiguracja Po stronie klienta (przeglądarka, PAC/WPAD, brama LAN) W infrastrukturze dostawcy (rekordy DNS A/AAAA wskazują na proxy)
    Główny beneficjent Użytkownicy i administratorzy sieci lokalnej Właściciel i użytkownicy usług aplikacyjnych
    Wiodące oprogramowanie Squid, Privoxy, Apache Traffic Server Nginx, HAProxy, Envoy, Traefik, Apache (mod_proxy)
    Zastosowania kluczowe Filtrowanie treści, kontrola ACL, redukcja pasma WAN Load balancing, SSL offloading, ochrona WAF, routing L7
Forward Proxy vs Reverse Proxy – porównanie: Slajd przedstawia zagadnienie Zestawienie cech architektonicznych i scenariuszy wdrożeniowych w ramach tematu Forward Proxy vs Reverse Proxy – porównanie na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
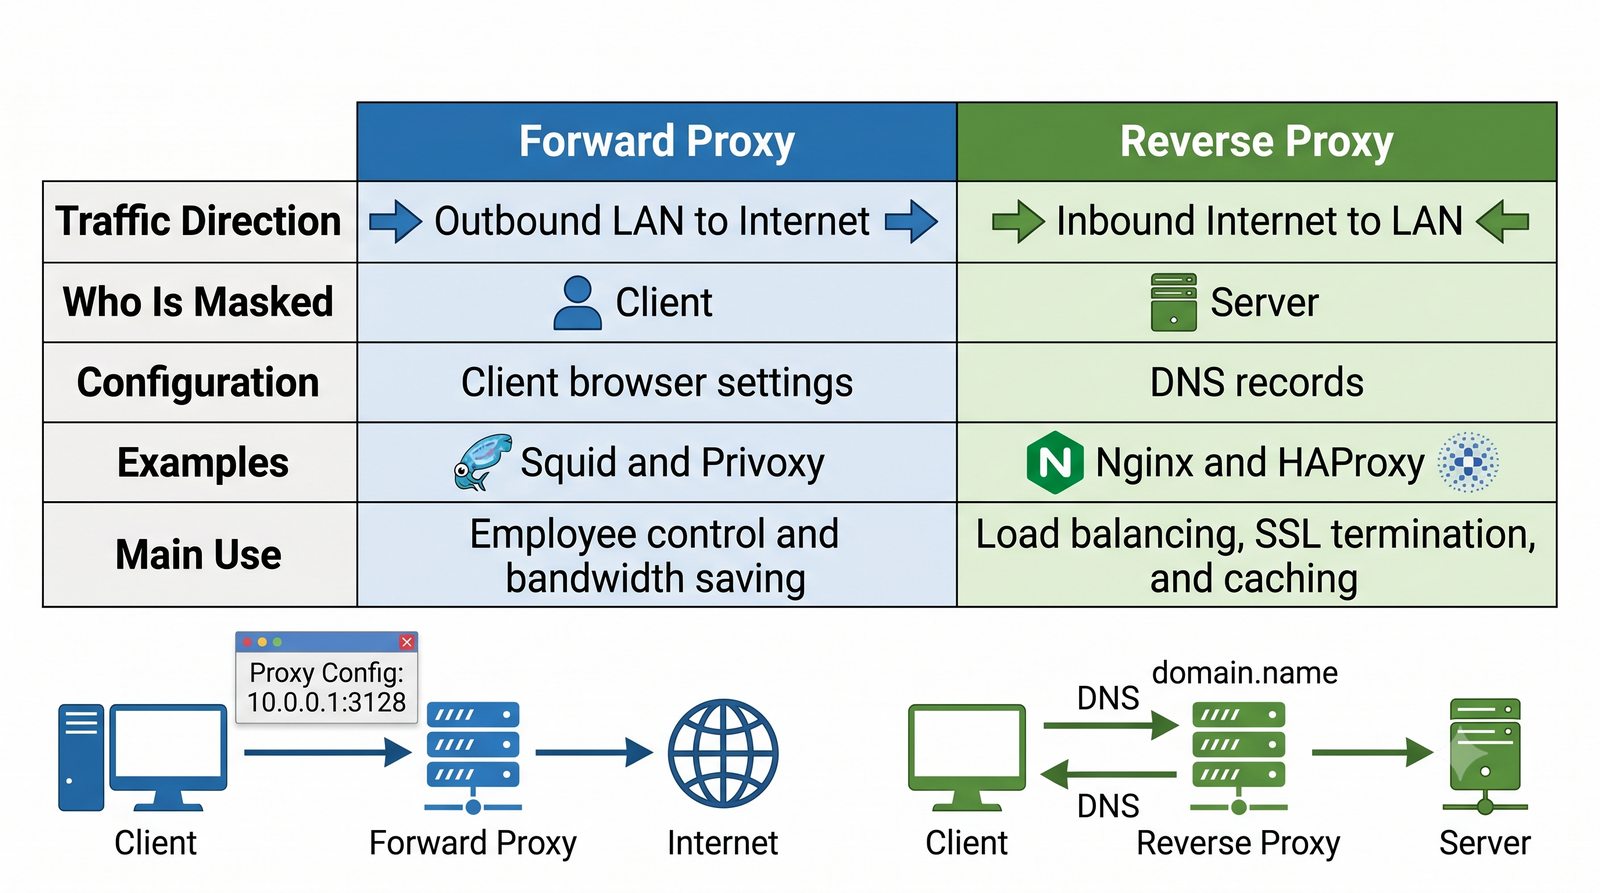
Forward Proxy vs Reverse Proxy - porównanie
11/50
Przepływ ruchu przez Reverse Proxy
Cel slajdu: Slajd omawia zagadnienie „Przepływ ruchu przez Reverse Proxy” w kontekście: Szczegółowa ścieżka przetwarzania żądania klienta.

Szczegółowa ścieżka przetwarzania żądania klienta

Sekwencja zdarzeń na styku Klient → Reverse Proxy → Serwer Zaplecza → Klient

  • Krok 1 (Inicjacja i DNS): Klient rozwiązuje publiczną nazwę domeny w systemie DNS, uzyskując adres IP węzła Reverse Proxy, po czym zestawia sesję TCP i uzgadnia szyfrowanie TLS (port 443).
  • Krok 2 (Terminacja i inspekcja L7): Proxy odbiera i deszyfruje żądanie HTTP, parsuje nagłówki oraz sprawdza lokalną pamięć podręczną (caching wg RFC 9111).
  • Krok 3 (Wybór węzła i enkapsulacja nagłówków): Silnik decyzyjny wybiera serwer zaplecza (backend) według skonfigurowanego algorytmu, wstrzykuje nagłówki tożsamości (X-Forwarded-For, Forwarded wg RFC 7239) i przesyła żądanie niezależnym połączeniem TCP w sieci wewnętrznej.
  • Krok 4 (Obsługa odpowiedzi i kompresja): Serwer aplikacji generuje odpowiedź, którą proxy opcjonalnie zapisuje w buforze, kompresuje (gzip/brotli) i odsyła do klienta w zabezpieczonym kanale TLS.
Przepływ ruchu przez Reverse Proxy: Slajd przedstawia zagadnienie Szczegółowa ścieżka przetwarzania żądania klienta w ramach tematu Przepływ ruchu przez Reverse Proxy na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
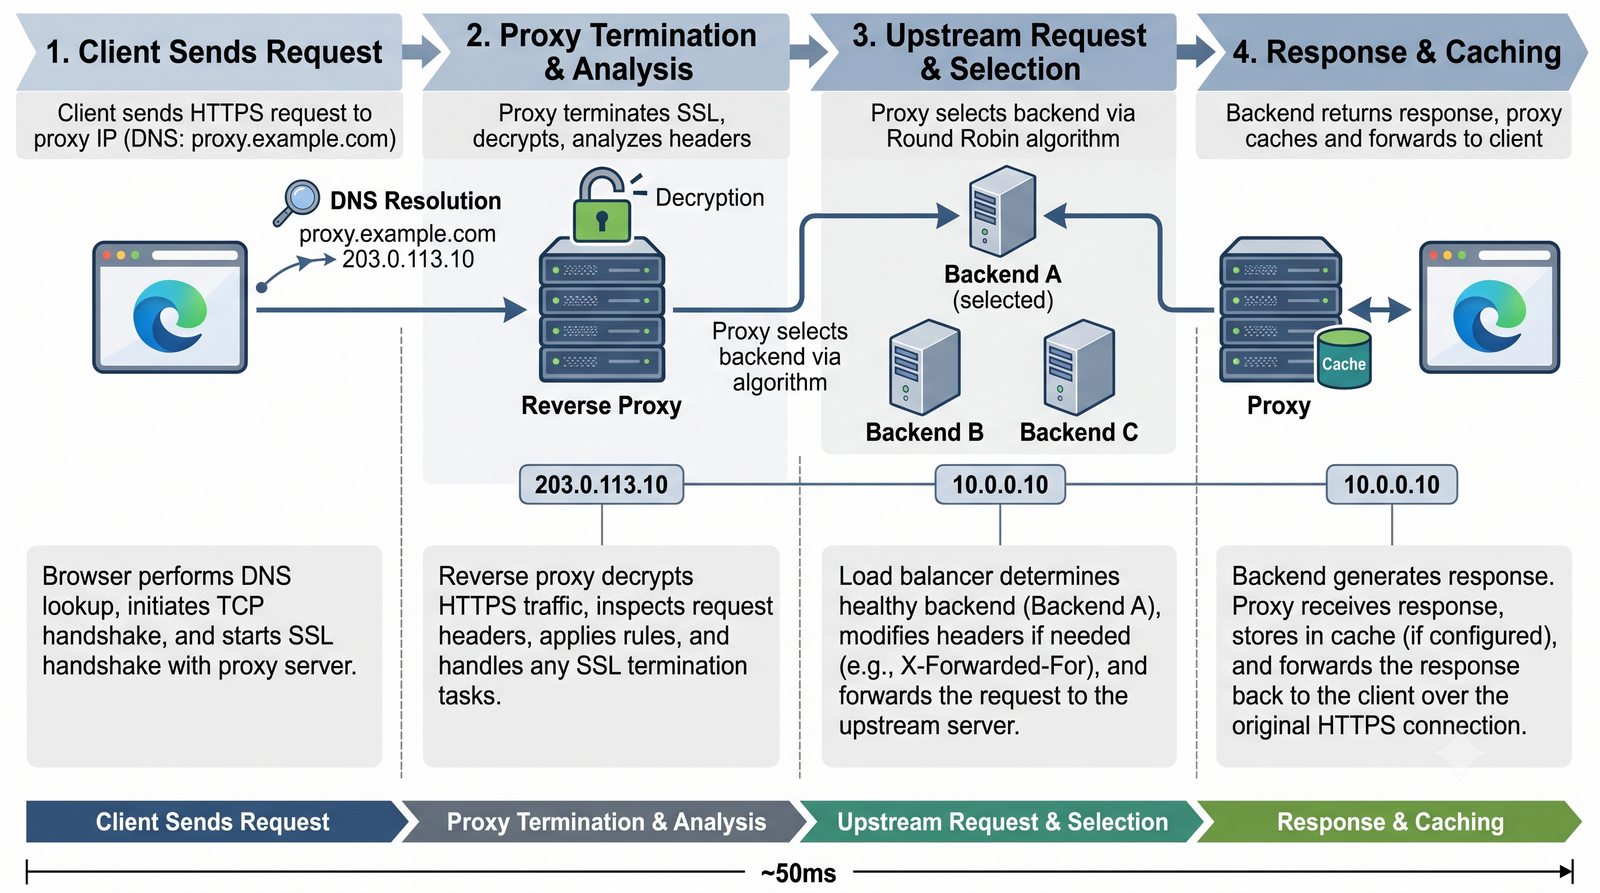
Przepływ ruchu przez Reverse Proxy
12/50
Przepływ ruchu przez Forward Proxy
Cel slajdu: Slajd omawia zagadnienie „Przepływ ruchu przez Forward Proxy” w kontekście: Mechanizmy obsługi żądań jawnych oraz tunelowania HTTPS.

Mechanizmy obsługi żądań jawnych oraz tunelowania HTTPS

Różnice syntaktyczne żądania HTTP oraz obsługa metody CONNECT dla protokołu TLS

  • Jawna konfiguracja pośrednika: stacja robocza posiada zdefiniowany adres IP i port serwera proxy; w żądaniu HTTP klient przesyła pełny identyfikator URI, czyli adres absolutny (ang. Absolute-URI): GET http://www.example.com/index.html HTTP/1.1 zamiast ścieżki względnej.
  • Tunelowanie połączeń szyfrowanych (HTTP CONNECT):
    • W przypadku protokołu HTTPS klient nie może wysłać jawnego żądania GET do obcego serwera; wysyła żądanie: CONNECT www.example.com:443 HTTP/1.1.
    • Proxy nawiązuje połączenie TCP z serwerem docelowym na porcie 443 i odpowiada kodem 200 Connection Established.
    • Od tego momentu proxy staje się transparentnym przekaźnikiem strumienia bajtów TCP (ang. blind tunnel).
  • Filtracja i kontrola: weryfikacja reguł ACL na podstawie nagłówka żądania, domeny docelowej lub rozszerzenia TLS SNI (Server Name Indication).
  • Buforowanie i oszczędność łącza: powtarzalne zasoby nieszyfrowane pobierane są z lokalnej pamięci podręcznej węzła pośredniczącego.
Przepływ ruchu przez Forward Proxy: Slajd przedstawia zagadnienie Mechanizmy obsługi żądań jawnych oraz tunelowania HTTPS w ramach tematu Przepływ ruchu przez Forward Proxy na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
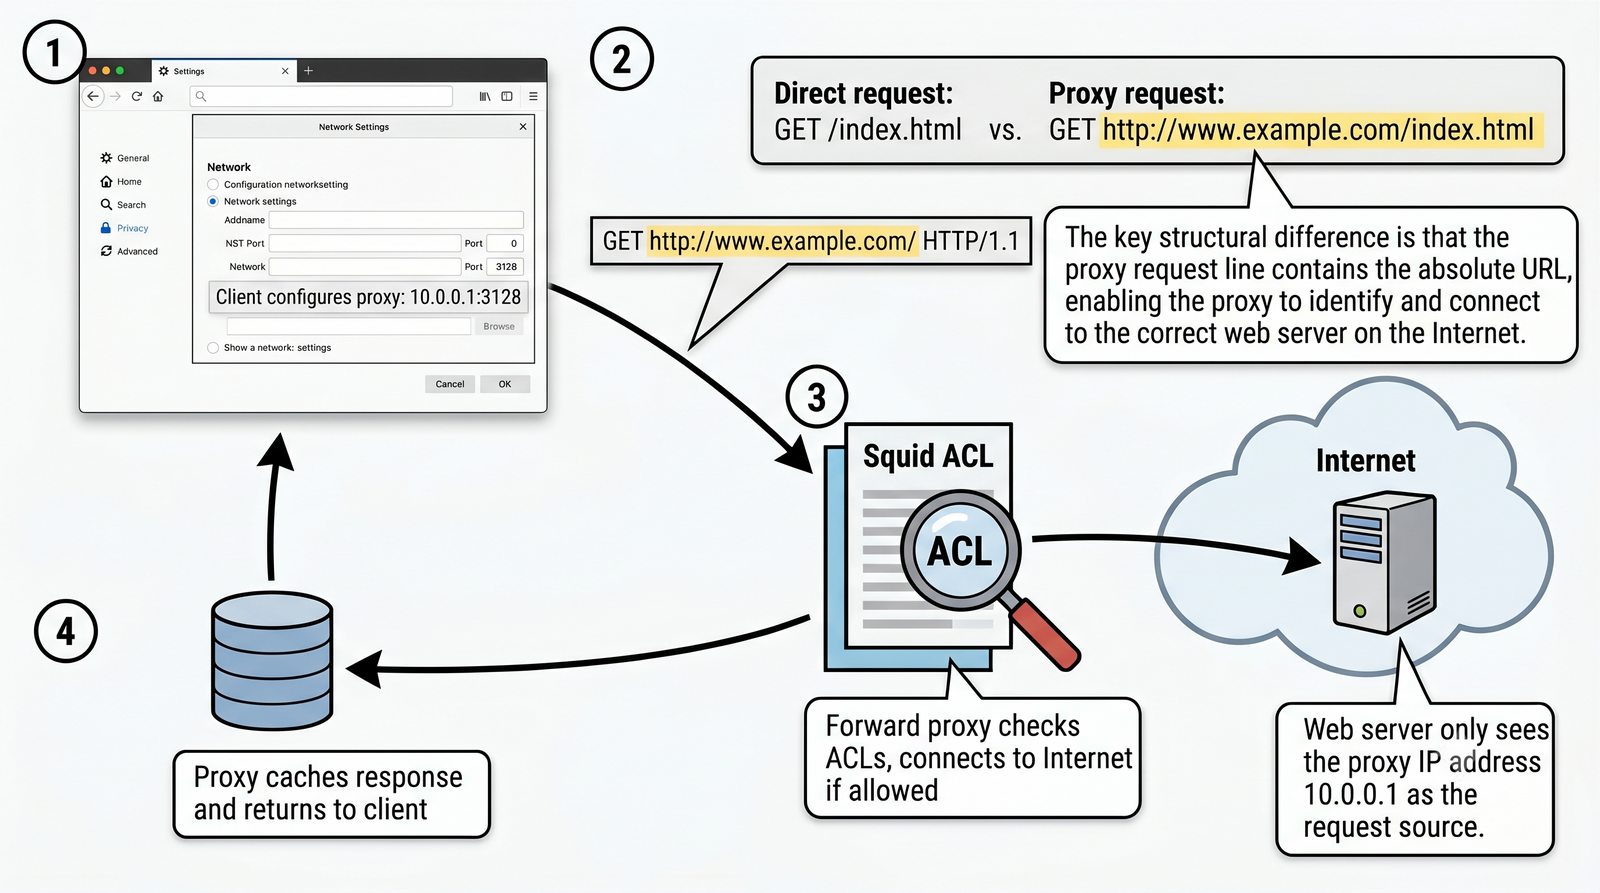
Przepływ ruchu przez Forward Proxy
13/50
Skalowanie poziome – konieczność w nowoczesnej architekturze
Cel slajdu: Slajd omawia zagadnienie „Skalowanie poziome – konieczność w nowoczesnej architekturze” w kontekście: Przewaga klastrów horyzontalnych nad rozbudową pojedynczych maszyn.

Przewaga klastrów horyzontalnych nad rozbudową pojedynczych maszyn

Ewolucja od skalowania pionowego (Scale-Up) do skalowania poziomego (Scale-Out)

  • Ograniczenia skalowania pionowego (Scale-Up):
    • Bariery technologiczne i fizyczne (maksymalna liczba gniazd procesora, kanałów pamięci RAM i szyn PCIe w pojedynczej płycie głównej).
    • Koszty rosnące wykładniczo w stosunku do przyrostu wydajności.
    • Brak odporności na awarie: pojedyncza awaria płyty głównej lub zasilacza paraliżuje całą usługę (SPOF).
    • Konieczność przestoju serwisowego (downtime) podczas każdej modernizacji sprzętowej.
  • Zalety skalowania poziomego (Scale-Out):
    • Dodawanie kolejnych, standardowych węzłów obliczeniowych (serwerów COTS – Commercial Off-The-Shelf) za węzłem równoważącym ruch.
    • Liniowa skalowalność klastra i optymalizacja ekonomiczna infrastruktury.
    • Redundancja N+1 lub N+M: awaria pojedynczego węzła nie powoduje przerwy w działaniu systemu; ruch jest automatycznie kierowany do sprawnych maszyn.
    • Bezprzerwowe wdrażanie aktualizacji oprogramowania (Rolling Updates, Blue-Green Deployment).
Skalowanie poziome – konieczność w nowoczesnej architekturze: Slajd przedstawia zagadnienie Przewaga klastrów horyzontalnych nad rozbudową pojedynczych maszyn w ramach tematu Skalowanie poziome – konieczność w nowoczesnej architekturze na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
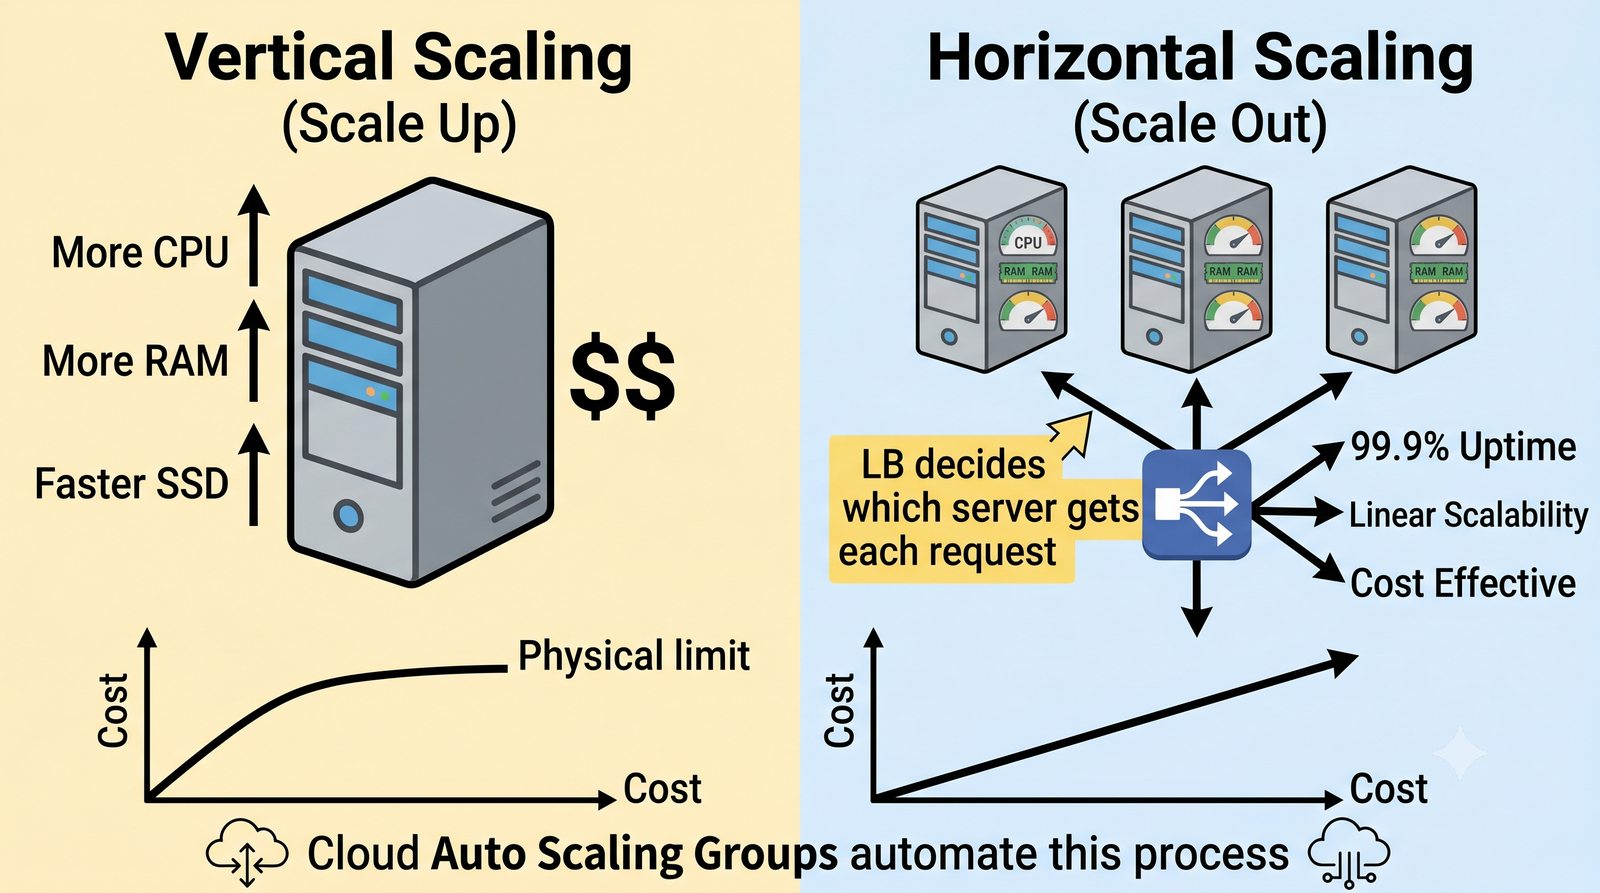
Skalowanie poziome - konieczność w nowoczesnej architekturze
14/50
Load Balancer – klasyfikacja L4 vs L7
Cel slajdu: Slajd omawia zagadnienie „Load Balancer – klasyfikacja L4 vs L7” w kontekście: Porównanie mechanizmów równoważenia w warstwach L4 i L7.

Porównanie mechanizmów równoważenia w warstwach L4 i L7

Dylemat architektoniczny: wydajność transportowa a elastyczność aplikacyjna

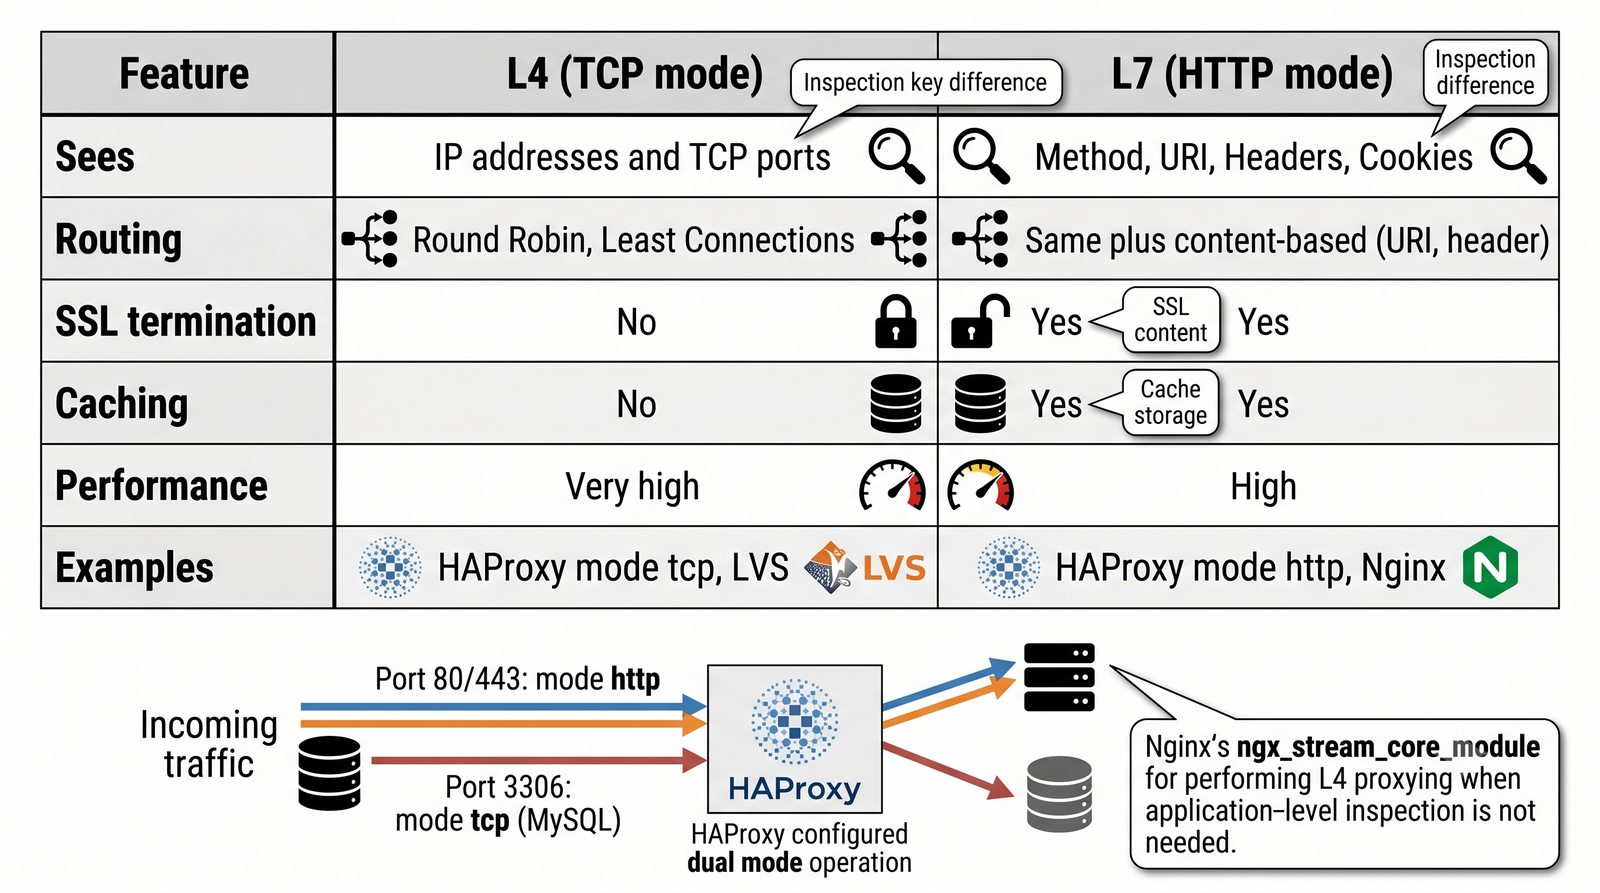
  • Równoważenie w warstwie L4 (Transportowej):
    • Operuje wyłącznie na poziomie nagłówków pakietów IP oraz segmentów TCP/UDP (krotka: adres źródłowy, port źródłowy, adres docelowy, port docelowy).
    • Brak analizy protokołu aplikacyjnego: balancer nie parsuje żądań HTTP ani nie deszyfruje strumienia TLS.
    • Ekstremalna przepustowość i minimalne opóźnienia rzędu mikrosekund; rozwiązania sprzętowe, mechanizmy jądra (IPVS / LVS w Linuksie) lub HAProxy w trybie mode tcp.
    • Zastosowania: bazy danych (PostgreSQL, MySQL), protokoły czasu rzeczywistego (DNS, VoIP, gry online).
  • Równoważenie w warstwie L7 (Aplikacji):
    • Pełna świadomość protokołu HTTP/HTTPS; buforowanie całego żądania i parsowanie jego struktury.
    • Inteligentny routing na podstawie: ścieżki URI (np. /api vs /static), metody, nagłówka Host, ciasteczek sesyjnych czy nagłówków autoryzacyjnych.
    • Obsługa terminacji TLS, kompresji danych, wstrzykiwania nagłówków oraz inspekcji WAF.
    • Większe zapotrzebowanie na zasoby CPU/RAM; wiodące implementacje: Nginx, HAProxy w trybie mode http, Envoy.
Load Balancer – klasyfikacja L4 vs L7: Slajd przedstawia zagadnienie Porównanie mechanizmów równoważenia w warstwach L4 i L7 w ramach tematu Load Balancer – klasyfikacja L4 vs L7 na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
Load Balancer - klasyfikacja L4 vs L7
15/50
Algorytm Round Robin
Cel slajdu: Slajd omawia zagadnienie „Algorytm Round Robin” w kontekście: Cykliczny i deterministyczny rozdział żądań w pierścieniu.

Cykliczny i deterministyczny rozdział żądań w pierścieniu

Klasyczna metoda rotacyjna dla jednorodnych środowisk obliczeniowych

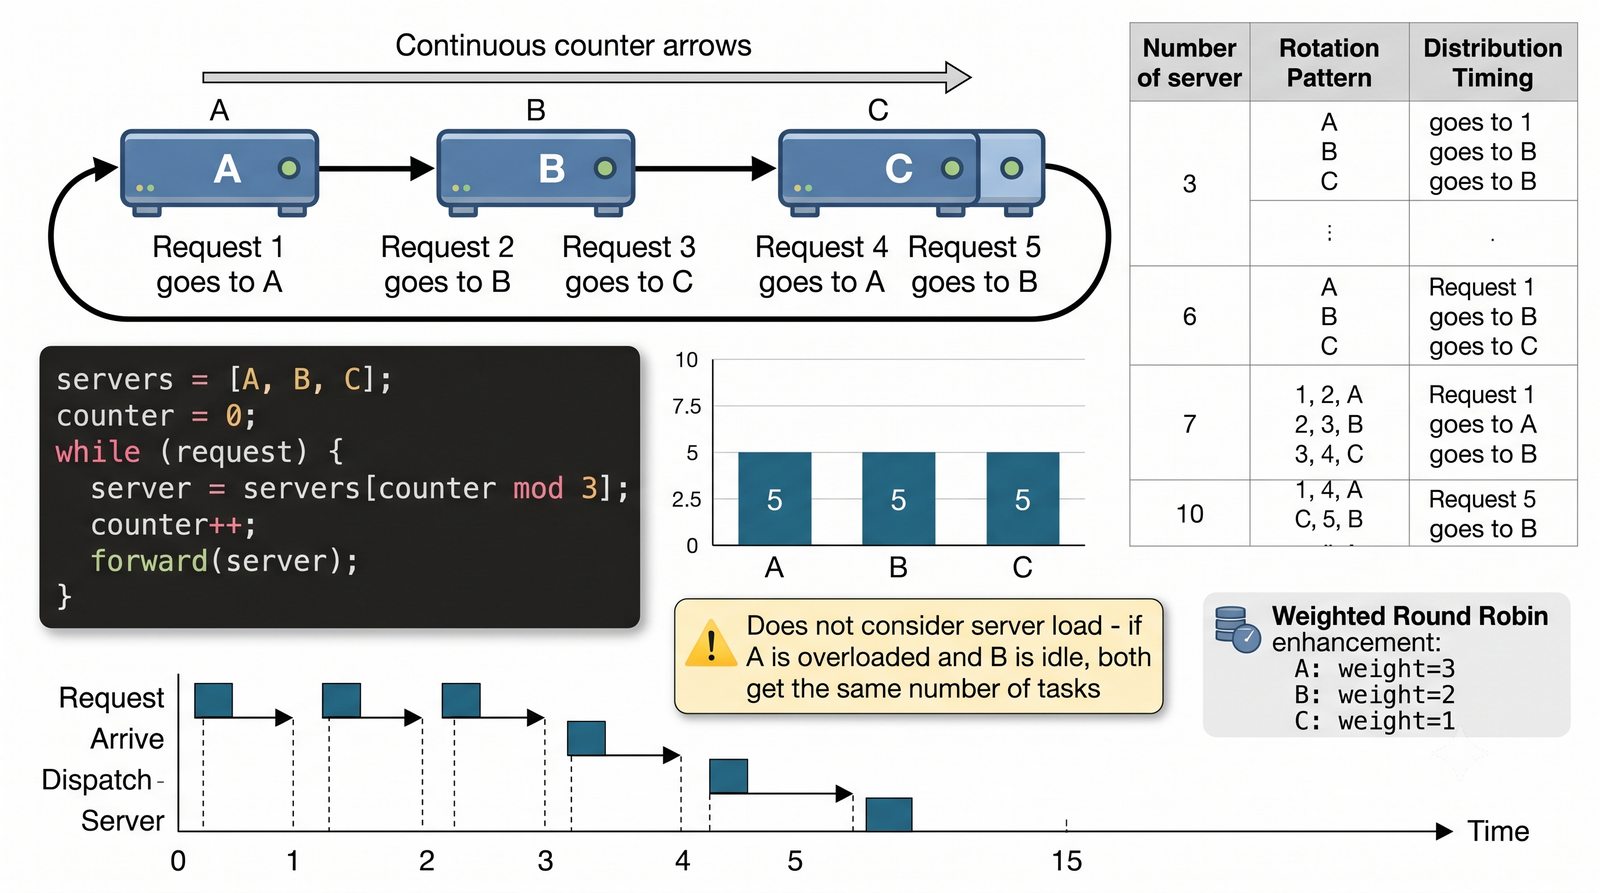
  • Zasada działania: algorytm bezstanowy (stateless), w którym kolejne napływające żądania HTTP są kierowane sekwencyjnie do kolejnych serwerów zaplecza z listy ułożonej w logiczny pierścień:
    Żądanie 1 → Serwer A, Żądanie 2 → Serwer B, Żądanie 3 → Serwer C, Żądanie 4 → Serwer A...
  • Złożoność obliczeniowa O(1): minimalny narzut na procesor balancera; wskaźnik pozycji w tablicy jest inkrementowany modulo liczba aktywnych węzłów (indeks = (indeks + 1) mod N).
  • Zalety: skrajna prostota, pełna sprawiedliwość podziału liczby żądań, brak konieczności śledzenia stanu połączeń.
  • Wady i ograniczenia:
    • Nie uwzględnia zróżnicowanej mocy obliczeniowej maszyn w klastrze.
    • Nie uwzględnia rzeczywistego kosztu obsługi żądań: szybkie żądanie pliku graficznego (np. 2 ms) obciąża system nieporównywalnie mniej niż generowanie złożonego raportu SQL (np. 1500 ms).
    • Ryzyko akumulacji trudnych żądań na jednym węźle.
Algorytm Round Robin: Slajd przedstawia zagadnienie Cykliczny i deterministyczny rozdział żądań w pierścieniu w ramach tematu Algorytm Round Robin na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
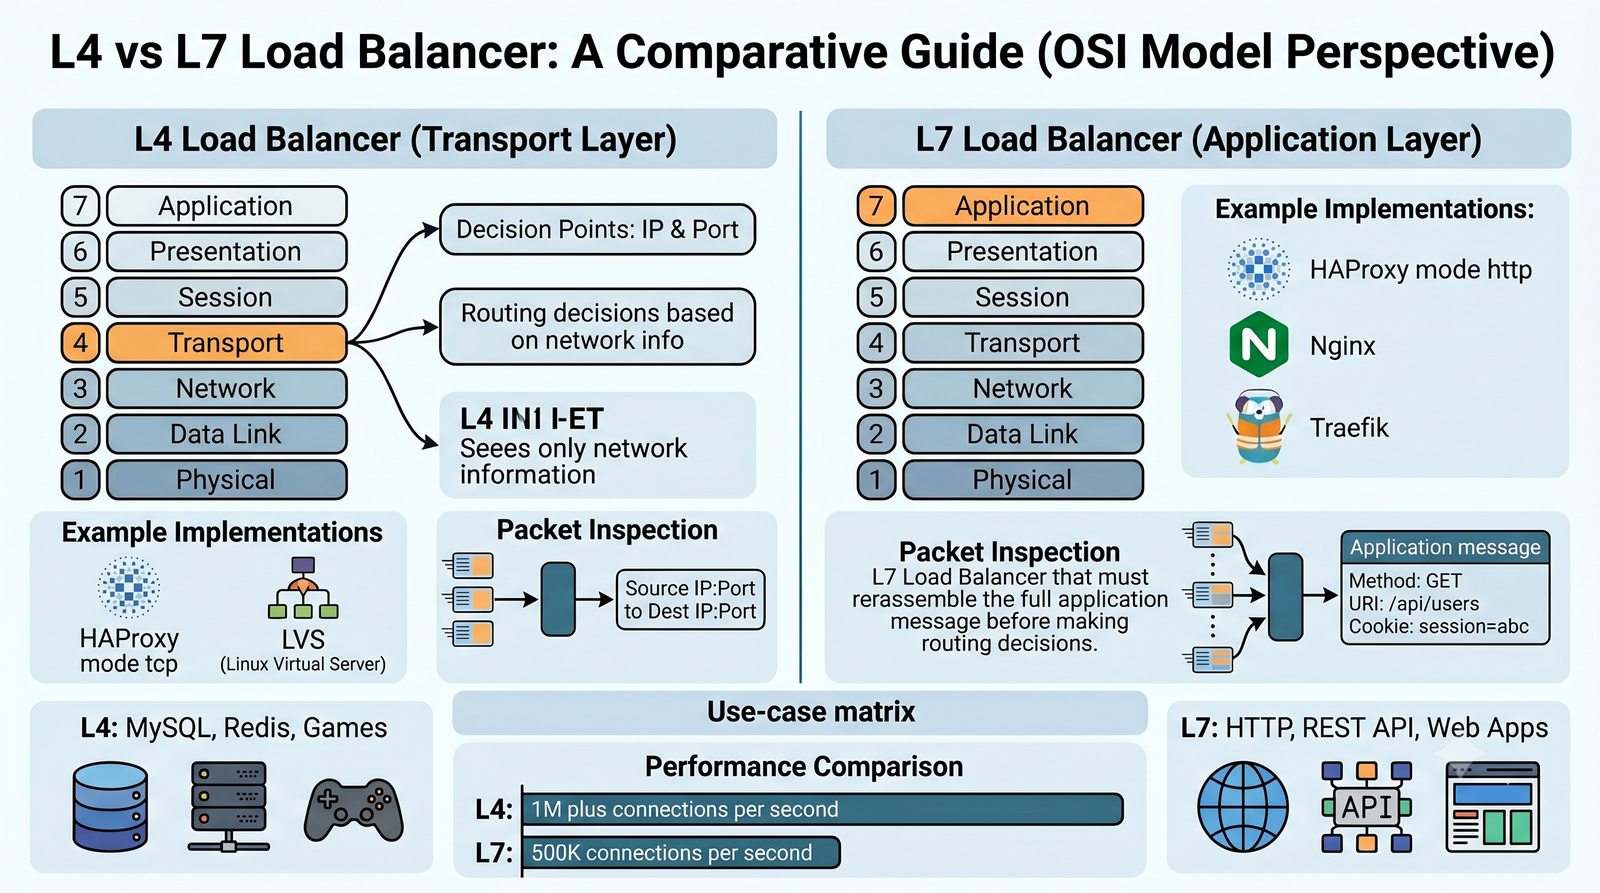
Algorytm Round Robin
16/50
Ważony Round Robin (Weighted Round Robin)
Cel slajdu: Slajd omawia zagadnienie „Ważony Round Robin (Weighted Round Robin)” w kontekście: Proporcjonalny rozdział żądań w klastrach heterogenicznych.

Proporcjonalny rozdział żądań w klastrach heterogenicznych

Kompensacja różnic wydajnościowych za pomocą wag przypisanych do węzłów

  • Istota wagowania: każdemu serwerowi zaplecza administrator przypisuje całkowitoliczbową wagę (ang. weight), odzwierciedlającą jego względną moc obliczeniową:
    Serwer A (weight=3), Serwer B (weight=2), Serwer C (weight=1)
    W cyklu obejmującym 6 żądań serwer A otrzyma 3 żądania, serwer B otrzyma 2 żądania, a serwer C dokładnie 1 żądanie.
  • Implementacja algorytmu Smooth Weighted Round Robin w Nginx:
    • Proste powtarzanie węzłów w cyklu (np. A, A, A, B, B, C) powodowałoby niekorzystne skoki obciążenia (ang. bursting).
    • Nginx stosuje algorytm wygładzony (ang. smooth interleaved algorithm), który równomiernie przeplata wybór maszyn (np. A, B, A, C, A, B), eliminując przeciążenia chwilowe.
  • Zastosowanie produkcyjne: klastry o zróżnicowanej generacji procesorów, maszyny wirtualne o różnych przydziałach vCPU oraz kontrolowane procedury wycofywania starych węzłów.
Ważony Round Robin (ang. Weighted Round Robin): Slajd przedstawia zagadnienie Proporcjonalny rozdział żądań w klastrach heterogenicznych w ramach tematu Ważony Round Robin (Weighted Round Robin) na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Ważony Round Robin (Weighted Round Robin)
17/50
Algorytm Least Connections
Cel slajdu: Slajd omawia zagadnienie „Algorytm Least Connections” w kontekście: Dynamiczne kierowanie ruchu do najmniej obciążonego węzła.

Dynamiczne kierowanie ruchu do najmniej obciążonego węzła

Adaptacyjny rozdział żądań w oparciu o bieżący stan połączeń serwerów zaplecza

  • Zasada działania: algorytm stanowy (stateful); serwer proxy monitoruje liczbę aktualnie otwartych i aktywnych połączeń TCP lub obsługiwanych żądań dla każdego serwera zaplecza.
  • Kryterium decyzyjne: nowe żądanie HTTP jest kierowane do serwera, który w danej milisekundzie posiada najmniejszą liczbę aktywnych połączeń:
    Serwer A (14 połączeń), Serwer B (4 połączenia), Serwer C (28 połączeń) → Wybór: Serwer B
  • Zalety:
    • Doskonała samoregulacja w warunkach żądań o drastycznie różnym czasie trwania (np. pobieranie dużych plików vs szybkie zapytania API).
    • Serwer wolniejszy lub przejściowo obciążony automatycznie otrzymuje mniej nowego ruchu do momentu zwolnienia zasobów.
  • Wariant ważony (Weighted Least Connections): wybór węzła o najmniejszym stosunku liczby połączeń do przypisanej wagi (min(C_i / W_i)).
  • Konfiguracja: Nginx: dyrektywa least_conn; w bloku upstream; HAProxy: balance leastconn w sekcji backend.
Algorytm Least Connections: Slajd przedstawia zagadnienie Dynamiczne kierowanie ruchu do najmniej obciążonego węzła w ramach tematu Algorytm Least Connections na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
Algorytm Least Connections
18/50
Algorytm IP Hash
Cel slajdu: Slajd omawia zagadnienie „Algorytm IP Hash” w kontekście: Deterministyczne przyporządkowanie klienta na podstawie funkcji skrótu.

Deterministyczne przyporządkowanie klienta na podstawie funkcji skrótu

Zapewnienie spójności sesji na poziomie warstwy sieciowej bez modyfikacji ciasteczek

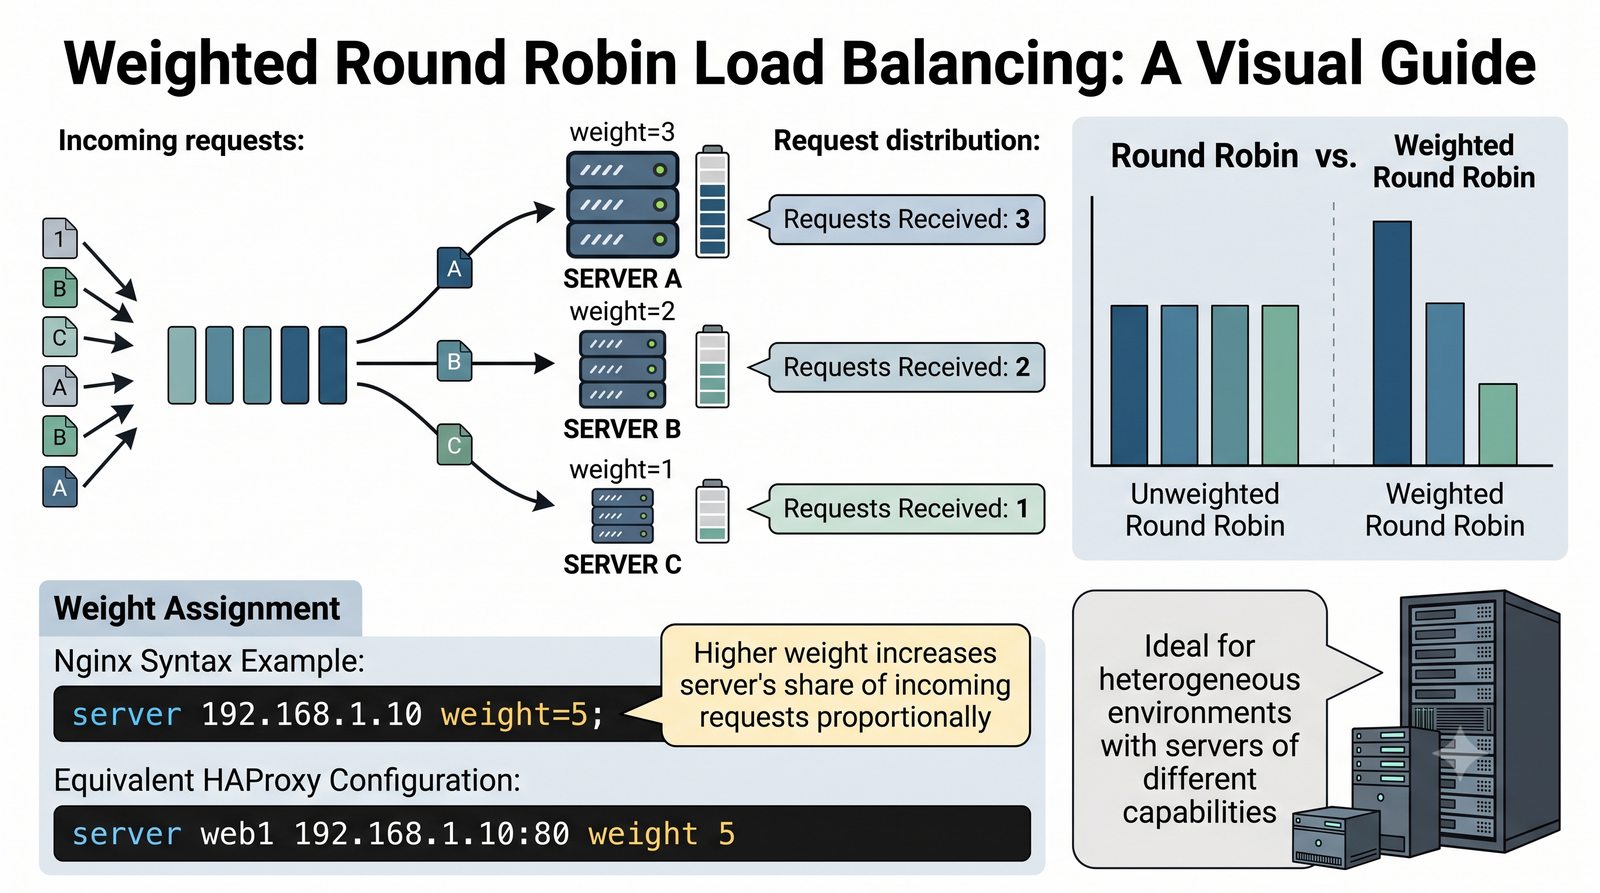
  • Zasada działania: adres IP klienta stanowi dane wejściowe dla funkcji skrótu (hash): w Nginx dyrektywa ip_hash uwzględnia pierwsze 3 oktety adresu IPv4, natomiast dyrektywa hash $remote_addr consistent oblicza skrót z pełnej wartości zmiennej metodą spójnego hashowania (ketama); w HAProxy odpowiednikiem jest balance source:
    indeks_serwera = hash(IP_klienta) mod N
    Dopóki liczba dostępnych serwerów w puli nie ulegnie zmianie, żądania z danego adresu IP zawsze trafiają do tego samego serwera zaplecza.
  • Zastosowanie: aplikacje stanowe (Stateful), w których sesja użytkownika przechowywana jest w lokalnej pamięci RAM serwera aplikacji, a infrastruktura nie obsługuje mechanizmu wstrzykiwania ciasteczek.
  • Poważne wady operacyjne:
    • Zjawisko bramy NAT (Corporate Proxy/Carrier-Grade NAT): tysiące użytkowników korporacyjnych wychodzących przez ten sam publiczny adres IP zostanie skierowanych do jednego serwera, powodując jego skrajne przeciążenie.
    • Efekt kaskadowy po awarii węzła: usunięcie lub dodanie serwera zmienia wartość mianownika w operacji modulo, powodując zerwanie sesji u większości klientów.
    • Rozwiązanie: algorytm Consistent Hashing (spójnego hashowania), minimalizujący migrację kluczy.
  • Konfiguracja: Nginx: ip_hash; lub hash $remote_addr consistent;; HAProxy: balance source.
Algorytm IP Hash: Slajd przedstawia zagadnienie Deterministyczne przyporządkowanie klienta na podstawie funkcji skrótu w ramach tematu Algorytm IP Hash na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Algorytm IP Hash
19/50
Porównanie algorytmów load balancingu
Cel slajdu: Slajd omawia zagadnienie „Porównanie algorytmów load balancingu” w kontekście: Matryca wyboru algorytmu w zależności od profilu aplikacji.

Matryca wyboru algorytmu w zależności od profilu aplikacji

Zestawienie właściwości, zalet, wad i rekomendowanych zastosowań inżynierskich

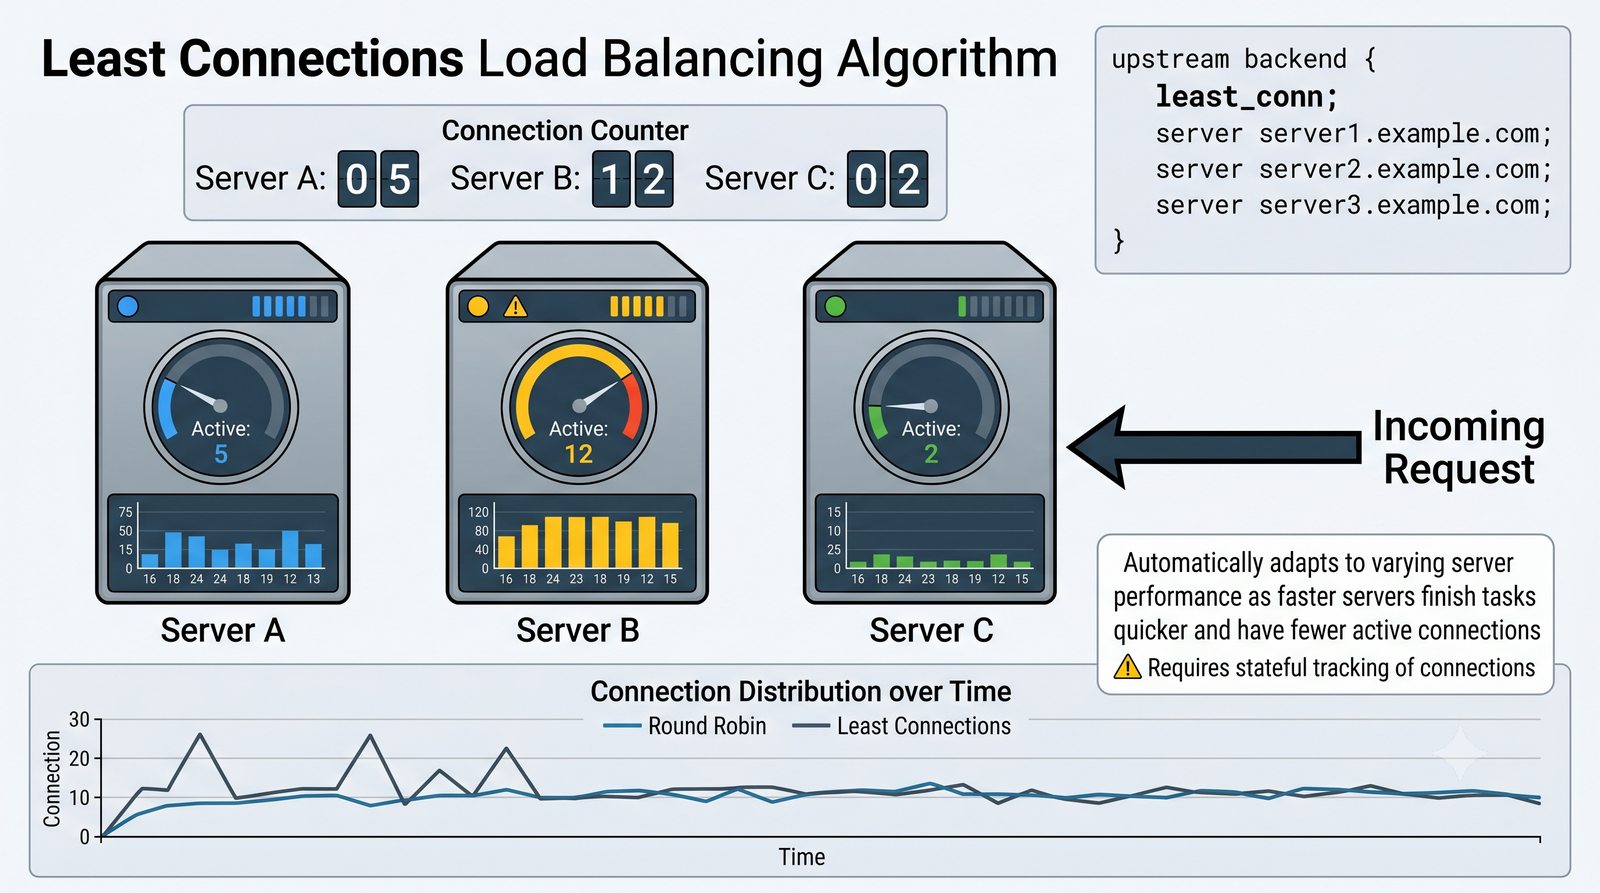
  • Algorytm Zalety Wady Rekomendowane zastosowanie
    Round Robin Minimalny narzut CPU, prostota, deterministyczna rotacja Ignoruje obciążenie i zróżnicowaną moc węzłów Jednorodne klastry bezstanowe, mikroserwisy o krótkim czasie obsługi
    Weighted RR Uwzględnia zróżnicowanie sprzętowe węzłów klastra Wymaga ręcznej kalibracji wag przez administratora Klastry heterogeniczne, migracje sprzętowe, testy Canary
    Least Conn Adaptacja do faktycznego obciążenia w czasie rzeczywistym Narzut na śledzenie stanu połączeń w pamięci proxy Żądania o zróżnicowanym czasie, streaming, WebSocket, bazy danych
    IP Hash Persystencja sesji bez ingerencji w warstwę HTTP Podatność na NAT, nierównomierny rozkład przy dużych sieciach Aplikacje stanowe bez wsparcia dla cookie insert i magazynów sesji
    Consistent Hash Stabilność przypisań po awarii węzła, brak efektu kaskadowego Większa złożoność obliczeniowa pierścienia wirtualnych węzłów Rozproszone pamięci podręczne (Memcached, Redis), buforowanie proxy
Porównanie algorytmów load balancingu: Slajd przedstawia zagadnienie Matryca wyboru algorytmu w zależności od profilu aplikacji w ramach tematu Porównanie algorytmów load balancingu na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Porównanie algorytmów load balancingu
20/50
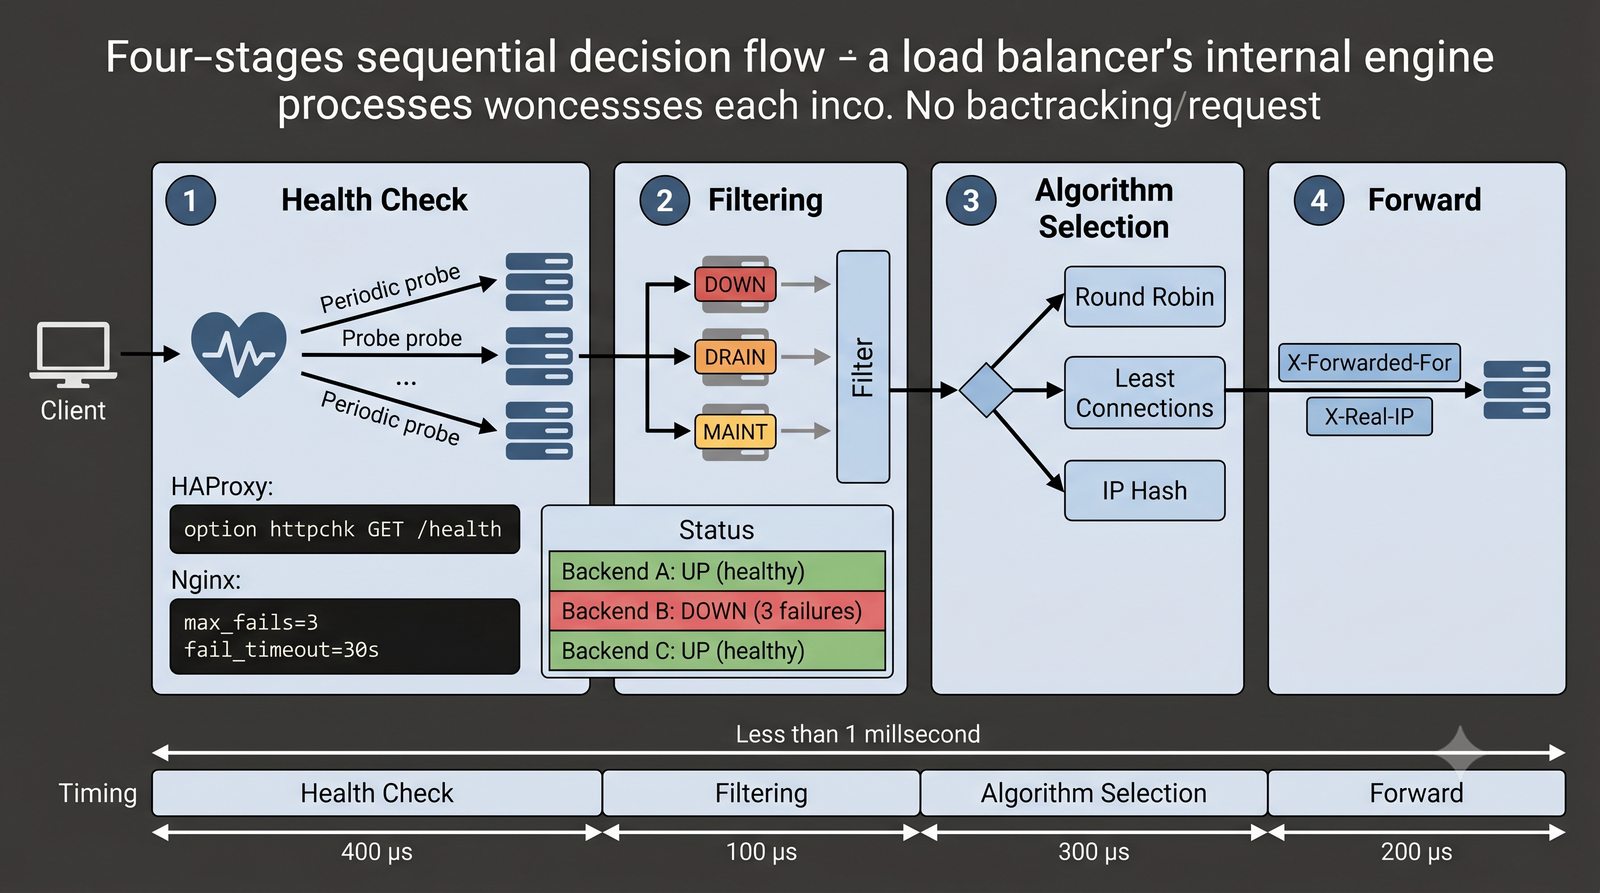
System decyzyjny silnika load balancera
Cel slajdu: Slajd omawia zagadnienie „System decyzyjny silnika load balancera” w kontekście: Architektura potoku przetwarzania i reguły wyboru węzła.

Architektura potoku przetwarzania i reguły wyboru węzła

Wielostopniowy potok decyzyjny od nadejścia pakietu do retransmisji żądania

  • Etap 1: Aktywny i pasywny monitoring stanu zdrowia (Health Checking):
    • Pośrednik stale klasyfikuje węzły: UP (sprawny), DOWN (martwy), DRAIN (wygaszanie sesji), BACKUP (zapasowy).
    • Progi histerezy: liczba nieudanych prób wykluczenia (fall) oraz udanych prób przywrócenia (rise).
  • Etap 2: Filtracja puli kandydatów: wykluczenie maszyn niesprawnych i przeznaczonych do prac serwisowych.
  • Etap 3: Weryfikacja reguł koligacji (Persistence Engine): sprawdzenie obecności ciasteczka sesyjnego lub reguły hash; jeśli klient posiada ważną sesję z żywym węzłem, żądanie trafia bezpośrednio do niego.
  • Etap 4: Wykonanie algorytmu równoważenia: jeżeli brak przypisania sesyjnego, wybór węzła z przefiltrowanej puli wg skonfigurowanego algorytmu (Round Robin, Least Conn).
  • Etap 5: Modyfikacja nagłówków i forward: wstrzyknięcie nagłówków tożsamości klienta (RFC 7239) i wysłanie żądania.
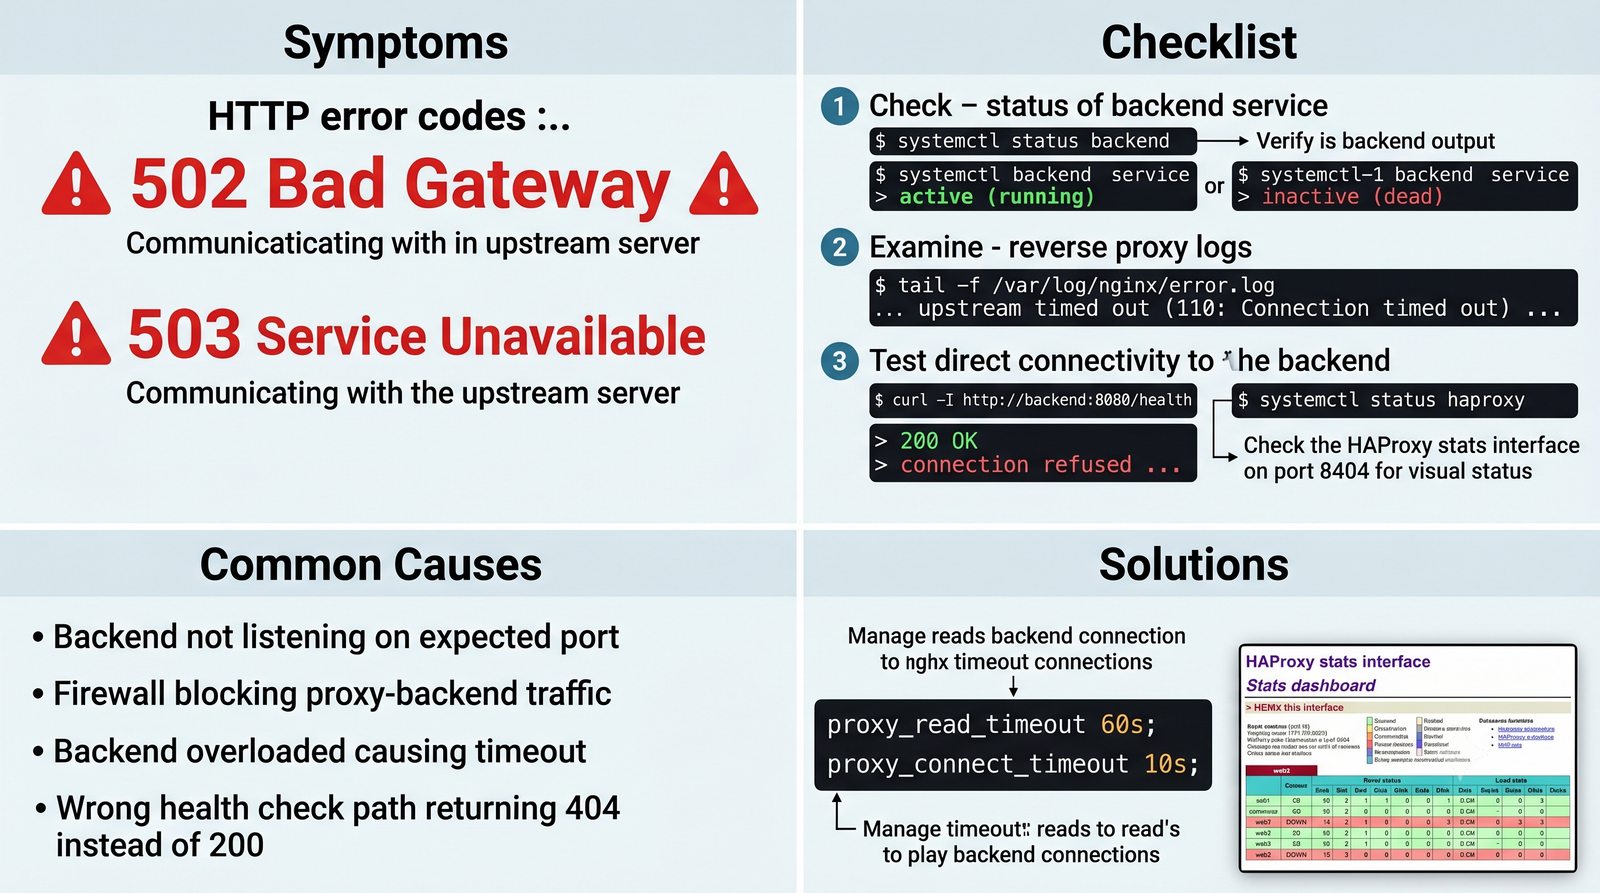
  • Etap 6: Obsługa błędów (Failover): w razie błędu 5xx lub przekroczenia limitu czasu (timeout), automatyczne ponowienie żądania do innego węzła (dyrektywa proxy_next_upstream w Nginx).
System decyzyjny silnika load balancera: Slajd przedstawia zagadnienie Architektura potoku przetwarzania i reguły wyboru węzła w ramach tematu System decyzyjny silnika load balancera na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
System decyzyjny silnika load balancera
21/50
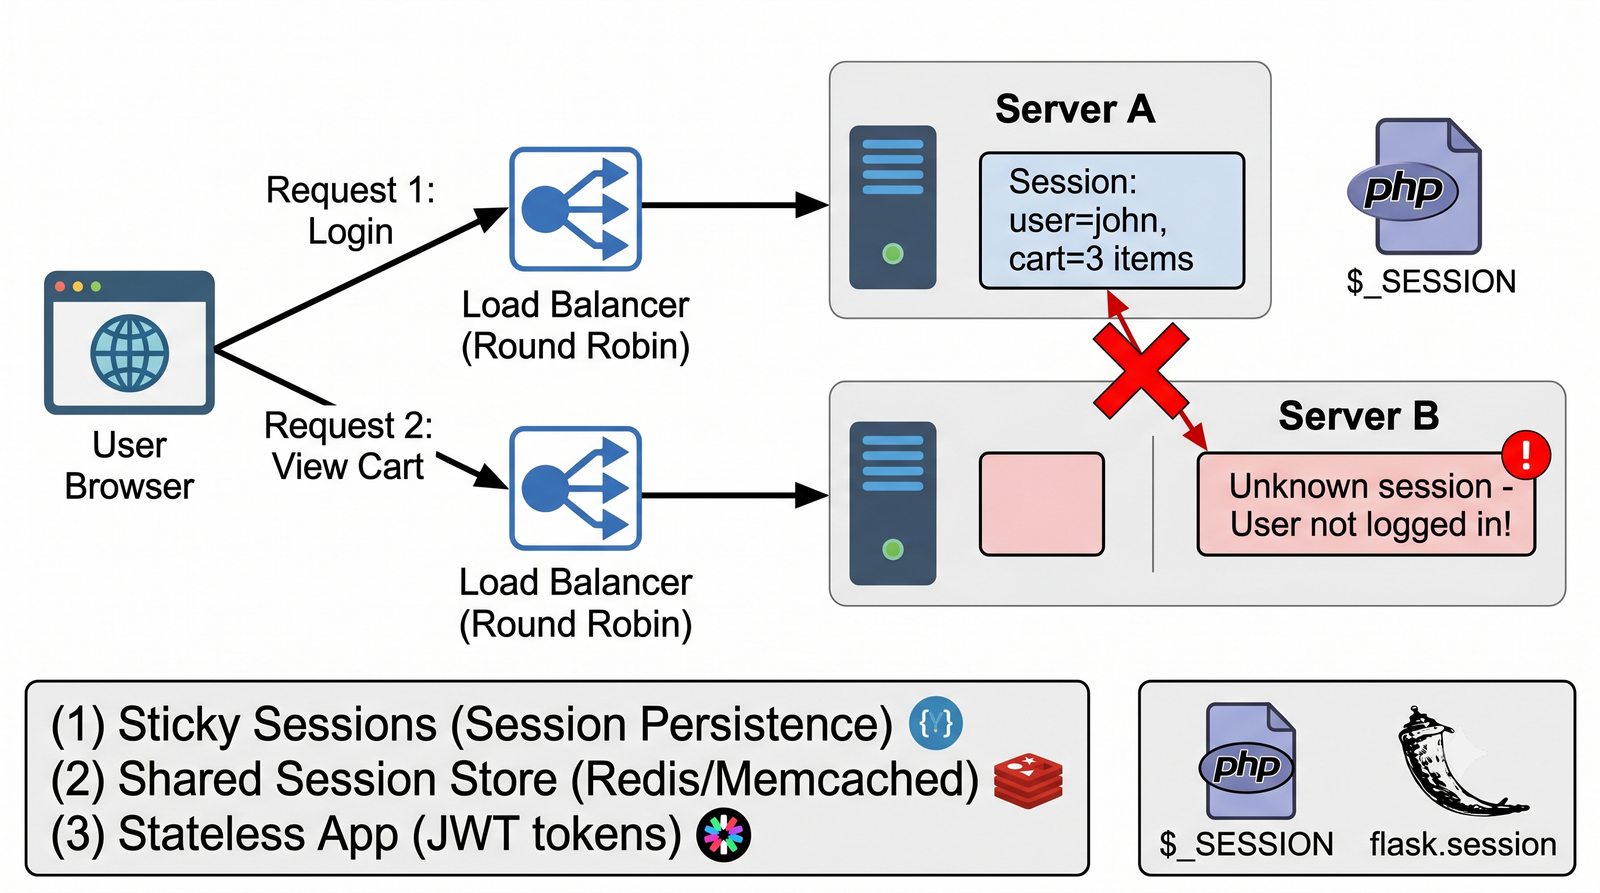
Problem stanu sesji w systemach rozproszonych
Cel slajdu: Slajd omawia zagadnienie „Problem stanu sesji w systemach rozproszonych” w kontekście: Wyzwania skalowania aplikacji stanowych w architekturze klastrowej.

Wyzwania skalowania aplikacji stanowych w architekturze klastrowej

Rozdźwięk między bezstanowością protokołu HTTP a stanowością logiki biznesowej

  • Bezstanowość protokołu HTTP: z założenia protokół HTTP (RFC 9110) jest protokołem bezstanowym (stateless) – każde żądanie jest traktowane niezależnie.
  • Aplikacje stanowe (Stateful): platformy e-commerce, systemy bankowe i panele zarządzania przechowują stan sesji (uwierzytelnienie, koszyk zakupowy) w pamięci operacyjnej konkretnego procesu serwera (np. HttpSession, sesje PHP).
  • Problem klastrowy: gdy Load Balancer skieruje kolejne żądanie zalogowanego użytkownika do innego węzła zaplecza, nowa maszyna nie odnajdzie danych sesyjnych w swoim RAM-ie, co wywoła nagłe wylogowanie klienta lub błąd spójności.
  • Dwa modele rozwiązania problemu:
    • Architektura bezstanowa: wyniesienie stanu sesji do centralnego, rozproszonego magazynu w pamięci (np. klaster Redis, Memcached) lub zastosowanie samowystarczalnych tokenów kryptograficznych (JWT – JSON Web Tokens).
    • Lepkość sesji (Sticky Sessions): wymuszenie w warstwie load balancera, aby dany klient był zawsze obsługiwany przez ten sam węzeł fizyczny.
Problem stanu sesji w systemach rozproszonych: Slajd przedstawia zagadnienie Wyzwania skalowania aplikacji stanowych w architekturze klastrowej w ramach tematu Problem stanu sesji w systemach rozproszonych na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Problem stanu sesji w systemach rozproszonych
22/50
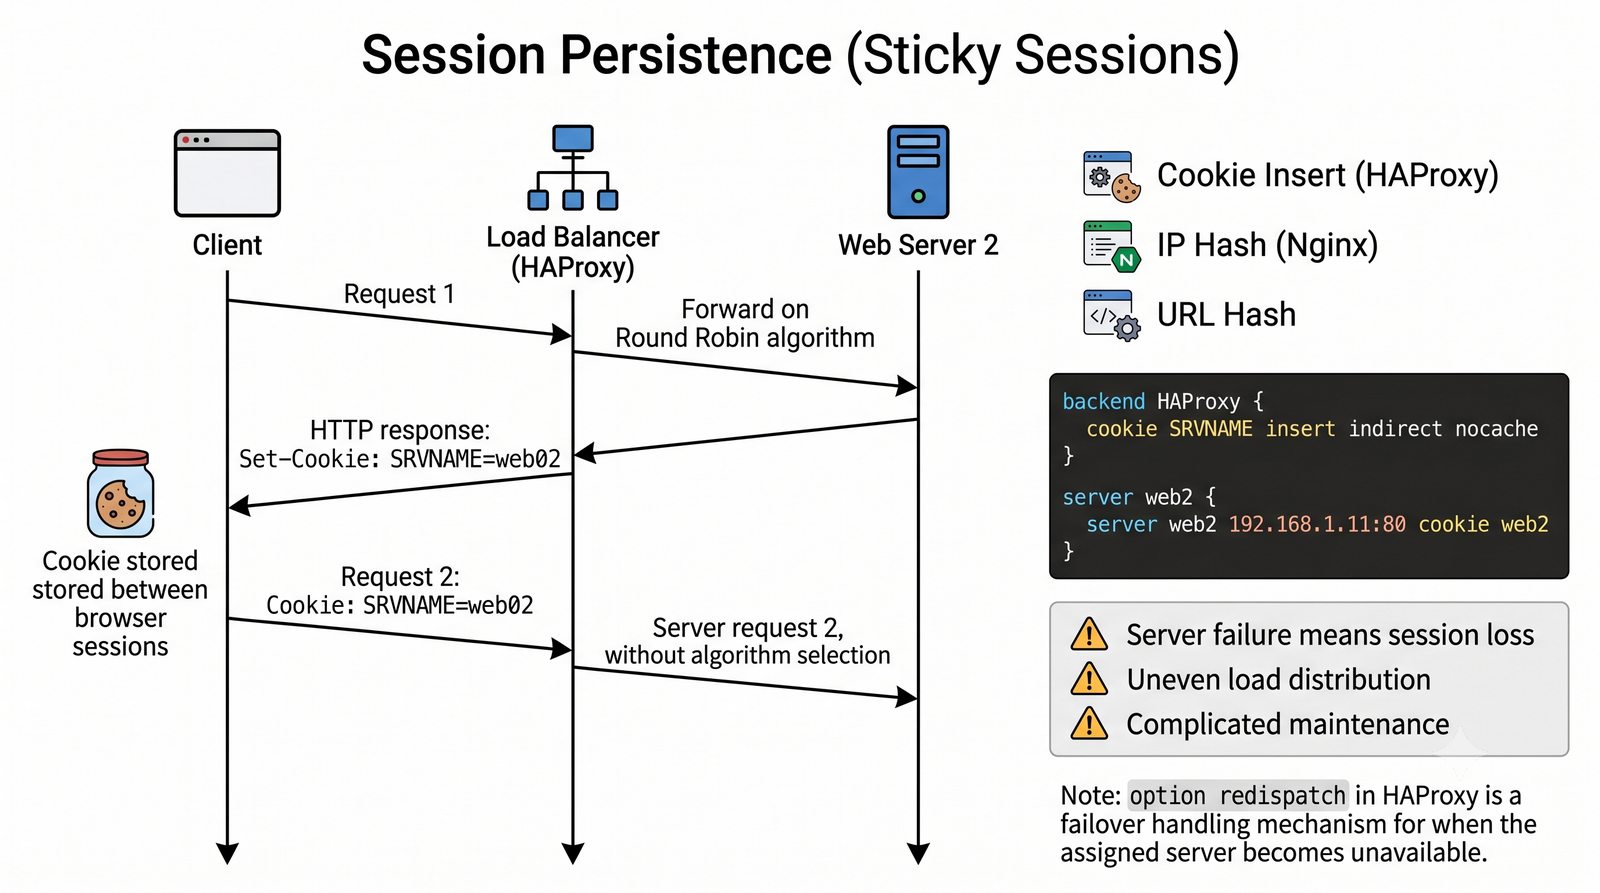
Session Persistence (Sticky Sessions)
Cel slajdu: Slajd omawia zagadnienie „Session Persistence (Sticky Sessions)” w kontekście: Metody wiązania klienta z dedykowanym serwerem zaplecza.

Metody wiązania klienta z dedykowanym serwerem zaplecza

Przegląd technik zapewniania koligacji sesyjnej w warstwach L4 i L7

  • Pojęcie lepkości sesji (Session Affinity / Sticky Sessions): mechanizm routingu gwarantujący, że po zainicjowaniu sesji wszystkie kolejne żądania generowane przez danego klienta trafiają do tego samego serwera zaplecza.
  • Metoda 1: Koligacja źródłowego adresu IP (Source IP Affinity / IP Hash):
    • Działa w warstwie L4; brak ingerencji w nagłówki HTTP.
    • Podatna na zjawisko współdzielonych bram NAT oraz zmianę trasowania przy urządzeniach mobilnych (przełączanie Wi-Fi / LTE).
  • Metoda 2: Wstrzykiwanie ciasteczka przez Load Balancer (Cookie Insert):
    • Działa w warstwie L7; balancer dodaje własne ciasteczko z identyfikatorem serwera do nagłówka Set-Cookie.
    • Niezależna od adresu IP klienta; w pełni odporna na bramy NAT i zmiany sieci użytkownika.
  • Metoda 3: Pasywna inspekcja ciasteczka aplikacyjnego (Cookie Passive / Learn):
    • Proxy obserwuje ciasteczko generowane przez aplikację (np. JSESSIONID, PHPSESSID) i tworzy wewnętrzną tablicę mapowania.
  • Zagrożenie operacyjne: w razie awarii przypisanego węzła sesja ulega utracie; konieczna opcja awaryjnego przekierowania (option redispatch).
Session Persistence (ang. Sticky Sessions): Slajd przedstawia zagadnienie Metody wiązania klienta z dedykowanym serwerem zaplecza w ramach tematu Session Persistence (Sticky Sessions) na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Session Persistence (Sticky Sessions)
23/50
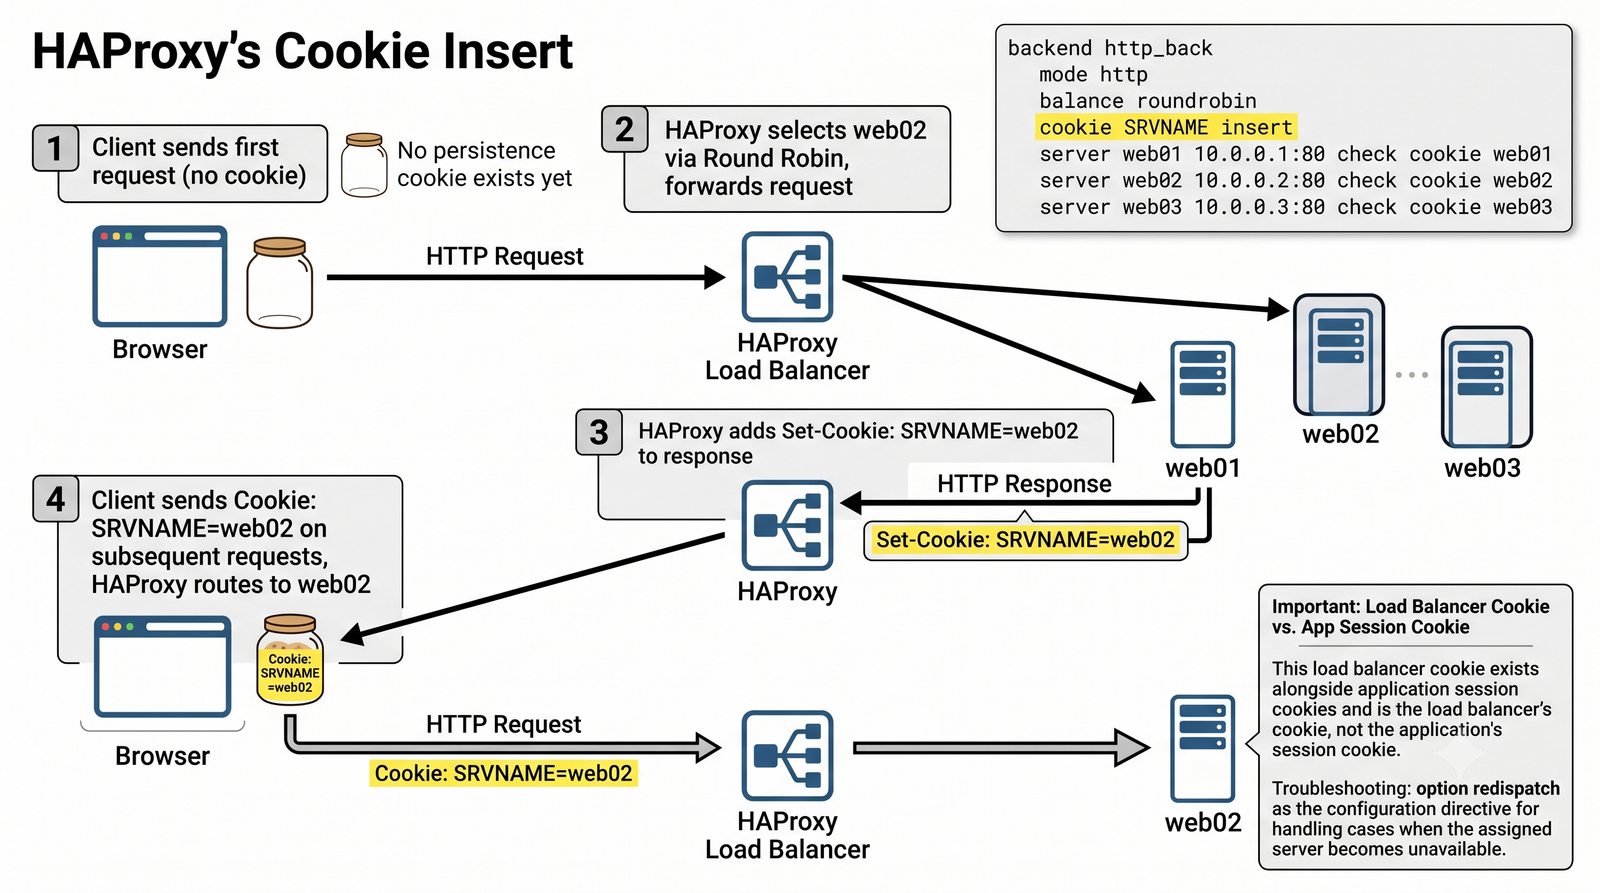
Ciasteczko klienta na balancerze – jak działa cookie insert?
Cel slajdu: Slajd omawia zagadnienie „Ciasteczko klienta na balancerze – jak działa cookie insert?” w kontekście: Szczegółowy mechanizm wstrzykiwania ciasteczka w HAProxy i Nginx.

Szczegółowy mechanizm wstrzykiwania ciasteczka w HAProxy i Nginx

Anatomia komunikacji z wykorzystaniem nagłówków Set-Cookie i Cookie

  • Krok 1 (Brak ciasteczka): Klient wysyła pierwsze żądanie HTTP; nagłówek Cookie nie zawiera identyfikatora balancera.
  • Krok 2 (Wybór węzła i odpowiedź zaplecza): Balancer (np. HAProxy) wybiera serwer zaplecza (np. srv02) wg algorytmu (Round Robin/Least Conn) i przekazuje żądanie. Serwer zaplecza zwraca standardową treść.
  • Krok 3 (Wstrzyknięcie nagłówka Set-Cookie): Pośrednik modyfikuje nagłówek odpowiedzi przed wysłaniem do klienta, dodając:
    Set-Cookie: SRVNAME=srv02; path=/; HttpOnly; Secure; SameSite=Lax (atrybut SameSite opisano w projekcie RFC 6265bis, nie w RFC 6265)
  • Krok 4 (Kolejne żądania klienta): Przeglądarka zapisuje ciasteczko i dołącza je do każdego kolejnego żądania:
    Cookie: SRVNAME=srv02; PHPSESSID=abc123xyz...
    Balancer odczytuje wartość srv02 i natychmiast przekazuje żądanie do serwera srv02 z pominięciem algorytmu rotacji.
  • Atrybuty w HAProxy: dyrektywa cookie SRVNAME insert indirect nocache. Opcja option redispatch gwarantuje failover w razie awarii serwera srv02.
Ciasteczko klienta na balancerze – jak działa cookie insert?: Slajd przedstawia zagadnienie Szczegółowy mechanizm wstrzykiwania ciasteczka w HAProxy i Nginx w ramach tematu Ciasteczko klienta na balancerze – jak działa cookie insert? na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Ciasteczko klienta na balancerze - jak działa cookie insert?
24/50
Buforowanie na warstwie Proxy (Caching)
Cel slajdu: Slajd omawia zagadnienie „Buforowanie na warstwie Proxy (Caching)” w kontekście: Mechanizmy pamięci podręcznej i przyspieszanie serwowania treści.

Mechanizmy pamięci podręcznej i przyspieszanie serwowania treści

Redukcja opóźnień sieciowych (TTFB) i odciążenie serwerów bazodanowych

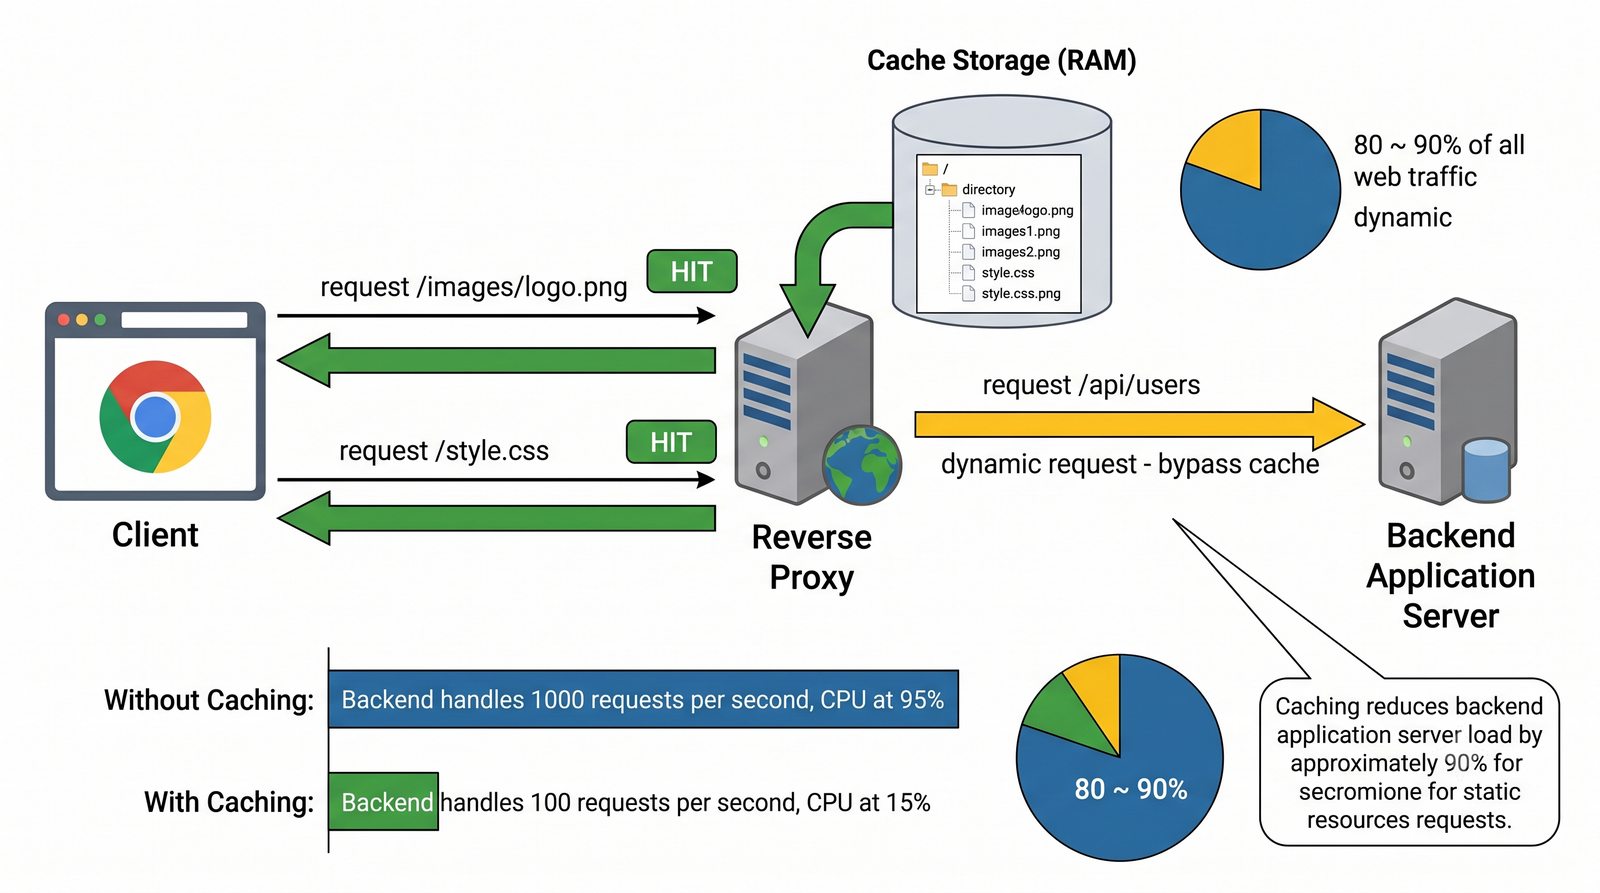
  • Problem wydajnościowy: w typowych serwisach internetowych ponad 80% wolumenu przesyłanych danych stanowią powtarzalne zasoby statyczne (pliki CSS, JavaScript, czcionki, obrazy, dokumenty PDF) lub półstatyczne odpowiedzi API.
  • Nieefektywność bezpośredniej obsługi: angażowanie serwerów aplikacyjnych (np. interpreterów PHP, aplikacji Python/Node.js) do wielokrotnego odczytywania tych samych plików z dysku i generowania identycznych nagłówków prowadzi do wyczerpania zasobów CPU i I/O.
  • Zasada działania pamięci podręcznej (Proxy Cache):
    • Pośrednik przechwytuje odpowiedź wygenerowaną przez backend i zapisuje ją w szybkiej pamięci lokalnej (pamięć RAM / szybki dysk NVMe).
    • Kolejne żądania o ten sam zasób są serwowane bezpośrednio przez proxy w czasie poniżej 1 milisekundy (ang. Cache Hit).
    • Ruch do backendu jest generowany wyłącznie przy pierwszym pobraniu lub po wygaśnięciu ważności zasobu (ang. Cache Miss / Expired).
  • Standard IETF: semantyka buforowania w sieci Web została precyzyjnie ujednolicona w dokumencie RFC 9111 (HTTP Caching).
Buforowanie na warstwie Proxy (ang. Caching): Slajd przedstawia zagadnienie Mechanizmy pamięci podręcznej i przyspieszanie serwowania treści w ramach tematu Buforowanie na warstwie Proxy (Caching) na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Buforowanie na warstwie Proxy (Caching)
25/50
Mechanizm Cachingu w Nginx
Cel slajdu: Slajd omawia zagadnienie „Mechanizm Cachingu w Nginx” w kontekście: Architektura dyskowo-pamięciowa i kluczowe dyrektywy konfiguracyjne.

Architektura dyskowo-pamięciowa i kluczowe dyrektywy konfiguracyjne

Praktyczna implementacja pamięci podręcznej w module ngx_http_proxy_module

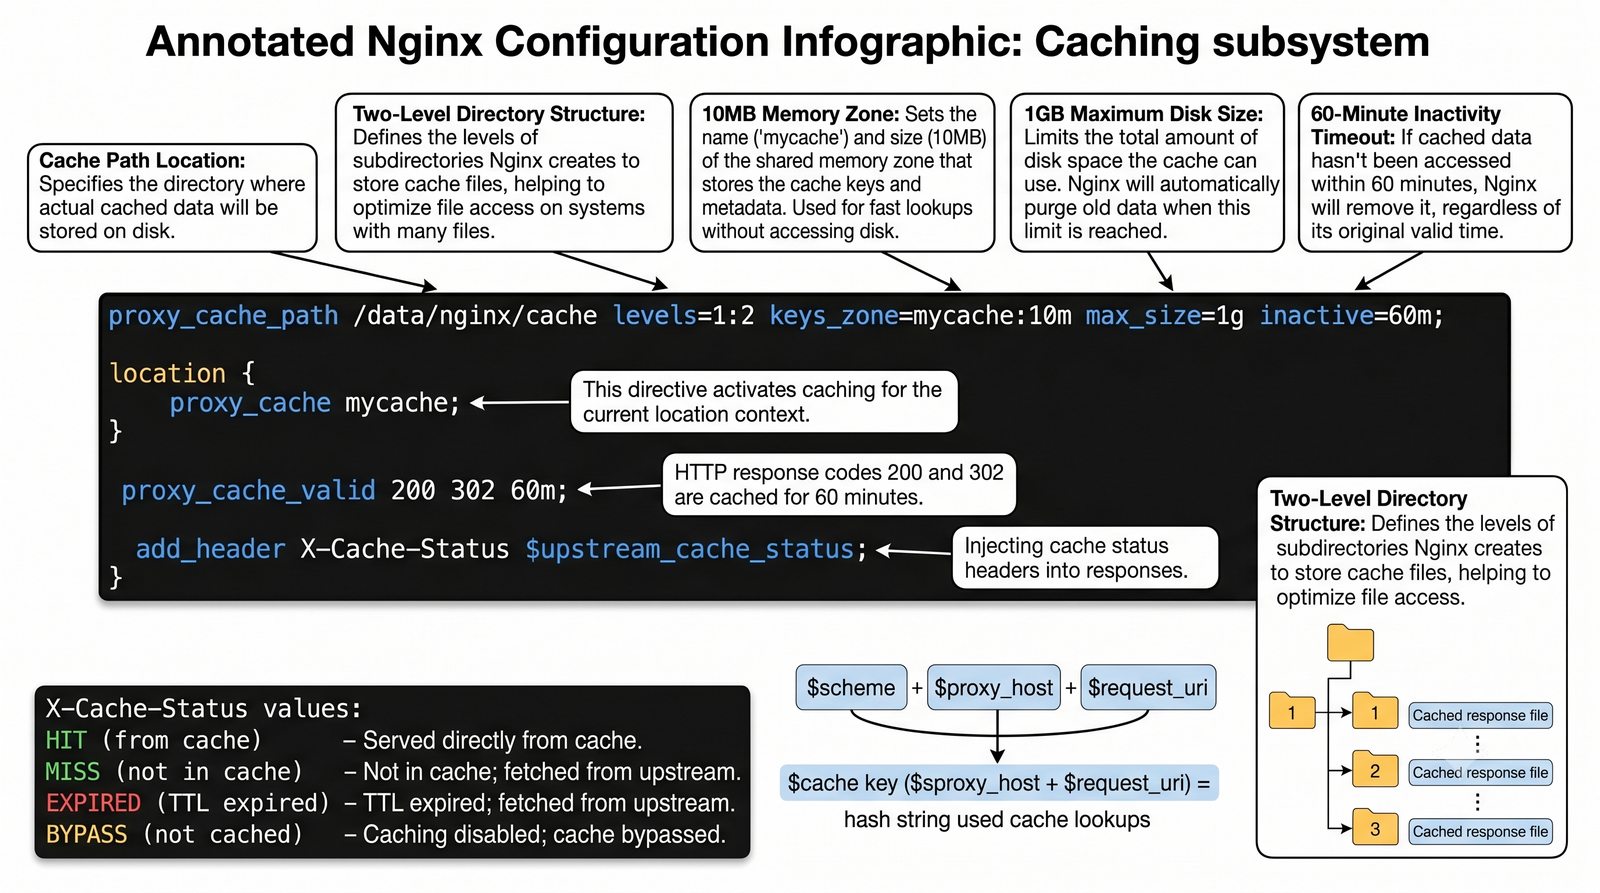
  • Dyrektywa proxy_cache_path (kontekst http): definiuje globalne parametry magazynu bufora:
    proxy_cache_path /var/cache/nginx levels=1:2 keys_zone=STATIC_CACHE:20m max_size=10g inactive=120m use_temp_path=off;
    • levels=1:2: dwupoziomowa hierarchia podkatalogów zapobiegająca degradacji systemu plików;
    • keys_zone=STATIC_CACHE:20m: alokacja 20 MB pamięci RAM dla tablicy mieszającej kluczy (1 MB mieści ok. 8000 wpisów);
    • max_size=10g: górny limit pojemności bufora na nośniku dyskowym;
    • inactive=120m: usuwanie obiektów nieodpytywanych przez 120 minut.
  • Aktywacja w kontekście server lub location:
    proxy_cache STATIC_CACHE;
    proxy_cache_valid 200 302 60m;
    proxy_cache_valid 404      5m;
    proxy_cache_use_stale error timeout updating http_500 http_502 http_503;
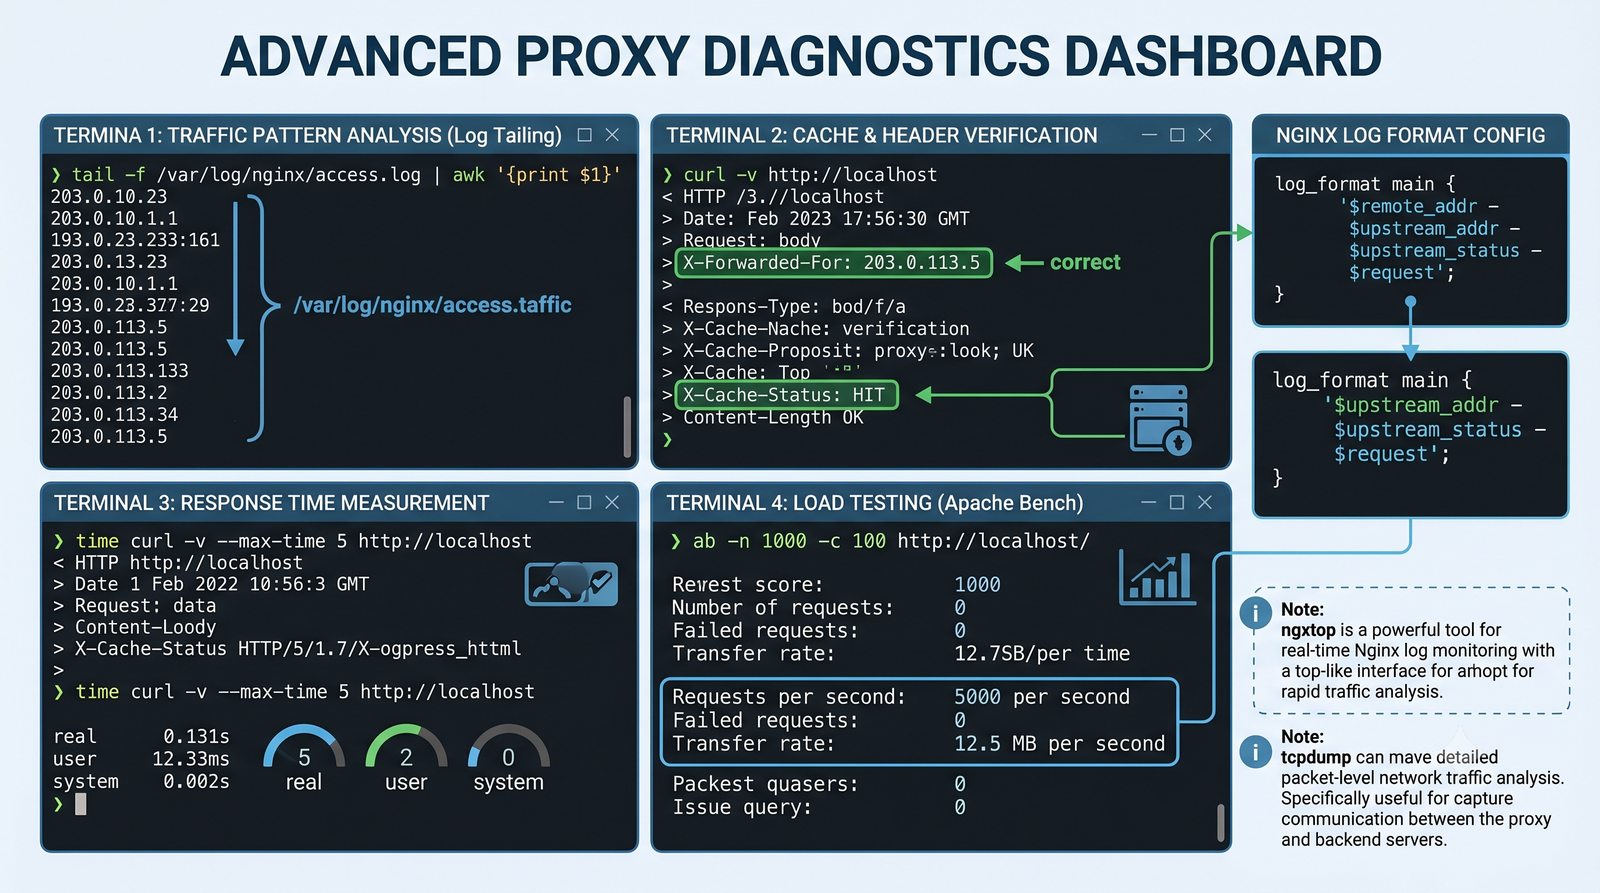
    add_header X-Cache-Status $upstream_cache_status;
  • Zmienna $upstream_cache_status: wartości diagnostyczne: HIT, MISS, BYPASS, EXPIRED, STALE, UPDATING.
Mechanizm Cachingu w Nginx: Slajd przedstawia zagadnienie Architektura dyskowo-pamięciowa i kluczowe dyrektywy konfiguracyjne w ramach tematu Mechanizm Cachingu w Nginx na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi Nginx.
Mechanizm Cachingu w Nginx
26/50
Nagłówki TTL – sterowanie czasem życia w buforze
Cel slajdu: Slajd omawia zagadnienie „Nagłówki TTL – sterowanie czasem życia w buforze” w kontekście: Standard IETF RFC 9111 i dyrektywy nagłówka Cache-Control.

Standard IETF RFC 9111 i dyrektywy nagłówka Cache-Control

Precyzyjna komunikacja między serwerem aplikacji a serwerami pośredniczącymi

  • Rola nagłówka Cache-Control: ustandaryzowany w RFC 9111 mechanizm przekazywania jednoznacznych instrukcji dla buforów prywatnych (przeglądarki) oraz współdzielonych (Reverse Proxy, CDN).
  • Kluczowe dyrektywy sterujące czasem (TTL):
    • max-age=<sekundy>: określa maksymalny czas świeżości obiektu dla wszystkich buforów.
    • s-maxage=<sekundy>: dyrektywa priorytetowa dla buforów współdzielonych (ang. shared cache / proxy); nadpisuje max-age dla węzłów pośredniczących.
  • Dyrektywy określające zakres i restrykcje:
    • public: zasób może być buforowany przez dowolnego pośrednika (nawet jeśli żądanie wymagało uwierzytelnienia).
    • private: odpowiedź jest dedykowana wyłącznie dla pojedynczego klienta; zakaz buforowania na Reverse Proxy.
    • no-cache: zasób może być przechowywany w buforze, lecz przed każdym zaserwowaniem musi zostać zwalidowany z serwerem źródłowym (kod 304).
    • no-store: całkowity zakaz zapisywania odpowiedzi, także w pamięci podręcznej (dane wrażliwe, hasła, numery kart).
    • must-revalidate: zakaz serwowania przeterminowanego obiektu w razie utraty łączności z zapleczem.
Nagłówki TTL – sterowanie czasem życia w buforze: Slajd przedstawia zagadnienie Standard IETF RFC 9111 i dyrektywy nagłówka Cache-Control w ramach tematu Nagłówki TTL – sterowanie czasem życia w buforze na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Nagłówki TTL - sterowanie czasem życia w buforze
27/50
Modyfikatory czasu – praktyczne TTL patterns
Cel slajdu: Slajd omawia zagadnienie „Modyfikatory czasu – praktyczne TTL patterns” w kontekście: Wzorce projektowe konfiguracji pamięci podręcznej dla różnych typów treści.

Wzorce projektowe konfiguracji pamięci podręcznej dla różnych typów treści

Optymalne strategie doboru dyrektyw buforowania w środowiskach produkcyjnych

  • Wzorzec 1: Niezmienne zasoby statyczne (Cache Busting / Fingerprinting):
    • Pliki z hashem zawartości w nazwie (np. app.8f9b2a.js, theme.c3d4e5.css).
    • Konfiguracja: Cache-Control: public, max-age=31536000, immutable.
    • Zasób buforowany przez 1 rok; dyrektywa immutable (RFC 8246) blokuje zapytania sprawdzające nawet przy odświeżaniu strony (F5).
  • Wzorzec 2: Zasoby multimedialne i czcionki:
    • Obrazy, logotypy, fonty WOFF2: Cache-Control: public, max-age=86400, stale-while-revalidate=3600.
    • Klient otrzymuje błyskawiczną odpowiedź, a odświeżenie w tle wymaga po stronie Nginx dyrektyw proxy_cache_use_stale updating oraz proxy_cache_background_update on; sam nagłówek działa przede wszystkim w pamięciach przeglądarek i CDN.
  • Wzorzec 3: Dynamiczne strony HTML (dokument główny):
    • Plik index.html: Cache-Control: no-cache, must-revalidate wraz z walidatorem ETag.
    • Gwarancja natychmiastowego pobrania nowych nazw plików JS/CSS po wdrożeniu nowej wersji aplikacji.
  • Wzorzec 4: Prywatne API i panele użytkowników:
    • Cache-Control: private, no-store, no-cache, must-revalidate.
Modyfikatory czasu – praktyczne TTL patterns: Slajd przedstawia zagadnienie Wzorce projektowe konfiguracji pamięci podręcznej dla różnych typów treści w ramach tematu Modyfikatory czasu – praktyczne TTL patterns na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Modyfikatory czasu - praktyczne TTL patterns
28/50
Cache Invalidation – jak unieważnić bufor?
Cel slajdu: Slajd omawia zagadnienie „Cache Invalidation – jak unieważnić bufor?” w kontekście: Metody usuwania nieaktualnych obiektów z pamięci podręcznej.

Metody usuwania nieaktualnych obiektów z pamięci podręcznej

Rozwiązania jednego z fundamentalnych problemów inżynierii systemów rozproszonych

  • Wyzwanie operacyjne: „W informatyce istnieją tylko dwa trudne problemy: unieważnianie pamięci podręcznej i nazywanie rzeczy” (Phil Karlton). Po zapisaniu obiektu w proxy, modyfikacja treści na backendzie nie unieważnia go automatycznie.
  • Metoda 1: Wersjonowanie zasobów (Cache Busting / URL Versioning):
    • Najbardziej niezawodna metoda: zamiast czyścić bufor, aplikacja zmienia odnośnik URI (np. style.v2.css lub parametr style.css?v=20261001).
    • Stary obiekt wygasa samoistnie po upływie czasu zdefiniowanego w inactive.
  • Metoda 2: Selektywne czyszczenie żądaniem HTTP (Metoda PURGE):
    • Wysłanie żądania PURGE /ścieżka/zasób bezpośrednio do serwera proxy (wymaga modułu proxy_cache_purge w Nginx).
    • Dostęp do metody PURGE musi być ściśle ograniczony regułami ACL wyłącznie do zaufanych adresów IP aplikacji.
  • Metoda 3: Globalne unieważnienie (opróżnianie bufora, ang. Cache Flushing / strefy pamięci):
    • Fizyczne usunięcie struktury plików (sudo rm -rf /var/cache/nginx/* && sudo systemctl reload nginx); drastyczny krok powodujący krótkotrwały pik obciążenia backendu (ang. Cache Stampede).
Cache Invalidation – jak unieważnić bufor?: Slajd przedstawia zagadnienie Metody usuwania nieaktualnych obiektów z pamięci podręcznej w ramach tematu Cache Invalidation – jak unieważnić bufor? na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
Cache Invalidation - jak unieważnić bufor?
29/50
SSL/TLS termination na reverse proxy
Cel slajdu: Slajd omawia zagadnienie „SSL/TLS termination na reverse proxy” w kontekście: Terminacja kryptograficzna i odciążenie procesorów zaplecza.

Terminacja kryptograficzna i odciążenie procesorów zaplecza

Centralizacja certyfikatów X.509, protokoły TLS 1.2/1.3 oraz scenariusz re-enkrypcji

  • Istota terminacji TLS (TLS Offloading): serwer Reverse Proxy zestawia i kończy szyfrowane połączenie HTTPS z klientem zewnętrznym; ruch w zaufanej sieci wewnętrznej do backendu przekazywany jest protokołem otwartym (HTTP) lub w odrębnym tunelu.
  • Korzyści inżynierskie i operacyjne:
    • Oszczędność zasobów CPU: serwery aplikacji nie wykonują operacji kryptograficznych (ECDHE, RSA), rezerwując moc dla kodu biznesowego.
    • Centralizacja zarządzania kluczami i certyfikatami: pojedynczy punkt instalacji certyfikatów X.509; automatyzacja odnawiania za pomocą protokołu ACME (Let's Encrypt / Certbot).
    • Wgląd L7: możliwość inspekcji nagłówków, buforowania odpowiedzi i filtracji WAF.
  • Konfiguracja w Nginx:
    listen 443 ssl; (protokół HTTP/2 włącza osobna dyrektywa http2 on; parametr http2 w listen jest przestarzały od Nginx 1.25.1)
    ssl_certificate     /etc/ssl/certs/domena.crt;
    ssl_certificate_key /etc/ssl/private/domena.key;
    ssl_protocols TLSv1.2 TLSv1.3;
    ssl_ciphers HIGH:!aNULL:!MD5;
  • Rygory bezpieczeństwa (TLS Re-encryption): w sektorach bankowym i medycznym (normy PCI-DSS, wymogi KNF i DORA, zasady RODO) wymagane jest szyfrowanie na całej trasie (End-to-End); proxy szyfruje ruch do backendu przy użyciu wewnętrznego CA.
SSL/TLS termination na reverse proxy: Slajd przedstawia zagadnienie Terminacja kryptograficzna i odciążenie procesorów zaplecza w ramach tematu SSL/TLS termination na reverse proxy na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
SSL/TLS termination na reverse proxy
30/50
Porównanie: L4 vs L7 proxy w kontekście load balancingu
Cel slajdu: Slajd omawia zagadnienie „Porównanie: L4 vs L7 proxy w kontekście load balancingu” w kontekście: Zestawienie analityczne trybów TCP (L4) i HTTP (L7).

Zestawienie analityczne trybów TCP (L4) i HTTP (L7)

Kryteria wyboru właściwej warstwy pośrednictwa w projekcie sieciowym

  • Cecha operacyjna Tryb L4 (Transportowy / TCP) Tryb L7 (Aplikacyjny / HTTP)
    Podstawa routingu Adresy IP i porty TCP/UDP (krotka sieciowa) Metoda HTTP, ścieżka URI, nagłówek Host, ciasteczka
    Wgląd w treść Brak (nieprzezroczysty strumień bajtów) Pełny wgląd w nagłówki, treść JSON/XML, parametry
    Terminacja TLS Brak (lub proste przekazywanie SNI w TCP) Pełna terminacja, inspekcja certyfikatów, re-enkrypcja
    Buforowanie i kompresja Całkowicie niemożliwe Buforowanie odpowiedzi (RFC 9111), kompresja gzip/br
    Wydajność i opóźnienia Ekstremalna (>1 mln pakietów/s, minimalne opóźnienia) Bardzo wysoka (narzut zależny od parsowania tekstu)
    Implementacja wzorcowa HAProxy mode tcp, Nginx stream, LVS/IPVS HAProxy mode http, Nginx http, Envoy, Traefik
    Typowe scenariusze Klastry bazodanowe (MySQL, PostgreSQL), LDAP, MQTT Aplikacje WWW, mikrousługi REST API, WebSockets
Porównanie: L4 vs L7 proxy w kontekście load balancingu: Slajd przedstawia zagadnienie Zestawienie analityczne trybów TCP (L4) i HTTP (L7) w ramach tematu Porównanie: L4 vs L7 proxy w kontekście load balancingu na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
Porównanie: L4 vs L7 proxy w kontekście load balancingu
31/50
Nginx jako Reverse Proxy – architektura i kompilacja
Cel slajdu: Slajd omawia zagadnienie „Nginx jako Reverse Proxy – architektura i kompilacja” w kontekście: Asynchroniczny model sterowany zdarzeniami i porównanie z Apache.

Asynchroniczny model sterowany zdarzeniami i porównanie z Apache

Wieloprocesowa architektura Event-Driven radząca sobie z problemem C10K

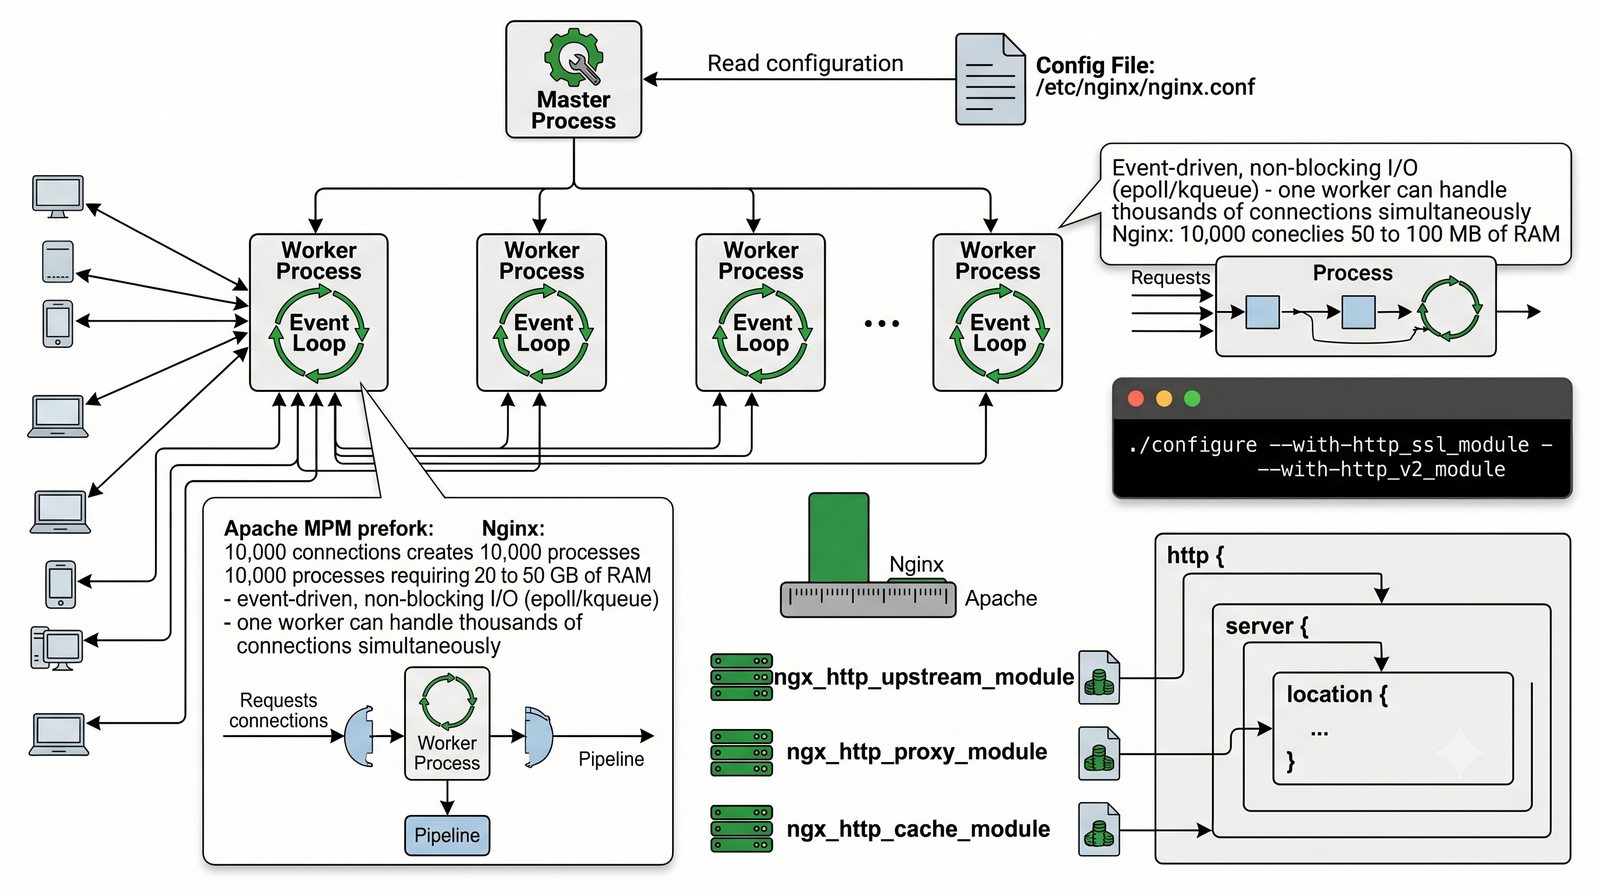
  • Architektura Master–Worker:
    • Proces nadrzędny (master process): odczytuje konfigurację, zarządza uprawnieniami, otwiera uprzywilejowane gniazda (porty 80/443) i kontroluje procesy robocze.
    • Procesy robocze (worker processes): jednowątkowe procesy nieblokujące, przypisywane zazwyczaj w relacji 1:1 do fizycznych rdzeni procesora (worker_cpu_affinity).
  • Mechanizm Event-Driven I/O:
    • Wykorzystanie skalowalnych mechanizmów powiadamiania jądra: epoll w systemie Linux, kqueue w systemach FreeBSD.
    • Jeden proces roboczy obsługuje dziesiątki tysięcy jednoczesnych połączeń bez narzutu na przełączanie kontekstu wątków.
  • Porównanie z Apache HTTP Server (mod_proxy):
    • Tradycyjny Apache w modelu prefork lub worker dedykuje proces/wątek na każde połączenie, co przy 10 000 połączeń prowadzi do wyczerpania pamięci RAM.
    • Nginx jako lekki pośrednik na brzegu sieci (Reverse Proxy) chroni serwery Apache lub aplikacyjne przed przeciążeniem powolnymi klientami.
Nginx jako Reverse Proxy – architektura i kompilacja: Slajd przedstawia zagadnienie Asynchroniczny model sterowany zdarzeniami i porównanie z Apache w ramach tematu Nginx jako Reverse Proxy – architektura i kompilacja na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi Nginx.
Nginx jako Reverse Proxy - architektura i kompilacja
32/50
Blok upstream – definiowanie grupy zapleczowej
Cel slajdu: Slajd omawia zagadnienie „Blok upstream – definiowanie grupy zapleczowej” w kontekście: Konfiguracja puli serwerów aplikacji i zaawansowanych parametrów węzłów.

Konfiguracja puli serwerów aplikacji i zaawansowanych parametrów węzłów

Definiowanie klastra maszyn w module ngx_http_upstream_module

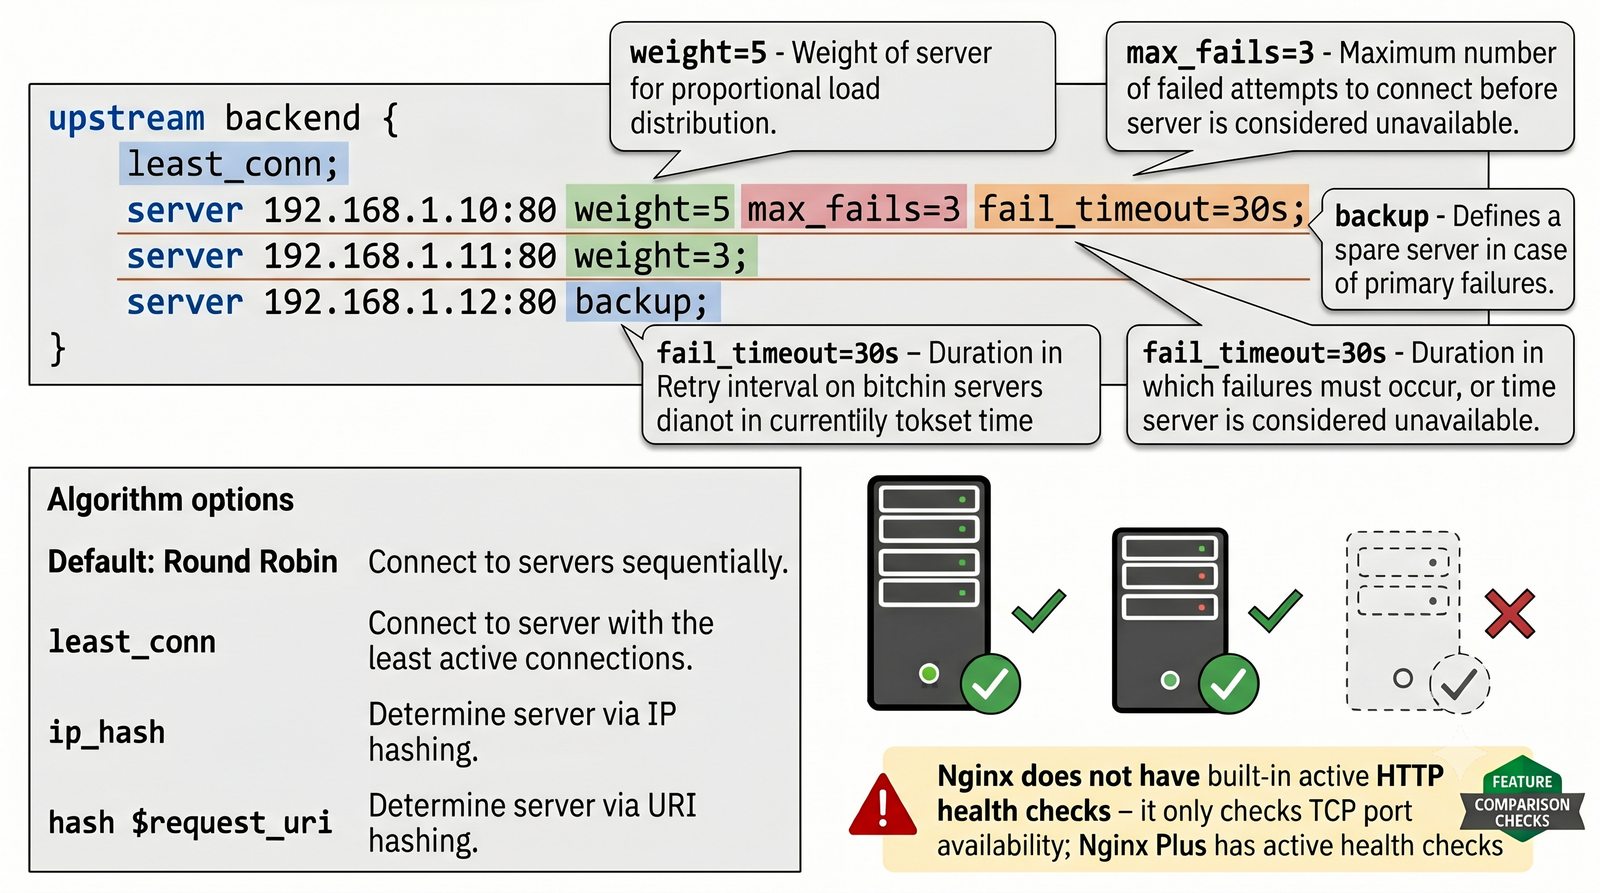
  • Struktura bloku upstream (kontekst http): logiczne zgrupowanie serwerów zaplecza, do których odwołują się reguły routingu:
    upstream backend_cluster {
        least_conn;
        server 192.168.10.11:8080 weight=3 max_fails=3 fail_timeout=15s;
        server 192.168.10.12:8080 weight=2 max_fails=3 fail_timeout=15s;
        server 192.168.10.13:8080 backup;
        server 192.168.10.14:8080 down;
        keepalive 32;
    }
  • Znaczenie kluczowych parametrów dyrektywy server:
    • weight=N: względna waga maszyny w klastrze (domyślnie 1);
    • max_fails=N: liczba nieudanych prób połączenia, po której węzeł jest uznawany za niesprawny;
    • fail_timeout=Ns: czas wykluczenia węzła z puli oraz okno zliczania błędów;
    • backup: serwer zapasowy, otrzymujący ruch wyłącznie po awarii wszystkich serwerów głównych;
    • down: trwałe, ręczne wyłączenie serwera z obsługi (np. na czas prac konserwacyjnych).
  • Dyrektywa keepalive 32;: utrzymywanie puli otwartych połączeń TCP do backendu, eliminujące narzut trzykrotnego uzgadniania połączenia TCP przy każdym zapytaniu.
Blok upstream – definiowanie grupy zapleczowej: Slajd przedstawia zagadnienie Konfiguracja puli serwerów aplikacji i zaawansowanych parametrów węzłów w ramach tematu Blok upstream – definiowanie grupy zapleczowej na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi Nginx.
Blok upstream - definiowanie grupy zapleczowej
33/50
proxy_pass – przekazanie żądania do backendu
Cel slajdu: Slajd omawia zagadnienie „proxy_pass – przekazanie żądania do backendu” w kontekście: Mechanizm translacji URI, manipulacja nagłówkami i proxying WebSocket.

Mechanizm translacji URI, manipulacja nagłówkami i proxying WebSocket

Kluczowa dyrektywa przekazywania ruchu i obsługa protokołów czasu rzeczywistego

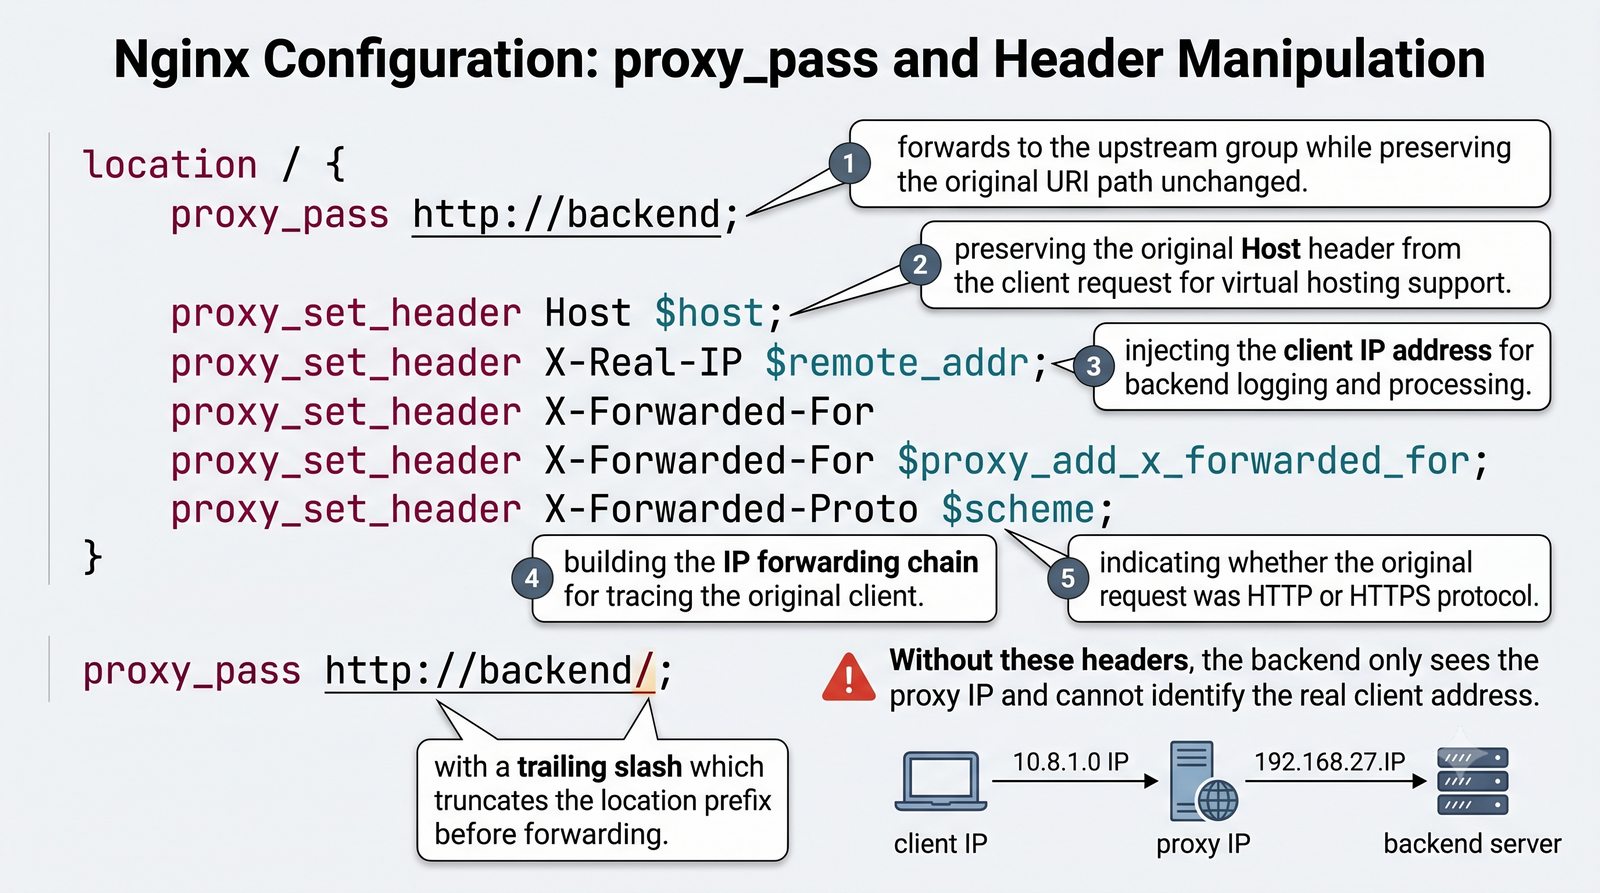
  • Składnia i reguła ukośnika (Trailing Slash):
    • proxy_pass http://backend;: Nginx przekazuje żądany URI w niezmienionej postaci (np. /api/v1/users trafia do backendu jako /api/v1/users).
    • proxy_pass http://backend/; (z ukośnikiem na końcu): Nginx usuwa fragment URI pasujący do wzorca location i zastępuje go wskazaną ścieżką (translacja URI).
  • Zarządzanie nagłówkami żądania (proxy_set_header):
    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
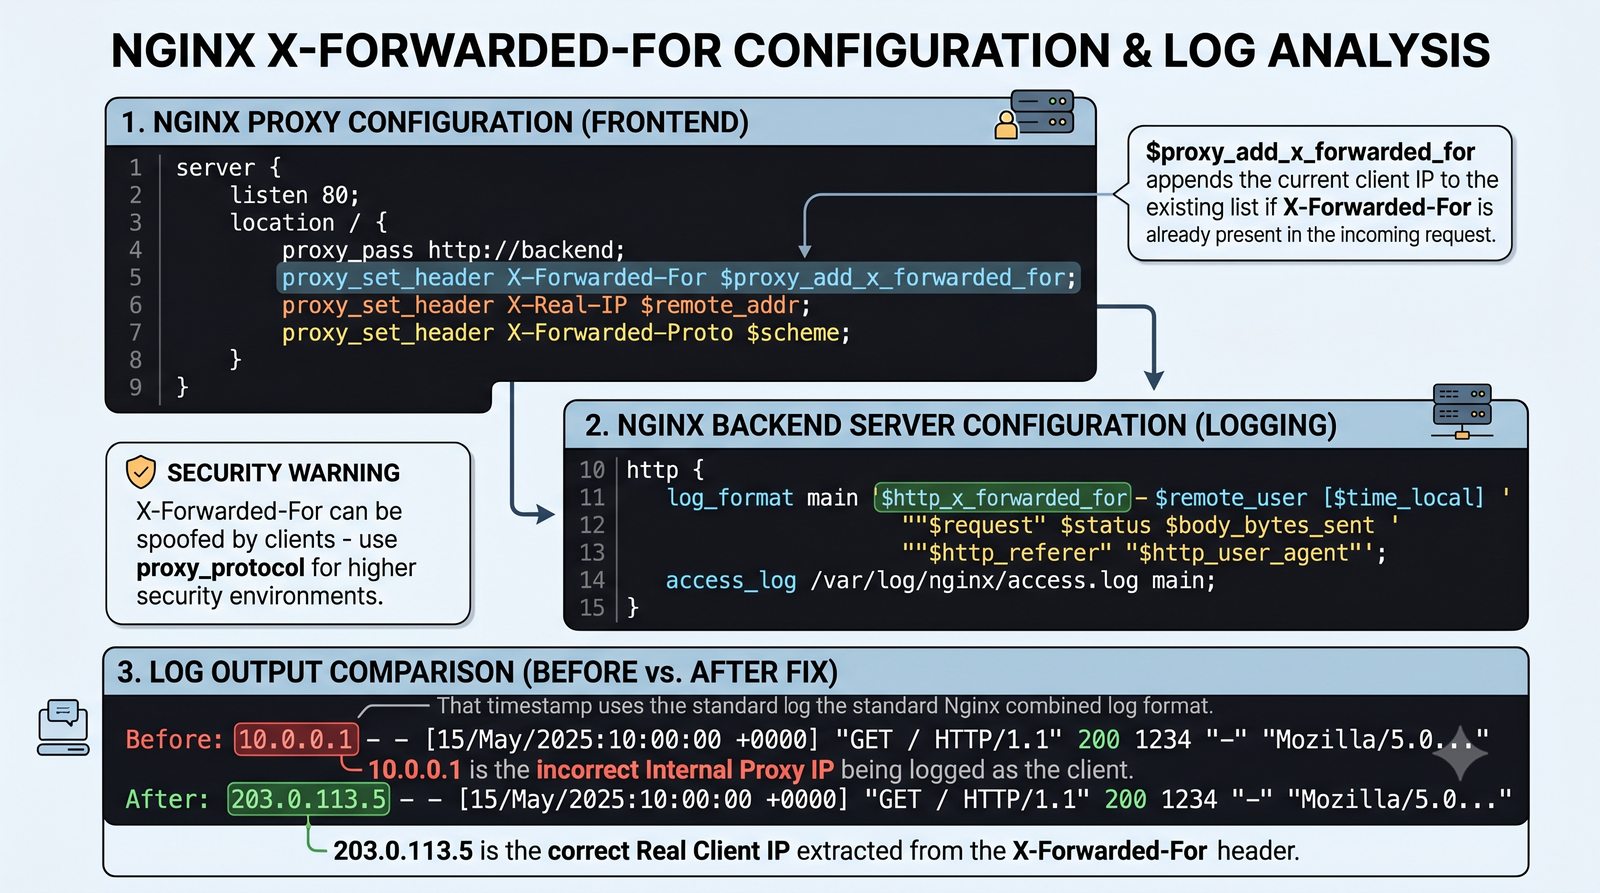
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Forwarded-Proto $scheme;
  • Obsługa protokołu WebSocket (RFC 6455):
    • WebSocket wymaga podniesienia protokołu (HTTP 101 Switching Protocols); Nginx domyślnie zamyka takie połączenia.
    • Wymagana jawna rekonfiguracja:
      proxy_http_version 1.1;
      proxy_set_header Upgrade $http_upgrade;
      proxy_set_header Connection "upgrade";
proxy_pass – przekazanie żądania do backendu: Slajd przedstawia zagadnienie Mechanizm translacji URI, manipulacja nagłówkami i proxying WebSocket w ramach tematu proxy_pass – przekazanie żądania do backendu na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi Nginx.
proxy_pass - przekazanie zadania do backendu
34/50
Pełna konfiguracja Nginx Reverse Proxy z load balancing
Cel slajdu: Slajd omawia zagadnienie „Pełna konfiguracja Nginx Reverse Proxy z load balancing” w kontekście: Wzorcowy, produkcyjny plik konfiguracyjny z kompresją i TLS.

Wzorcowy, produkcyjny plik konfiguracyjny z kompresją i TLS

Integracja upstreama, równoważenia, nagłówków tożsamości i optymalizacji TCP

  • # /etc/nginx/conf.d/production_lb.conf
    upstream app_cluster {
        least_conn;
        server 192.168.10.11:8080 weight=3 max_fails=2 fail_timeout=10s;
        server 192.168.10.12:8080 weight=2 max_fails=2 fail_timeout=10s;
        server 192.168.10.13:8080 backup;
        keepalive 32;
    }
    
    server {
        listen 443 ssl; (protokół HTTP/2 włącza osobna dyrektywa http2 on;)
        server_name portal.example.pl;
    
        ssl_certificate     /etc/ssl/certs/portal.crt;
        ssl_certificate_key /etc/ssl/private/portal.key;
        ssl_protocols TLSv1.2 TLSv1.3;
    
        gzip on;
        gzip_types text/plain text/css application/json application/javascript;
    
        location / {
            proxy_pass http://app_cluster;
            proxy_http_version 1.1;
            proxy_set_header Connection "";
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
            proxy_set_header X-Forwarded-Proto $scheme;
            proxy_set_header Forwarded "for=$remote_addr;proto=$scheme;host=$host";
            proxy_next_upstream error timeout http_502 http_503;
        }
    }
Pełna konfiguracja Nginx Reverse Proxy z load balancing: Slajd przedstawia zagadnienie Wzorcowy, produkcyjny plik konfiguracyjny z kompresją i TLS w ramach tematu Pełna konfiguracja Nginx Reverse Proxy z load balancing na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi Nginx.
Pełna konfiguracja Nginx Reverse Proxy z load balancing
35/50
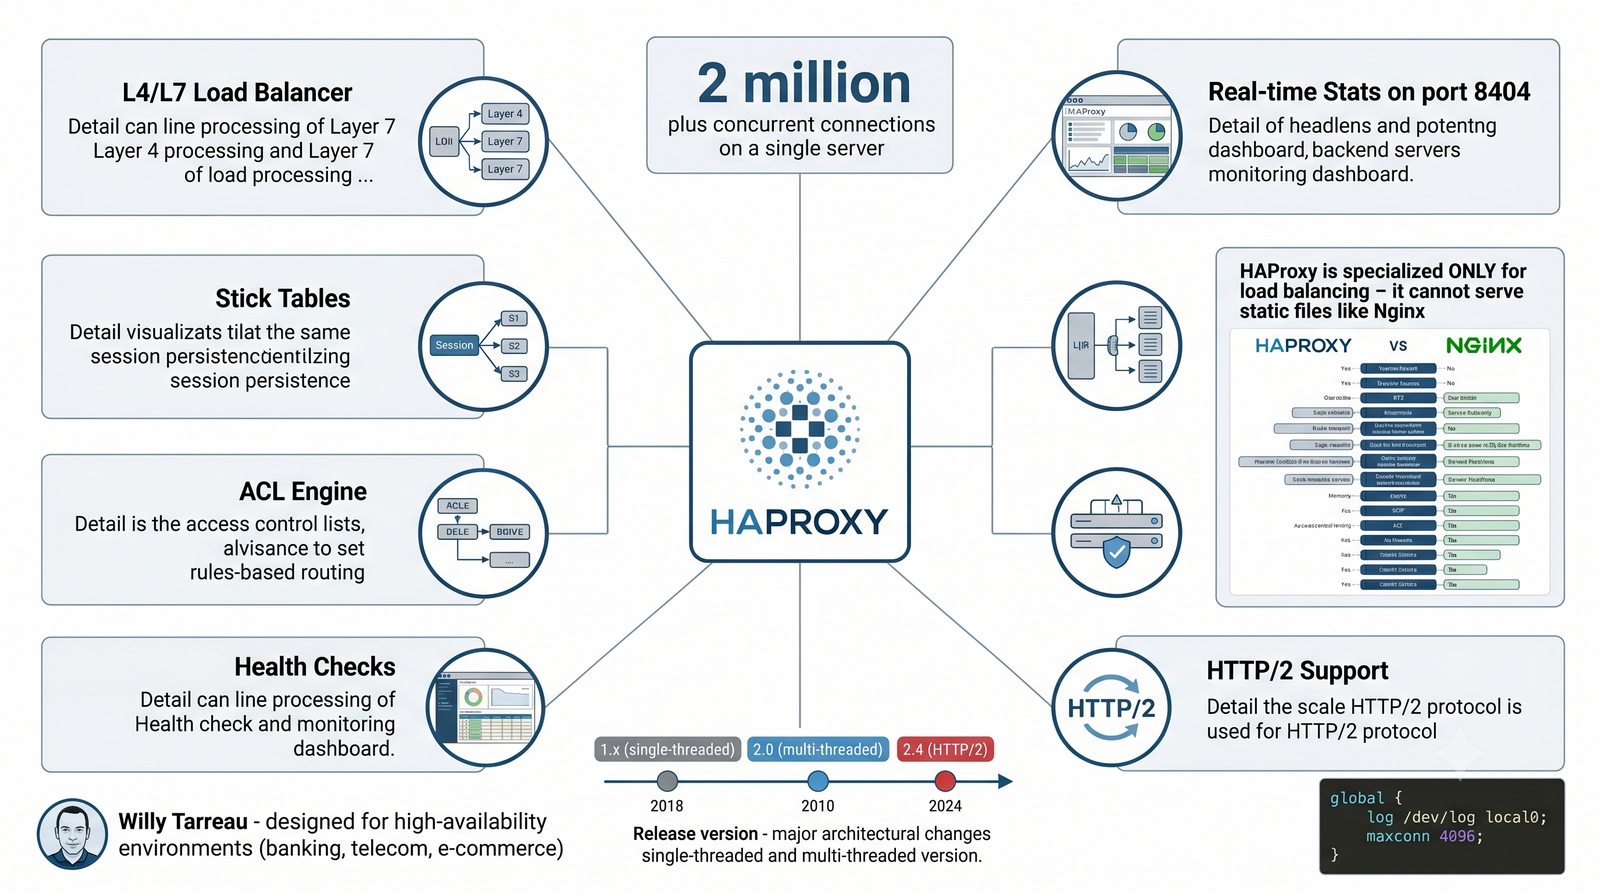
HAProxy – dedykowany balancer warstw L4 i L7
Cel slajdu: Slajd omawia zagadnienie „HAProxy – dedykowany balancer warstw L4 i L7” w kontekście: Dedykowany demon równoważenia obciążenia i jego specyfikacja.

Dedykowany demon równoważenia obciążenia i jego specyfikacja

Wyspecjalizowane oprogramowanie High Availability Proxy autorstwa Willy'ego Tarreau

  • Wąska specjalizacja inżynierska: w przeciwieństwie do Nginx (będącego serwerem WWW z funkcją proxy), HAProxy to program zaprojektowany wyłącznie do równoważenia obciążenia i pośrednictwa L4/L7; nie serwuje plików statycznych z dysku.
  • Maksymalna wydajność i determinizm:
    • Kod źródłowy w czystym języku C, skrajnie zoptymalizowany pod kątem braku blokad pamięciowych i wywołań systemowych (zero-copy data forwarding przy użyciu splice()).
    • Obsługa setek tysięcy żądań na sekundę przy sub-milisekundowych czasach reakcji.
  • Unikalne możliwości technologiczne:
    • Stick Tables: zaawansowane tablice w pamięci RAM śledzące zachowanie klientów w czasie rzeczywistym (np. wykrywanie ataków DDoS, zliczanie błędów HTTP per IP).
    • Aktywne badanie stanu zdrowia: wbudowane mechanizmy wysyłania syntetycznych żądań HTTP/TCP do backendu.
    • Zarządzanie dynamiczne: interfejs gniazda UNIX (Runtime API) oraz Data Plane API do rekonfiguracji bez przeładowania procesu.
HAProxy – dedykowany balancer warstw L4 i L7: Slajd przedstawia zagadnienie Dedykowany demon równoważenia obciążenia i jego specyfikacja w ramach tematu HAProxy – dedykowany balancer warstw L4 i L7 na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
HAProxy - potężniejszy brat z wyższego rzędu
36/50
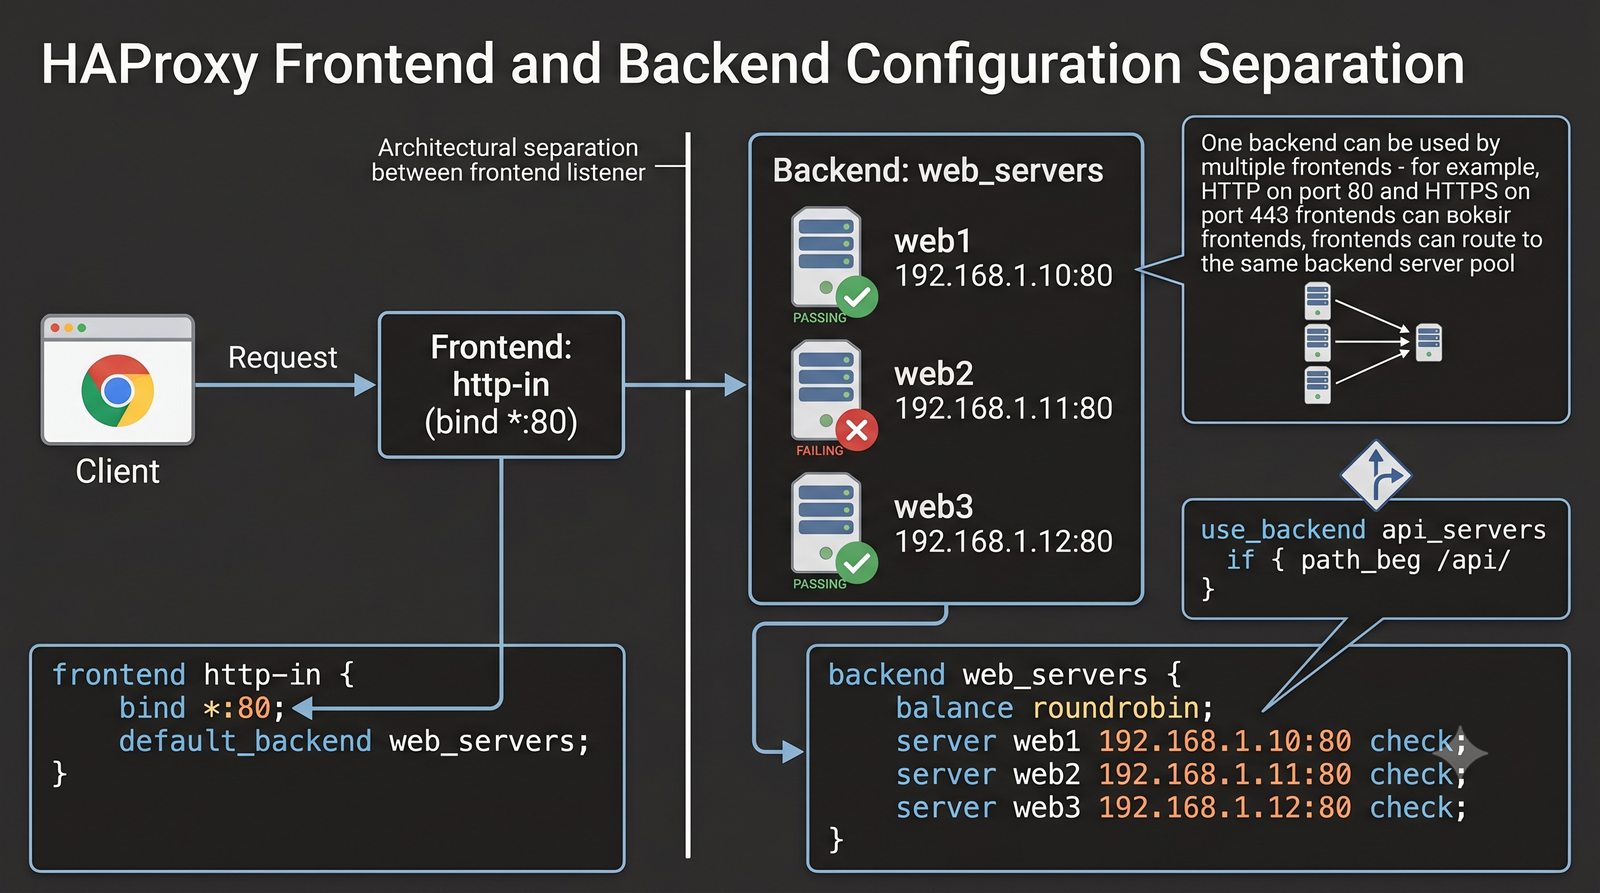
Architektura HAProxy: frontend i backend
Cel slajdu: Slajd omawia zagadnienie „Architektura HAProxy: frontend i backend” w kontekście: Modularny podział konfiguracji na sekcje logiczne.

Modularny podział konfiguracji na sekcje logiczne

Separacja punktów nasłuchu, reguł routingu i definicji serwerów docelowych

  • Sekcja global: parametry procesu na poziomie systemu operacyjnego (użytkownik, grupa, wielowątkowość nbthread, limity połączeń maxconn, gniazdo Runtime API).
  • Sekcja defaults: wartości domyślne dziedziczone przez kolejne bloki (tryb mode http/tcp, timeouty połączeń: timeout connect, timeout client, timeout server).
  • Sekcja frontend:
    • Punkt wejściowy dla klientów: adresy i porty nasłuchu (bind *:80, bind *:443 ssl...).
    • Inspekcja żądań, ewaluacja list kontroli dostępu (ACL).
    • Kierowanie ruchu do właściwego backendu: use_backend oraz default_backend.
  • Sekcja backend:
    • Definicja klastra maszyn docelowych (dyrektywy server).
    • Wybór algorytmu równoważenia (balance roundrobin / leastconn / source).
    • Konfiguracja health checków (option httpchk) i lepkości sesji (cookie).
  • Sekcja listen: zwarta kombinacja sekcji frontend i backend (często stosowana dla panelu statystyk).
Architektura HAProxy: frontend i backend: Slajd przedstawia zagadnienie Modularny podział konfiguracji na sekcje logiczne w ramach tematu Architektura HAProxy: frontend i backend na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
Architektura HAProxy: frontend i backend
37/50
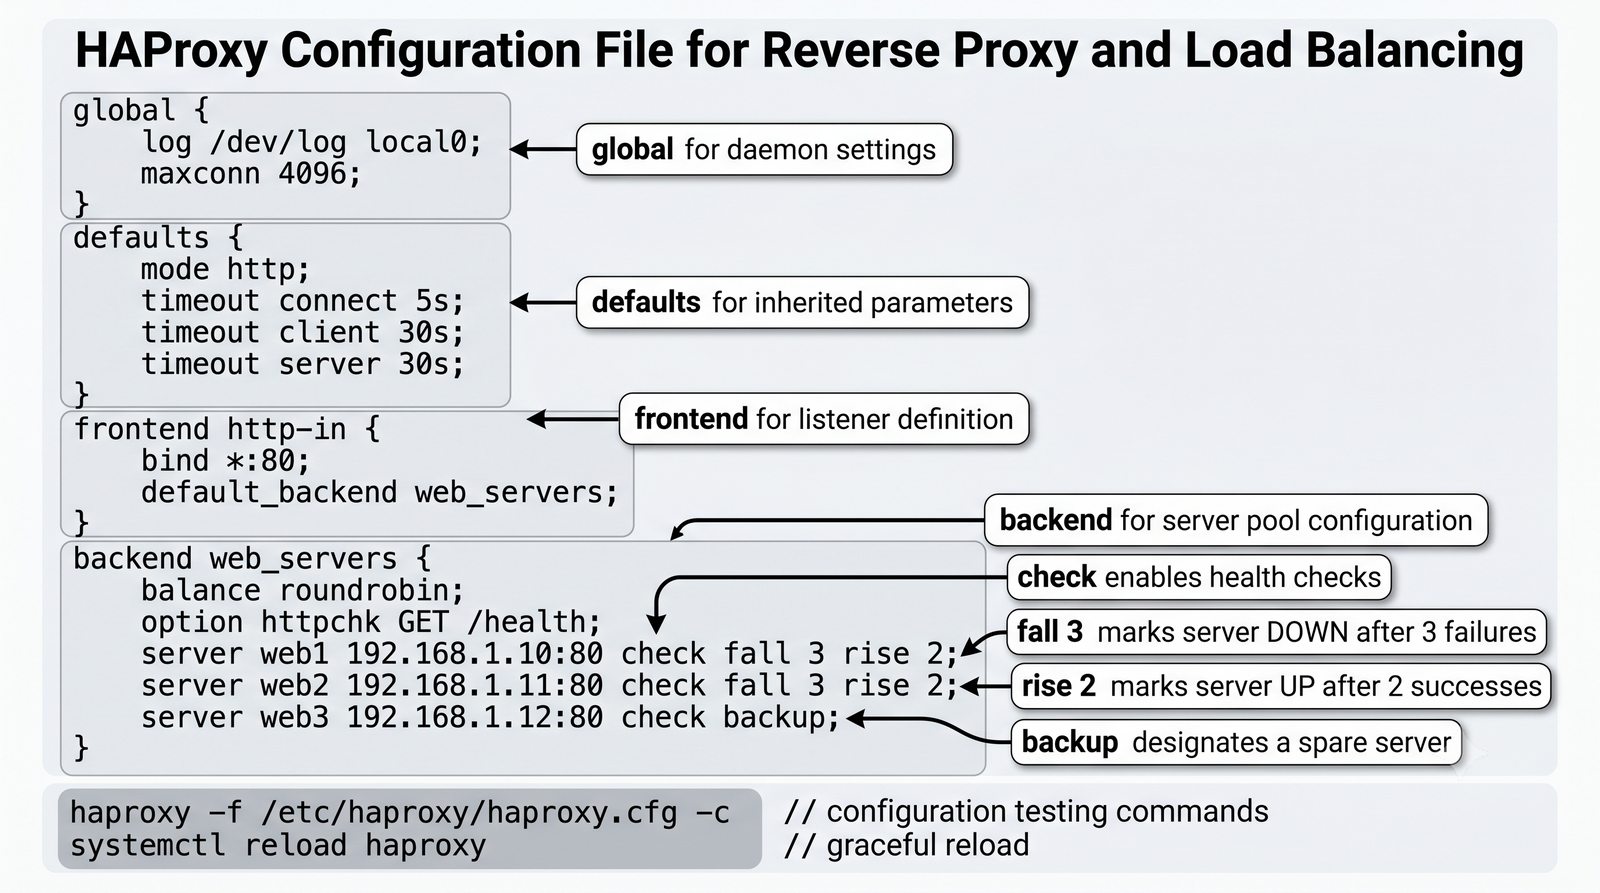
Konfiguracja HAProxy Reverse Proxy z load balancing
Cel slajdu: Slajd omawia zagadnienie „Konfiguracja HAProxy Reverse Proxy z load balancing” w kontekście: Wzorcowy plik konfiguracyjny z aktywnym health checkiem i algorytmem rotacji.

Wzorcowy plik konfiguracyjny z aktywnym health checkiem i algorytmem rotacji

Produkcyjna definicja sekcji global, defaults, frontend oraz backend

  • # /etc/haproxy/haproxy.cfg
    global
        log /dev/log local0 info
        maxconn 10000
        user haproxy
        group haproxy
        stats socket /run/haproxy/admin.sock mode 660 level admin
    
    defaults
        log global
        mode http
        option httplog
        option dontlognull
        timeout connect 5000ms
        timeout client  50000ms
        timeout server  50000ms
        timeout tunnel  1h
    
    frontend fe_http_in
        bind *:80
        bind *:443 ssl crt /etc/haproxy/certs/bundle.pem alpn h2,http/1.1
        redirect scheme https code 301 if !{ ssl_fc }
        default_backend be_app_cluster
    
    backend be_app_cluster
        mode http
        balance roundrobin
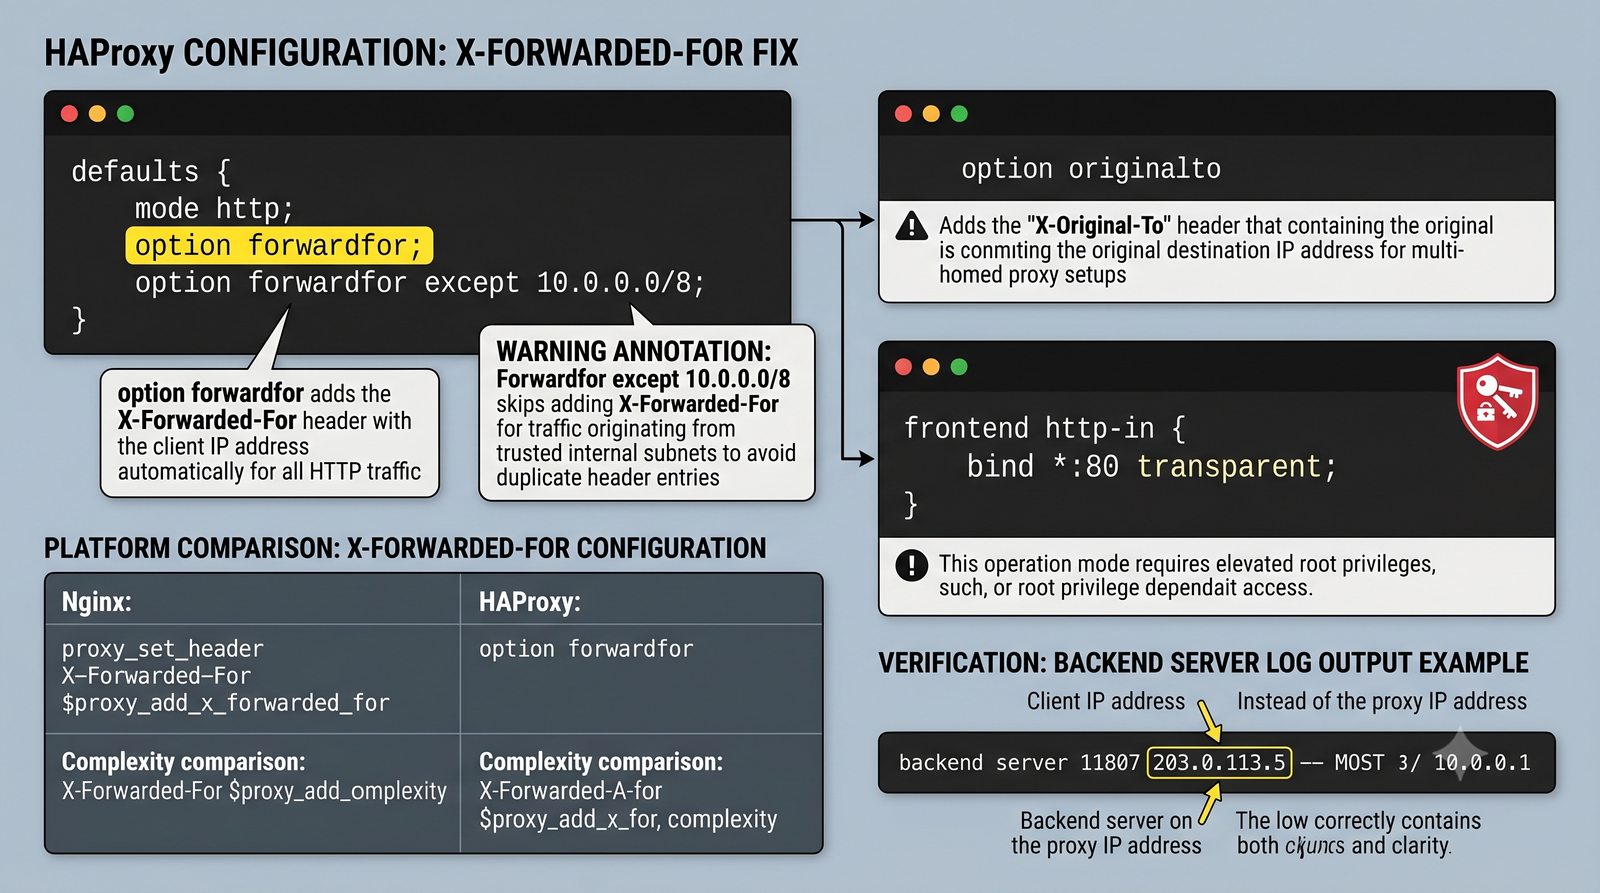
        option forwardfor
        option httpchk GET /health HTTP/1.1
    Host: localhost
        http-check expect status 200
        server web01 192.168.10.11:8080 check inter 2000ms fall 3 rise 2 weight 3
        server web02 192.168.10.12:8080 check inter 2000ms fall 3 rise 2 weight 2
        server web03 192.168.10.13:8080 check backup
Konfiguracja HAProxy Reverse Proxy z load balancing: Slajd przedstawia zagadnienie Wzorcowy plik konfiguracyjny z aktywnym health checkiem i algorytmem rotacji w ramach tematu Konfiguracja HAProxy Reverse Proxy z load balancing na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
Konfiguracja HAProxy Reverse Proxy z load balancing
38/50
HAProxy statystyki i monitoring
Cel slajdu: Slajd omawia zagadnienie „HAProxy statystyki i monitoring” w kontekście: Wbudowany panel telemetryczny w czasie rzeczywistym i interfejsy API.

Wbudowany panel telemetryczny w czasie rzeczywistym i interfejsy API

Bieżący podgląd stanu klastra, metryk wydajnościowych i zarządzanie węzłami

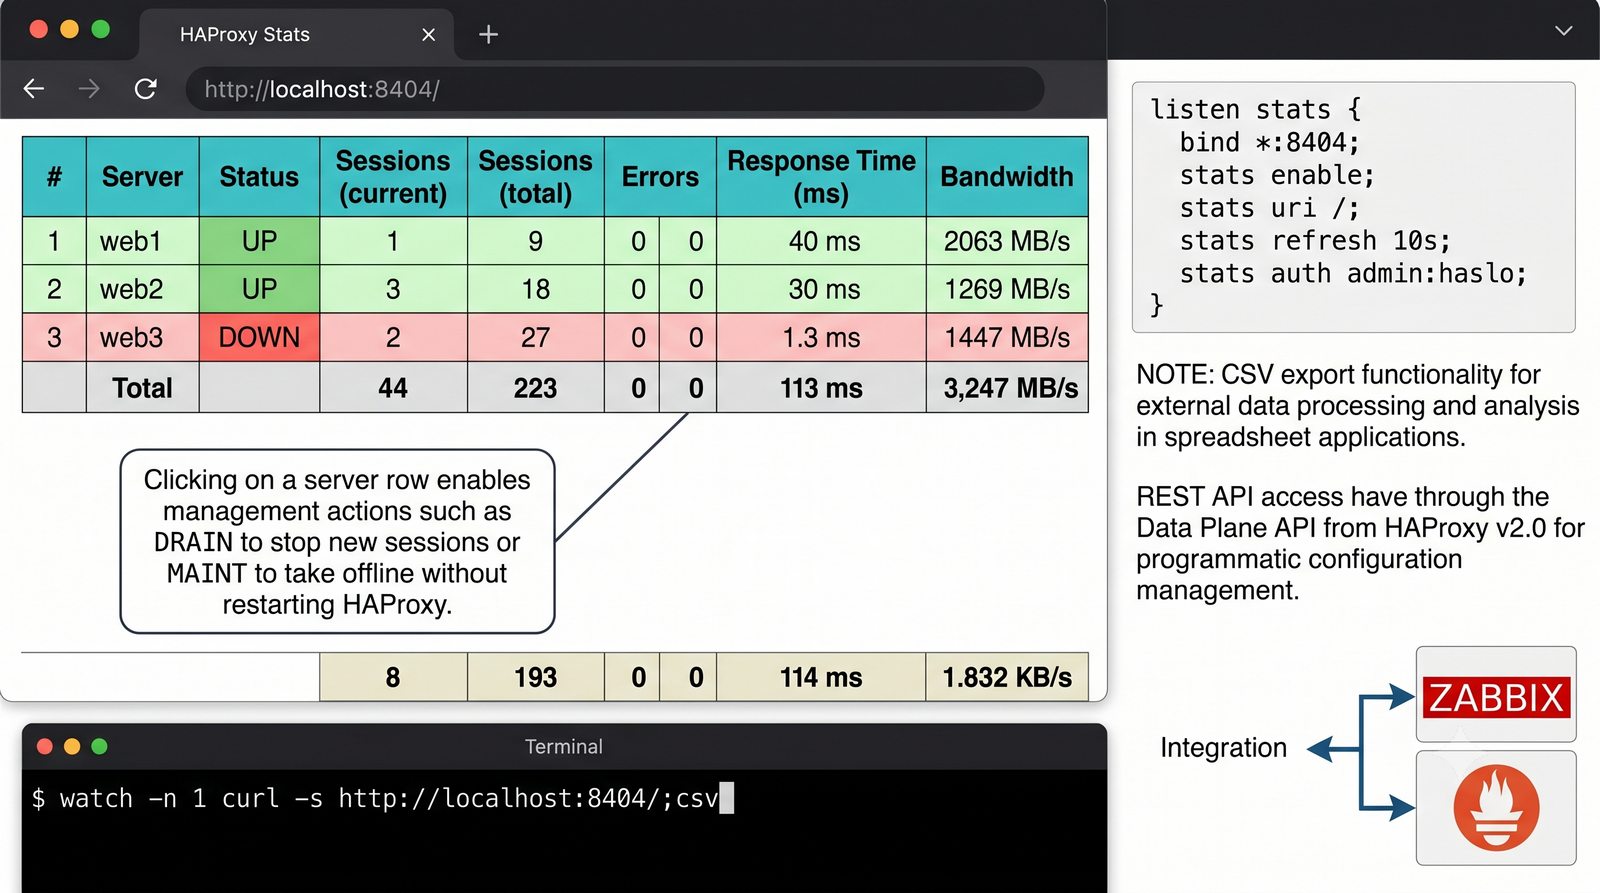
  • Wbudowany interfejs WWW (Stats Engine):
    listen stats
        bind *:8404
        stats enable
        stats uri /stats
        stats refresh 10s
        stats auth <nazwa_użytkownika>:<hasło>
        stats admin if TRUE
  • Kluczowe metryki prezentowane w panelu:
    • Status węzła: UP (zielony), DOWN (czerwony), NOLB/DRAIN (żółty – wygaszanie sesji), MAINT (niebieski – prace serwisowe);
    • Liczba sesji: bieżące (cur), szczytowe (max), skonfigurowany limit (limit), sumaryczne (tot);
    • Statystyka błędów: błędy połączeń backendu (econ), błędy odpowiedzi (eresp), kody HTTP (2xx, 3xx, 4xx, 5xx);
    • Czasy opóźnień: czas w kolejce (qtime), czas połączenia (ctime), czas odpowiedzi (rtime), czas całkowity (ttime).
  • Zarządzanie operacyjne i integracje: możliwość dynamicznego przełączania serwerów w tryb MAINT/DRAIN bezpośrednio z panelu oraz eksport metryk w formatach CSV i Prometheus (punkt końcowy /metrics od HAProxy 2.0).
HAProxy statystyki i monitoring: Slajd przedstawia zagadnienie Wbudowany panel telemetryczny w czasie rzeczywistym i interfejsy API w ramach tematu HAProxy statystyki i monitoring na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
HAProxy statystyki i monitoring
39/50
LAB: Przygotowanie środowiska testowego
Cel slajdu: Slajd omawia zagadnienie „LAB: Przygotowanie środowiska testowego” w kontekście: Architektura poligonu badawczego i założenia laboratoryjne.

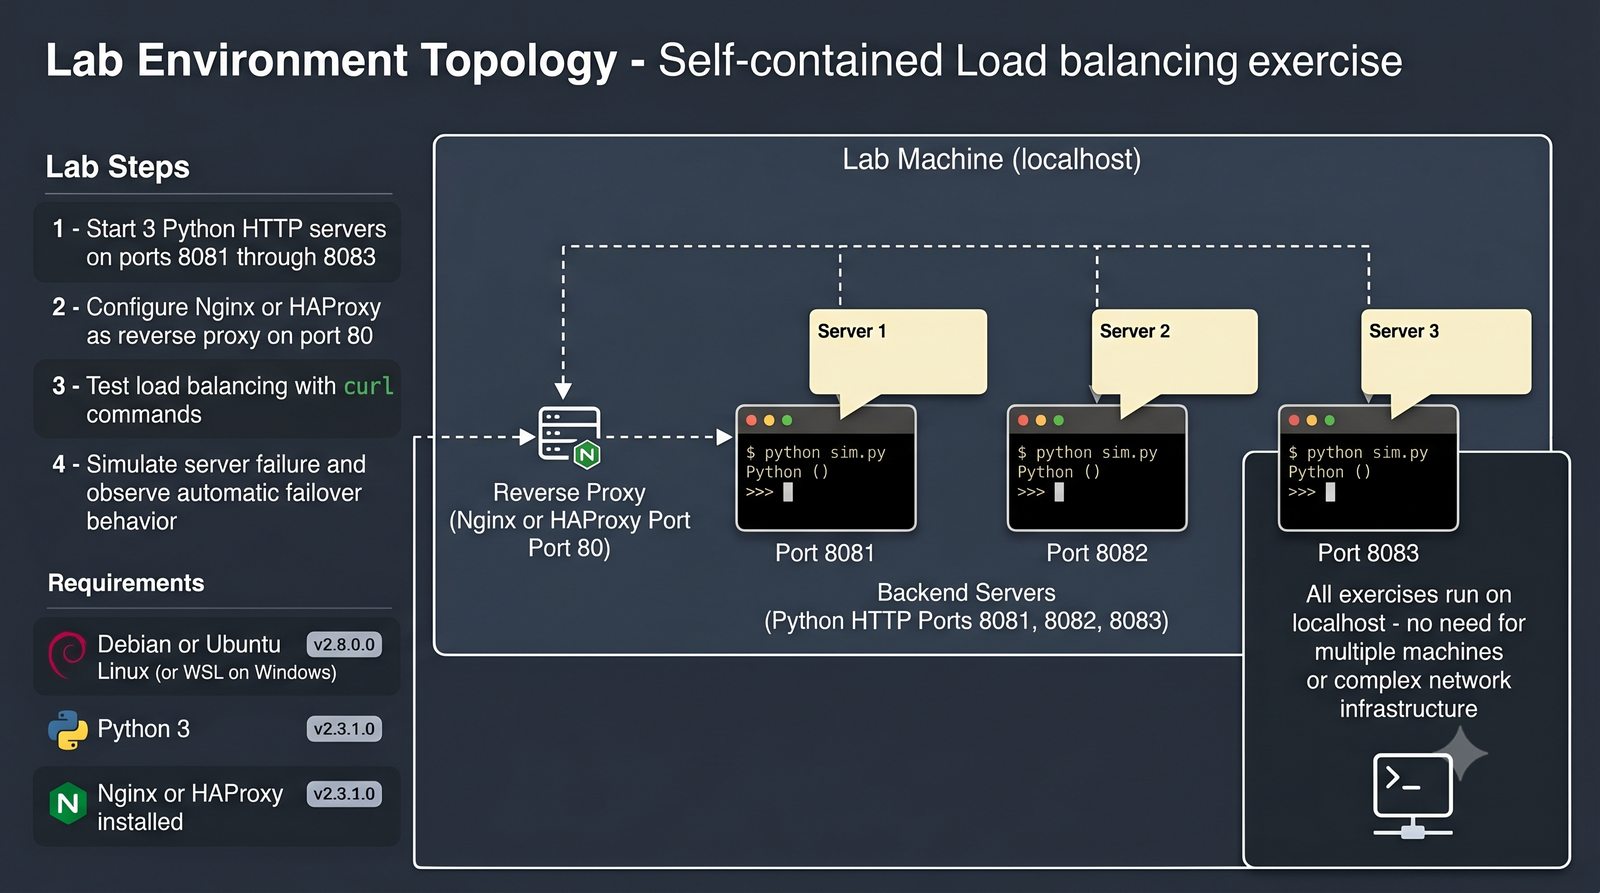
Architektura poligonu badawczego i założenia laboratoryjne

Symulacja klastra wysokiej dostępności na pojedynczej maszynie uniksowej

  • Cel ćwiczenia laboratoryjnego:
    • Praktyczne uruchomienie i konfiguracja klastra trzech niezależnych serwerów zaplecza (backend HTTP).
    • Wdrożenie serwera Reverse Proxy (Nginx / HAProxy) jako jedynego publicznego punktu wejściowego.
    • Empiryczne zbadanie działania algorytmów równoważenia obciążenia (Round Robin, Least Conn).
    • Przetestowanie zachowania klastra w warunkach symulowanej awarii węzła aplikacyjnego (Failover).
    • Weryfikacja i diagnostyka nagłówków identyfikacji tożsamości klienta (X-Forwarded-For).
  • Topologia logiczna środowiska laboratoryjnego:
    • Serwer Brzegowy (Reverse Proxy): port 8080 (lub 80) ↔ punkt styku z klientem;
    • Węzeł Zaplecza 1 (Backend Srv 1): nasłuch na porcie 8081 (odpowiedź unikalna: "Węzeł Produkcyjny 1");
    • Węzeł Zaplecza 2 (Backend Srv 2): nasłuch na porcie 8082 (odpowiedź unikalna: "Węzeł Produkcyjny 2");
    • Węzeł Zaplecza 3 (Backend Srv 3): nasłuch na porcie 8083 (odpowiedź unikalna: "Węzeł Produkcyjny 3").
  • Wymagania wstępne: system Linux (Debian, Ubuntu lub pokrewne), zainstalowany interpreter Python 3, pakiet curl oraz pakiety nginx i haproxy (np. sudo apt install nginx haproxy).
LAB: Przygotowanie środowiska testowego: Slajd przedstawia zagadnienie Architektura poligonu badawczego i założenia laboratoryjne w ramach tematu LAB: Przygotowanie środowiska testowego na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a środowisko testowe stanowią proste serwery Python http.server.
LAB: Przygotowanie środowiska testowego
40/50
LAB: Uruchomienie serwerów testowych
Cel slajdu: Slajd omawia zagadnienie „LAB: Uruchomienie serwerów testowych” w kontekście: Procedura powłoki Bash krok po kroku dla trzech procesów HTTP.

Procedura powłoki Bash krok po kroku dla trzech procesów HTTP

Przygotowanie struktur katalogów, stron identyfikacyjnych i uruchomienie w tle

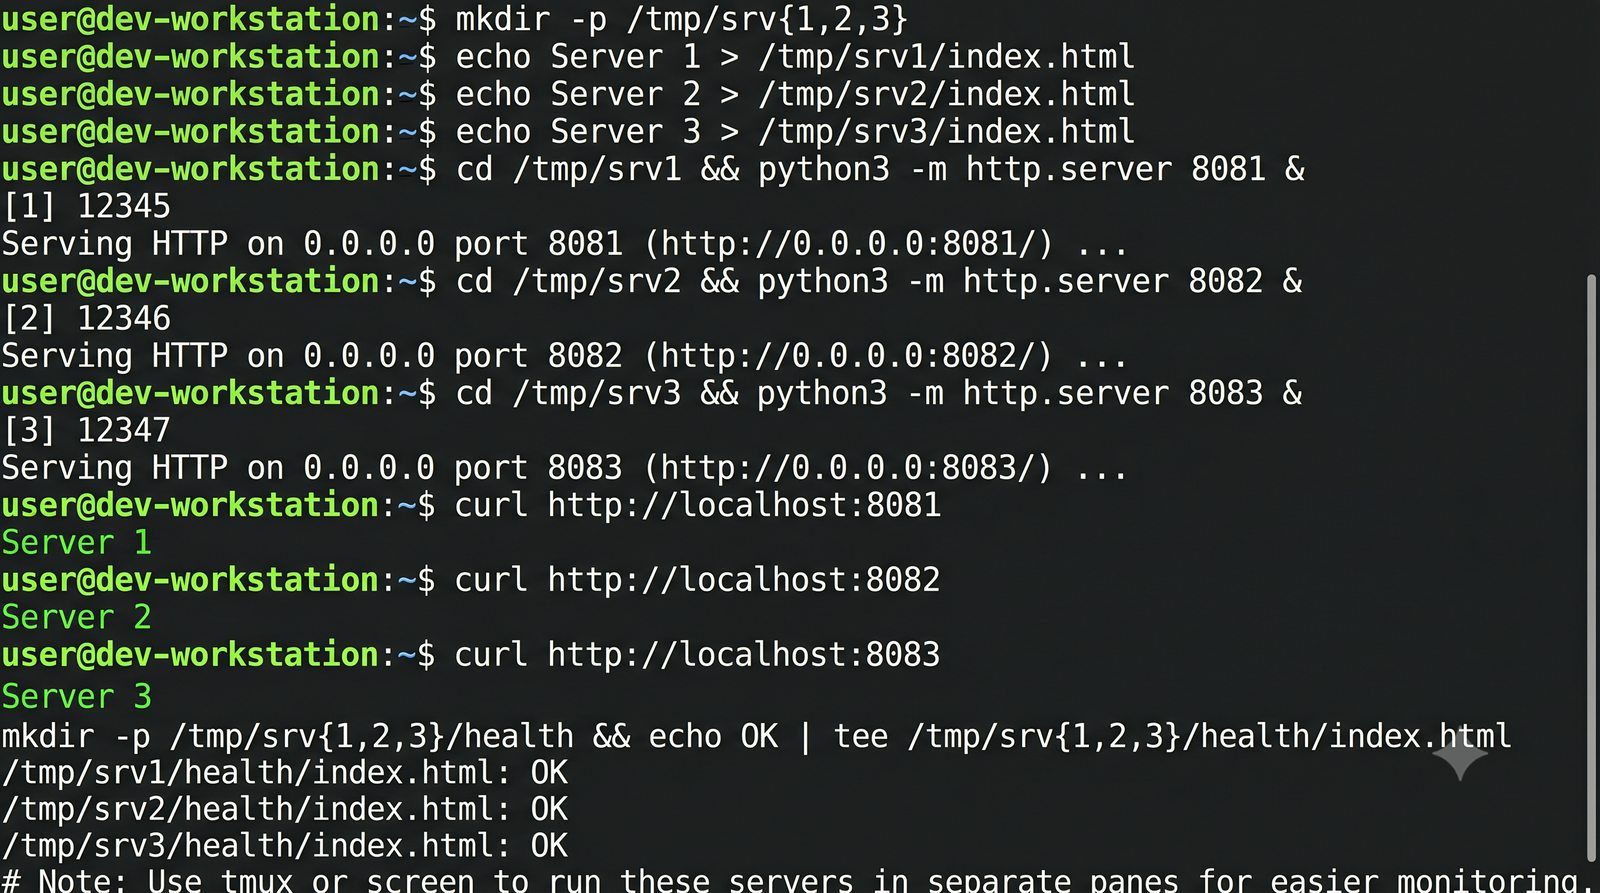
  • Krok 1: Utworzenie struktur katalogów dla backendów:
    mkdir -p /tmp/backend_srv{1,2,3}/health
  • Krok 2: Przygotowanie unikalnych plików odpowiedzi index.html:
    echo "Odpowiedź z węzła backendu: SERWER 1 (Port 8081)" > /tmp/backend_srv1/index.html
    echo "Odpowiedź z węzła backendu: SERWER 2 (Port 8082)" > /tmp/backend_srv2/index.html
    echo "Odpowiedź z węzła backendu: SERWER 3 (Port 8083)" > /tmp/backend_srv3/index.html
  • Krok 3: Przygotowanie punktu kontrolnego /health dla sond monitorujących:
    echo "STATUS_OK" | tee /tmp/backend_srv{1,2,3}/health/index.html (rozwijanie {1,2,3} wymaga powłoki bash)
  • Krok 4: Uruchomienie instancji serwerów HTTP w tle za pomocą Pythona:
    python3 -m http.server 8081 --directory /tmp/backend_srv1 > /dev/null 2>&1 &
    python3 -m http.server 8082 --directory /tmp/backend_srv2 > /dev/null 2>&1 &
    python3 -m http.server 8083 --directory /tmp/backend_srv3 > /dev/null 2>&1 &
  • Krok 5: Weryfikacja poprawności uruchomienia gniazd sieciowych:
    curl -s http://127.0.0.1:8081
    curl -s http://127.0.0.1:8082
    curl -s http://127.0.0.1:8083
LAB: Uruchomienie serwerów testowych: Slajd przedstawia zagadnienie Procedura powłoki Bash krok po kroku dla trzech procesów HTTP w ramach tematu LAB: Uruchomienie serwerów testowych na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a środowisko testowe stanowią proste serwery Python http.server.
LAB: Uruchomienie serwerów testowych
41/50
LAB: Konfiguracja Nginx Reverse Proxy
Cel slajdu: Slajd omawia zagadnienie „LAB: Konfiguracja Nginx Reverse Proxy” w kontekście: Praktyczna konfiguracja pośrednika odwrotnego na porcie 8080.

Praktyczna konfiguracja pośrednika odwrotnego na porcie 8080

Wdrożenie bloku upstream i reguł proxy_pass dla klastra testowego

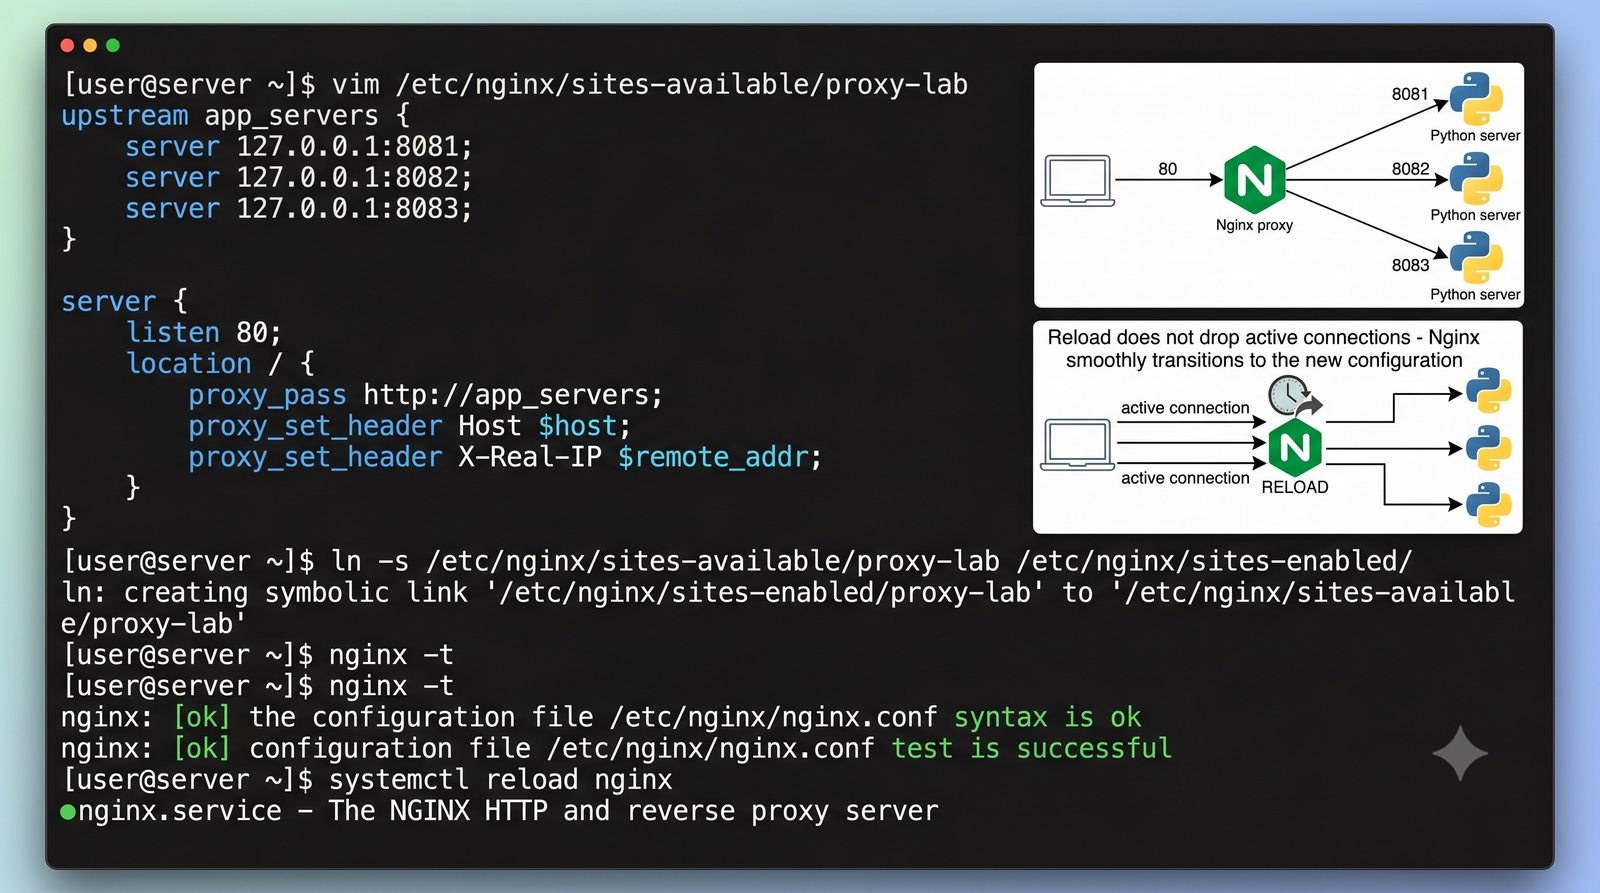
  • Krok 1: Utworzenie pliku konfiguracyjnego w katalogu Nginx (po instalacji pakietu nginx, zapis wymaga uprawnień administratora):
    sudo mkdir -p /etc/nginx/conf.d
    sudo tee /etc/nginx/conf.d/lab_balancer.conf << 'EOF'
    upstream backend_lab {
        server 127.0.0.1:8081;
        server 127.0.0.1:8082;
        server 127.0.0.1:8083;
    }
    
    server {
        listen 8080;
        server_name localhost;
    
        location / {
            proxy_pass http://backend_lab;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
            proxy_set_header X-Forwarded-Proto $scheme;
        }
    }
    EOF
  • Krok 2: Walidacja poprawności składni konfiguracji: sudo nginx -t
  • Krok 3: Przeładowanie procesu Nginx bez przerywania sesji: sudo systemctl reload nginx
  • Krok 4: Weryfikacja pierwszego połączenia przez proxy: curl -s http://localhost:8080
LAB: Konfiguracja Nginx Reverse Proxy: Slajd przedstawia zagadnienie Praktyczna konfiguracja pośrednika odwrotnego na porcie 8080 w ramach tematu LAB: Konfiguracja Nginx Reverse Proxy na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi Nginx.
LAB: Konfiguracja Nginx Reverse Proxy
42/50
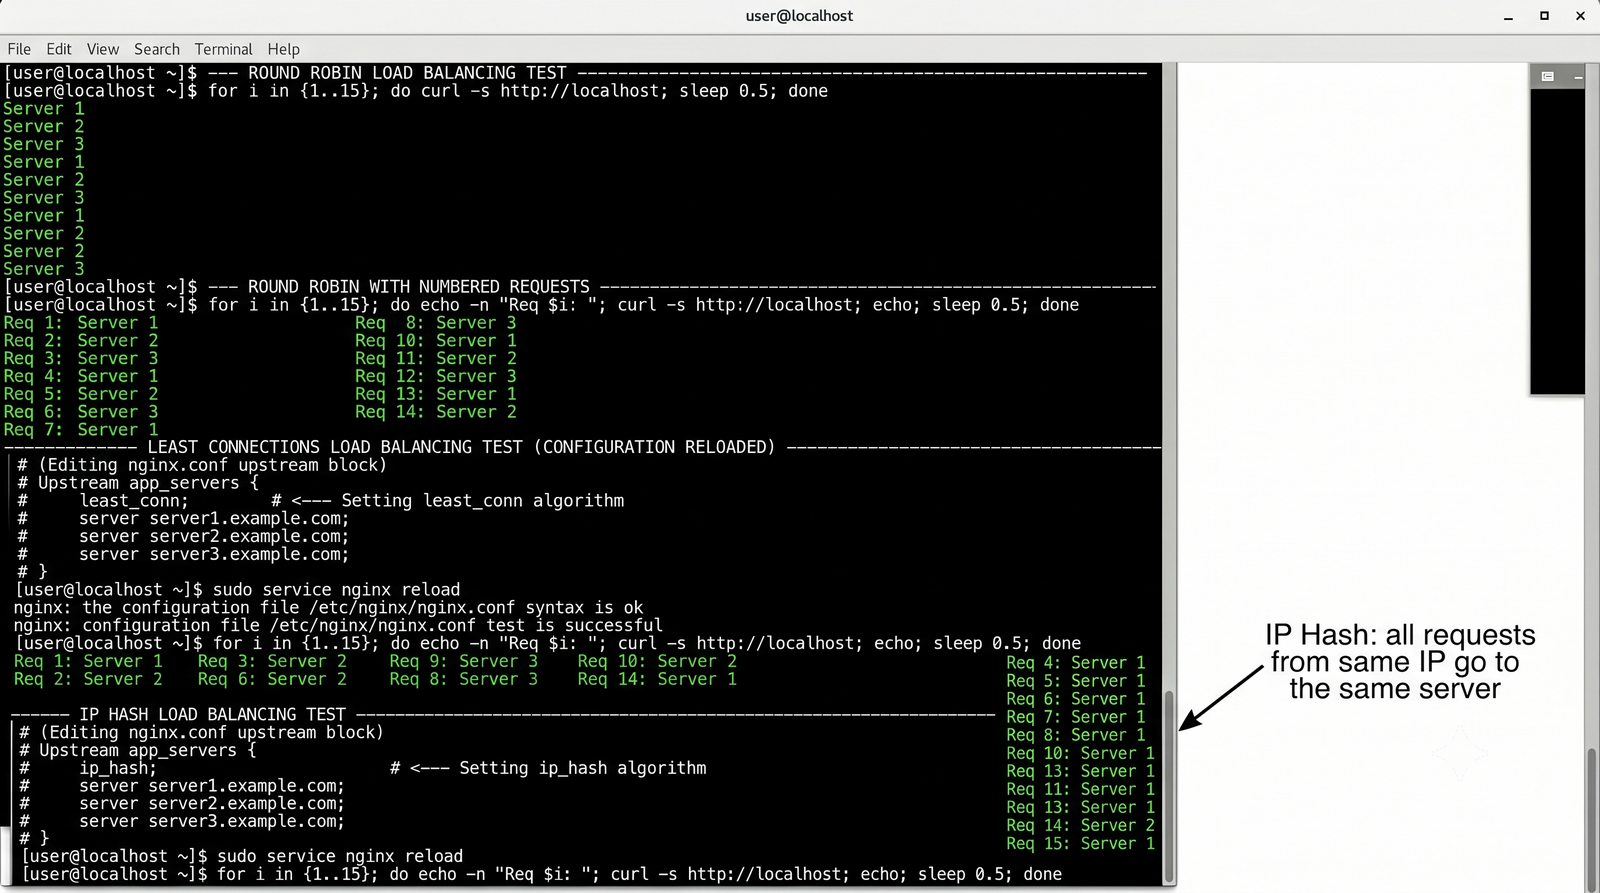
LAB: Test obciążeniowy Round Robin
Cel slajdu: Slajd omawia zagadnienie „LAB: Test obciążeniowy Round Robin” w kontekście: Empiryczna weryfikacja cyklicznej dystrybucji żądań.

Empiryczna weryfikacja cyklicznej dystrybucji żądań

Badanie rozkładu statystycznego za pomocą pętli powłoki Bash i narzędzia curl

  • Test sekwencyjny w pętli Bash: wykonanie serii 15 kolejnych żądań HTTP do proxy:
    for i in {1..15}; do echo -n "Żądanie $i: "; curl -s http://localhost:8080; sleep 0.2; done
  • Oczekiwany rezultat (idealna rotacja karuzelowa):
    Żądanie 1: Odpowiedź z węzła backendu: SERWER 1 (Port 8081)
    Żądanie 2: Odpowiedź z węzła backendu: SERWER 2 (Port 8082)
    Żądanie 3: Odpowiedź z węzła backendu: SERWER 3 (Port 8083)
    Żądanie 4: Odpowiedź z węzła backendu: SERWER 1 (Port 8081)...
  • Agregacja statystyczna za pomocą potoków Uniksa:
    for i in {1..300}; do curl -s http://localhost:8080; done | sort | uniq -c
    Wynik: dokładnie po 100 żądań przypisanych do każdego z trzech serwerów zaplecza.
  • Eksperyment z algorytmem Least Connections: dopisanie dyrektywy least_conn; w bloku upstream, przeładowanie Nginx i ponowna weryfikacja.
LAB: Test obciążeniowy Round Robin: Slajd przedstawia zagadnienie Empiryczna weryfikacja cyklicznej dystrybucji żądań w ramach tematu LAB: Test obciążeniowy Round Robin na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a środowisko testowe stanowią proste serwery Python http.server.
LAB: Test obciążeniowy Round Robin
43/50
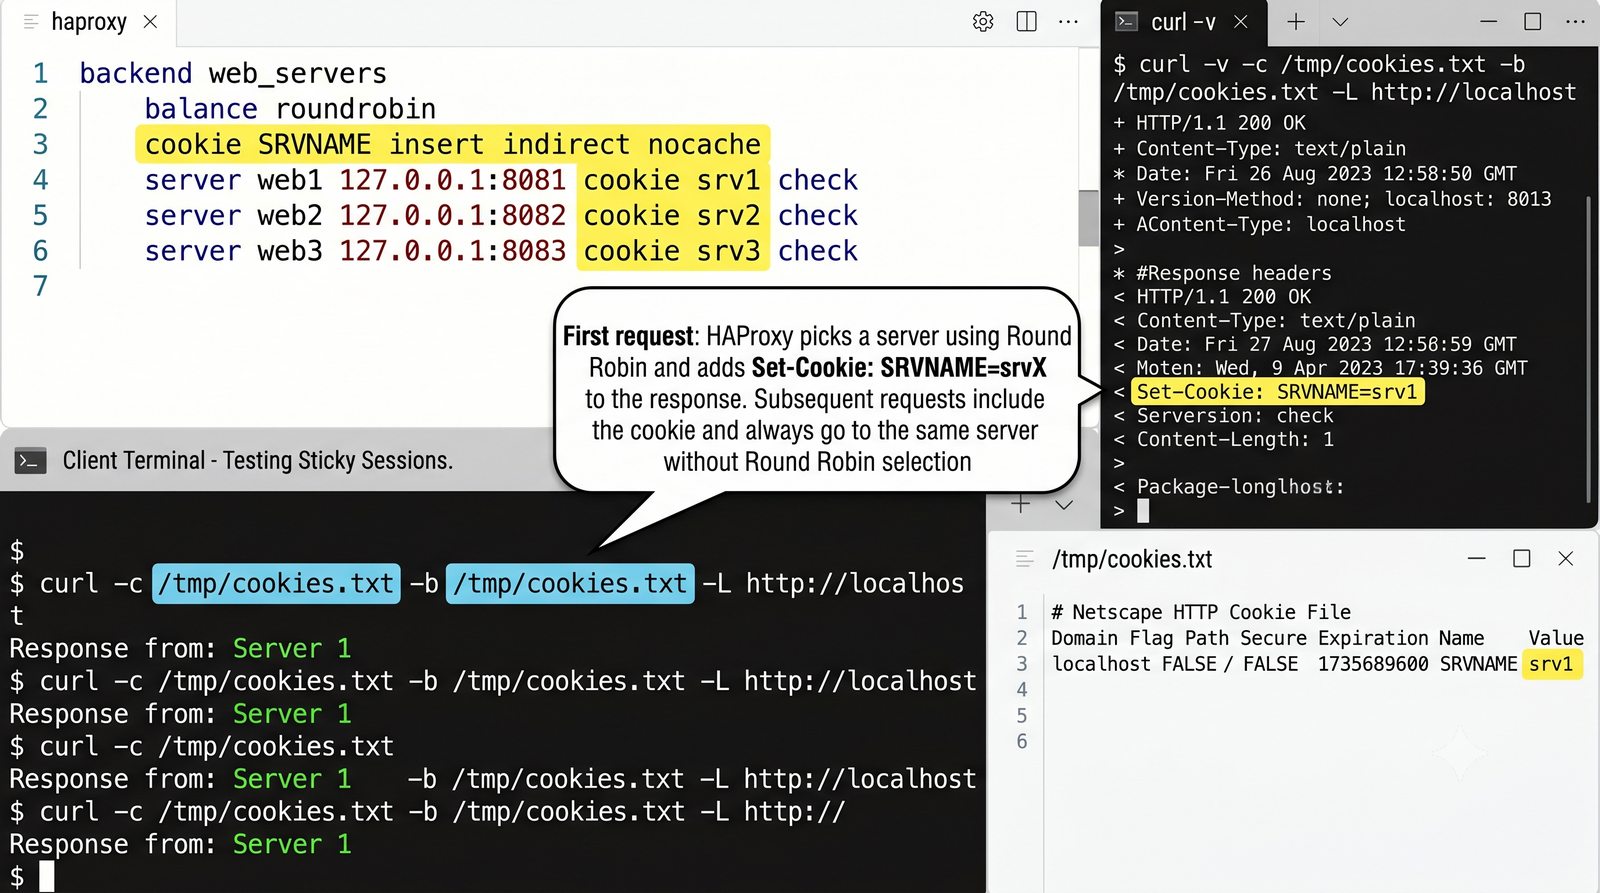
LAB: Test z ciasteczkiem sesyjnym i sticky sessions
Cel slajdu: Slajd omawia zagadnienie „LAB: Test z ciasteczkiem sesyjnym i sticky sessions” w kontekście: Implementacja i weryfikacja lepkości sesji z użyciem HAProxy.

Implementacja i weryfikacja lepkości sesji z użyciem HAProxy

Wstrzykiwanie ciasteczka routingowego i testowanie za pomocą jaru ciasteczek curl

  • Konfiguracja sekcji backend w HAProxy (/etc/haproxy/haproxy.cfg):
    backend be_sticky_cluster
        mode http
        balance roundrobin
        cookie SRVNAME insert indirect nocache
        server srv1 127.0.0.1:8081 check cookie srv1
        server srv2 127.0.0.1:8082 check cookie srv2
        server srv3 127.0.0.1:8083 check cookie srv3
  • Wykonanie pierwszego żądania z zapisem ciasteczek do pliku:
    curl -i -c /tmp/cookies.txt http://localhost:8080
    W nagłówkach odpowiedzi odnajdziemy: Set-Cookie: SRVNAME=srv1; path=/.
  • Wykonanie serii kolejnych żądań z dołączeniem pliku ciasteczek:
    for i in {1..10}; do curl -s -b /tmp/cookies.txt http://localhost:8080; sleep 0.2; done
  • Obserwowany rezultat: 100% żądań trafia niezmiennie do serwera srv1; rotacja karuzelowa została wstrzymana dla tego klienta na rzecz koligacji sesyjnej.
LAB: Test z ciasteczkiem sesyjnym i sticky sessions: Slajd przedstawia zagadnienie Implementacja i weryfikacja lepkości sesji z użyciem HAProxy w ramach tematu LAB: Test z ciasteczkiem sesyjnym i sticky sessions na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
LAB: Test z ciasteczkiem sesyjnym i sticky sessions
44/50
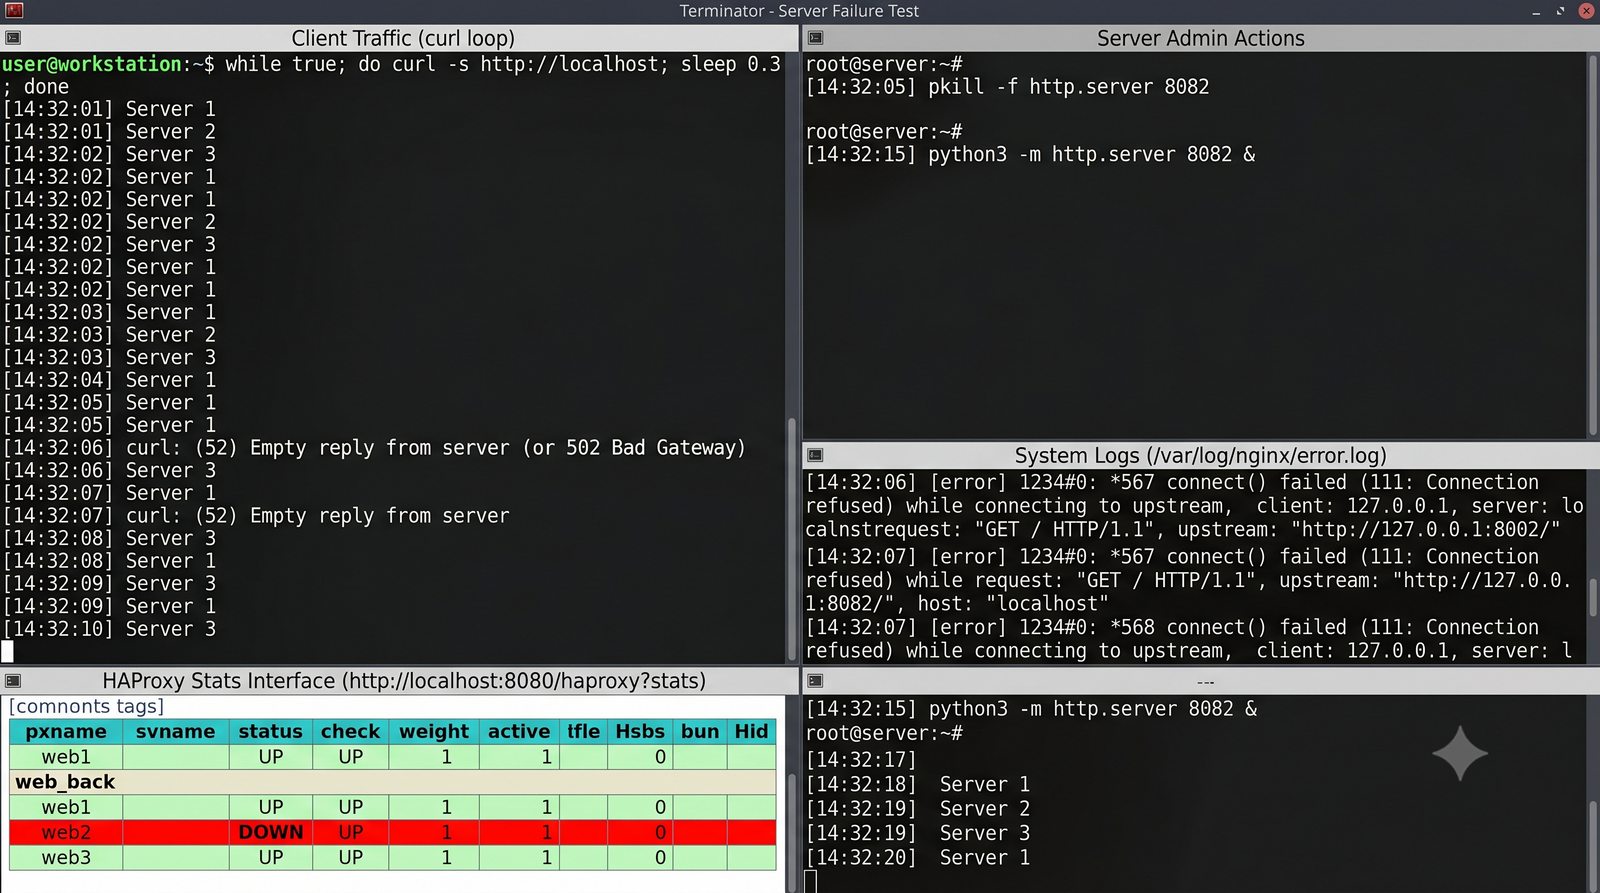
LAB: Test z symulacją awarii serwera
Cel slajdu: Slajd omawia zagadnienie „LAB: Test z symulacją awarii serwera” w kontekście: Analiza zachowania klastra w warunkach nagłego wyłączenia węzła.

Analiza zachowania klastra w warunkach nagłego wyłączenia węzła

Weryfikacja mechanizmów automatycznego przełączania awaryjnego (Failover) i self-healingu

  • Uruchomienie ciągłego monitoringu ruchu w pierwszym oknie terminala:
    while true; do curl -s --connect-timeout 1 http://localhost:8080; sleep 0.5; done
  • Zasymulowanie nagłej awarii sprzętowej serwera na porcie 8082 w drugim oknie:
    kill $(lsof -ti:8082) || true (bezpieczniej: pkill -f "http.server 8082")
  • Obserwacja reakcji węzła pośredniczącego:
    • Dzięki dyrektywie proxy_next_upstream error timeout http_502 w Nginx, klient nie otrzymuje żadnego błędu – żądanie, które trafiło na martwy port 8082, jest błyskawicznie retransmitowane do węzła 8081 lub 8083.
    • W HAProxy moduł option httpchk po 3 próbach (fall 3) oznacza serwer jako DOWN.
    • Ruch jest w 100% obsługiwany wyłącznie przez pozostałe dwa sprawne serwery.
  • Przywrócenie serwera do pracy (Self-Healing):
    python3 -m http.server 8082 --directory /tmp/backend_srv2 > /dev/null 2>&1 &
    Po 2 udanych próbach (rise 2) serwer automatycznie powraca do pełnej rotacji w klastrze.
LAB: Test z symulacją awarii serwera: Slajd przedstawia zagadnienie Analiza zachowania klastra w warunkach nagłego wyłączenia węzła w ramach tematu LAB: Test z symulacją awarii serwera na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a środowisko testowe stanowią proste serwery Python http.server.
LAB: Test z symulacją awarii serwera
45/50
Sesja troubleshooting: Zagubione adresy IP klienta
Cel slajdu: Slajd omawia zagadnienie „Sesja troubleshooting: Zagubione adresy IP klienta” w kontekście: Anatomia utraty tożsamości klienta za pośrednikiem L7.

Anatomia utraty tożsamości klienta za pośrednikiem L7

Dlaczego serwery zaplecza logują adres IP pośrednika zamiast rzeczywistego klienta?

  • Przyczyna sieciowa problemu:
    • Pośrednik L7 całkowicie kończy sesję transportową TCP klienta i nawiązuje zupełnie nowe, niezależne połączenie TCP z serwerem zaplecza.
    • W nagłówku pakietu IP odbieranego przez backend polem Source IP jest wewnętrzny adres IP serwera Reverse Proxy (np. 10.0.0.1 lub 127.0.0.1), a nie publiczny adres IP stacji roboczej klienta.
  • Katastrofalne skutki biznesowe i bezpieczeństwa:
    • Bezużyteczność logów audytowych: wszystkie zdarzenia w dziennikach backendu pochodzą z jednego adresu IP (adresu proxy).
    • Paraliż mechanizmów obronnych: zablokowanie adresu IP atakującego w zaporze backendu (Fail2ban, iptables) odcina cały ruch do aplikacji, paraliżując dostęp dla wszystkich legalnych użytkowników.
    • Błędna geolokalizacja i audyt: niemożność weryfikacji kraju pochodzenia transakcji bankowych oraz utrudniony audyt i wykrywanie nadużyć (wymogi sektorowe KNF i DORA, zasady PCI-DSS; logowanie adresów IP projektuj zgodnie z RODO).
Sesja troubleshooting: Zagubione adresy IP klienta: Slajd przedstawia zagadnienie Anatomia utraty tożsamości klienta za pośrednikiem L7 w ramach tematu Sesja troubleshooting: Zagubione adresy IP klienta na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
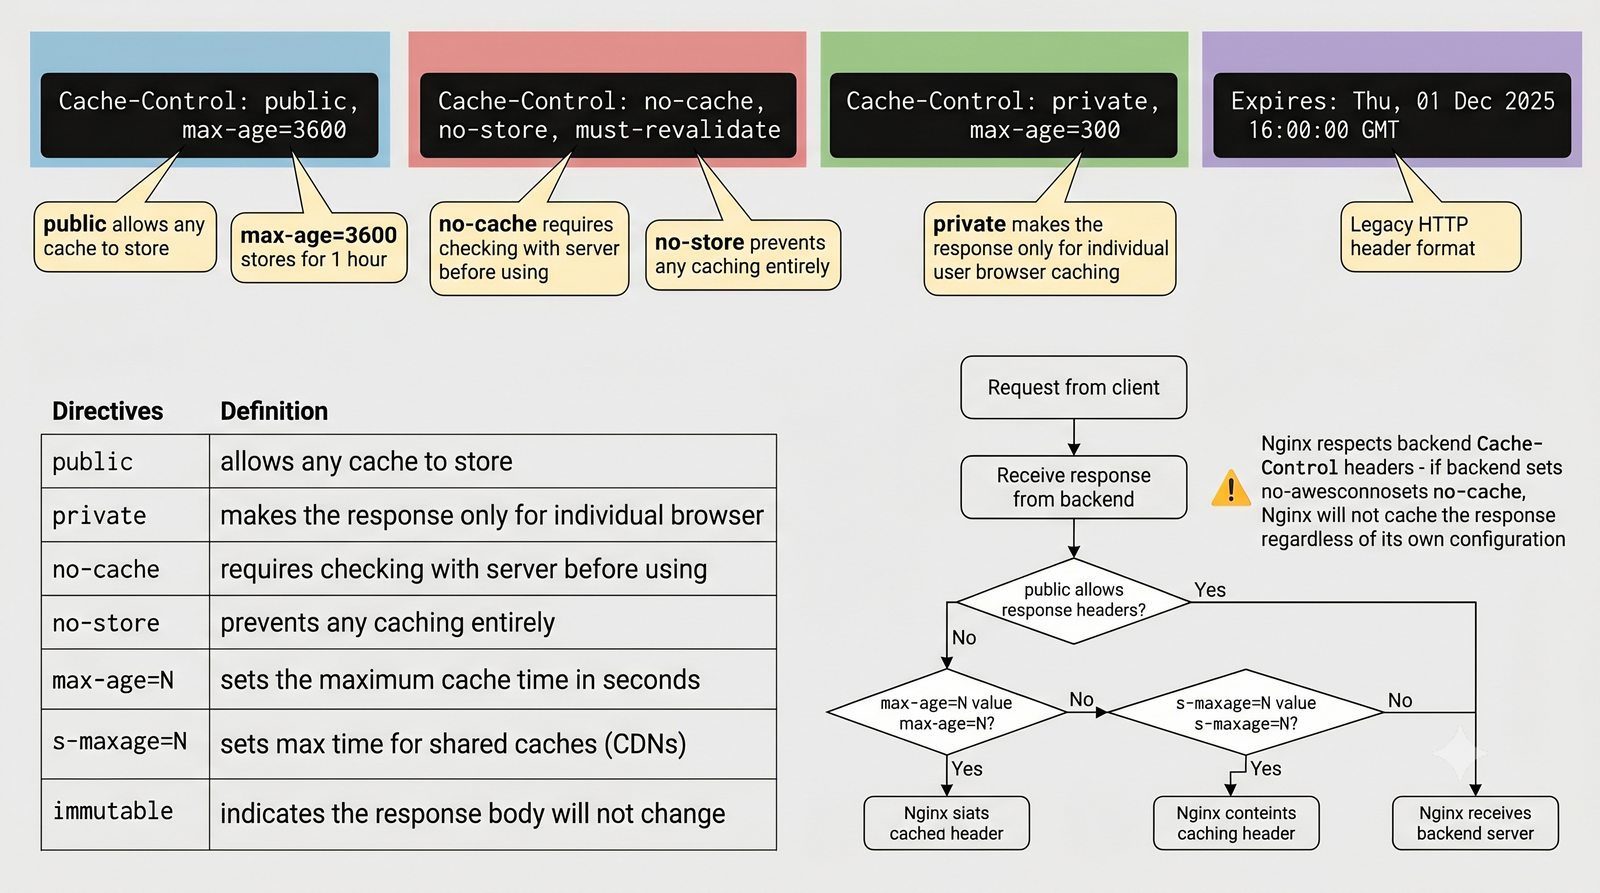
Sesja troubleshooting: Zagubione adresy IP klienta
46/50
Troubleshooting: X-Forwarded-For w Nginx i RFC 7239
Cel slajdu: Slajd omawia zagadnienie „Troubleshooting: X-Forwarded-For w Nginx i RFC 7239” w kontekście: Przekazywanie tożsamości klienta w Nginx oraz moduł ngx_http_realip_module.

Przekazywanie tożsamości klienta w Nginx oraz moduł ngx_http_realip_module

Standardy X-Forwarded-For, Forwarded (RFC 7239) i odzyskiwanie IP na zapleczu

  • Konfiguracja po stronie Reverse Proxy (Nginx):
    proxy_set_header X-Real-IP         $remote_addr;
    proxy_set_header X-Forwarded-For   $proxy_add_x_forwarded_for;
    proxy_set_header X-Forwarded-Proto $scheme;
    proxy_set_header Forwarded         "for=$remote_addr;proto=$scheme;host=$host";
    Zmienna $proxy_add_x_forwarded_for dopisuje adres klienta do istniejącej listy po przecinku.
  • Konfiguracja po stronie serwera zaplecza (Nginx backend):
    • Wykorzystanie wbudowanego modułu ngx_http_realip_module:
      set_real_ip_from  10.0.0.1;           # Adres zaufanego serwera Reverse Proxy
      set_real_ip_from  192.168.10.0/24;    # Cała podsieć zaufanych balancerów
      real_ip_header    X-Forwarded-For;    # Wskazanie nagłówka źródłowego
      real_ip_recursive on;                 # Przeszukiwanie od prawej do lewej
    • Efekt: zmienna $remote_addr na backendzie odzyskuje prawdziwy publiczny IP klienta.
  • Krytyczne ostrzeżenie bezpieczeństwa (IP Spoofing): nagłówek X-Forwarded-For może być sfałszowany przez klienta; backend może ufać temu nagłówkowi wyłącznie wtedy, gdy pakiet przyszedł z adresu zdefiniowanego w set_real_ip_from.
Troubleshooting: X-Forwarded-For w Nginx i RFC 7239: Slajd przedstawia zagadnienie Przekazywanie tożsamości klienta w Nginx oraz moduł ngx_http_realip_module w ramach tematu Troubleshooting: X-Forwarded-For w Nginx i RFC 7239 na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi Nginx.
Troubleshooting: X-Forwarded-For w Nginx
47/50
Troubleshooting: X-Forwarded-For w HAProxy i PROXY Protocol
Cel slajdu: Slajd omawia zagadnienie „Troubleshooting: X-Forwarded-For w HAProxy i PROXY Protocol” w kontekście: Mechanizmy translacji tożsamości klienta w HAProxy oraz standard PROXY v1/v2.

Mechanizmy translacji tożsamości klienta w HAProxy oraz standard PROXY v1/v2

Dyrektywa option forwardfor oraz alternatywa warstwy transportowej PROXY Protocol

  • Konfiguracja nagłówków w HAProxy (warstwa L7):
    • Dyrektywa option forwardfor: automatycznie dodaje nagłówek X-Forwarded-For z adresem IP klienta.
    • Klauzula wyłączenia: option forwardfor except 127.0.0.0/8 zapobiega dodawaniu nagłówka dla połączeń lokalnych.
    • Generowanie standardu RFC 7239:
      http-request set-header Forwarded "for=%[src];proto=%[ssl_fc,select(1,https,http)];host=%[req.hdr(Host)]"
  • Standard PROXY Protocol (warstwa L4):
    • Protokół opracowany przez Willy'ego Tarreau (twórcę HAProxy) do przekazywania tożsamości klienta bez modyfikowania protokołu aplikacyjnego HTTP.
    • Działa w trybie mode tcp; proxy wstrzykuje krótki, standaryzowany nagłówek (tekstowy v1 lub binarny v2) bezpośrednio po nawiązaniu sesji TCP, przed pierwszym bajtem danych klienta.
    • Wspierany natywnie przez Nginx (listen 80 proxy_protocol;), Apache, Postfix, AWS ALB/NLB.
Troubleshooting: X-Forwarded-For w HAProxy i PROXY Protocol: Slajd przedstawia zagadnienie Mechanizmy translacji tożsamości klienta w HAProxy oraz standard PROXY v1/v2 w ramach tematu Troubleshooting: X-Forwarded-For w HAProxy i PROXY Protocol na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a implementację stanowi HAProxy.
Troubleshooting: X-Forwarded-For w HAProxy
48/50
Troubleshooting: Diagnostyka martwych serwerów backendu
Cel slajdu: Slajd omawia zagadnienie „Troubleshooting: Diagnostyka martwych serwerów backendu” w kontekście: Metodyka rozwiązywania problemów z błędami HTTP 502 Bad Gateway i 504 Gateway Timeout.

Metodyka rozwiązywania problemów z błędami HTTP 502 Bad Gateway i 504 Gateway Timeout

Systematyczna izolacja usterek na styku Reverse Proxy ↔ Serwer Aplikacji

  • Błąd HTTP 502 Bad Gateway (Niepoprawna brama):
    • Przyczyna: serwer zaplecza odrzucił połączenie (pakiet TCP RST), proces aplikacji nie działa (crash, OOM Killer), gniazdo nie nasłuchuje na wskazanym porcie lub zapora ogniowa (iptables/UFW) blokuje ruch.
    • Weryfikacja: sprawdzenie logów błędów Nginx (/var/log/nginx/error.log) – komunikat connect() failed (111: Connection refused).
  • Błąd HTTP 504 Gateway Timeout (Przekroczenie limitu czasu bramy):
    • Przyczyna: proxy nawiązało połączenie TCP, lecz serwer zaplecza nie zwrócił odpowiedzi w zadanym czasie (zakleszczenie w bazie danych SQL, wyczerpanie wątków PHP-FPM, ciężkie obliczenia CPU).
    • Komunikat w logach: upstream timed out (110: Connection timed out) while reading response header from upstream.
  • Inżynierski algorytm diagnostyczny:
    1. Stan procesu:        systemctl status aplikacja / ps aux | grep gunicorn
    2. Nasłuch gniazda:      ss -tlpn | grep -E ':808[123]'
    3. Test lokalny z proxy: curl -i http://127.0.0.1:8081/health
    4. Regulacja timeoutów:  proxy_connect_timeout 5s; proxy_read_timeout 60s;
Troubleshooting: Diagnostyka martwych serwerów backendu: Slajd przedstawia zagadnienie Metodyka rozwiązywania problemów z błędami HTTP 502 Bad Gateway i 504 Gateway Timeout w ramach tematu Troubleshooting: Diagnostyka martwych serwerów backendu na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
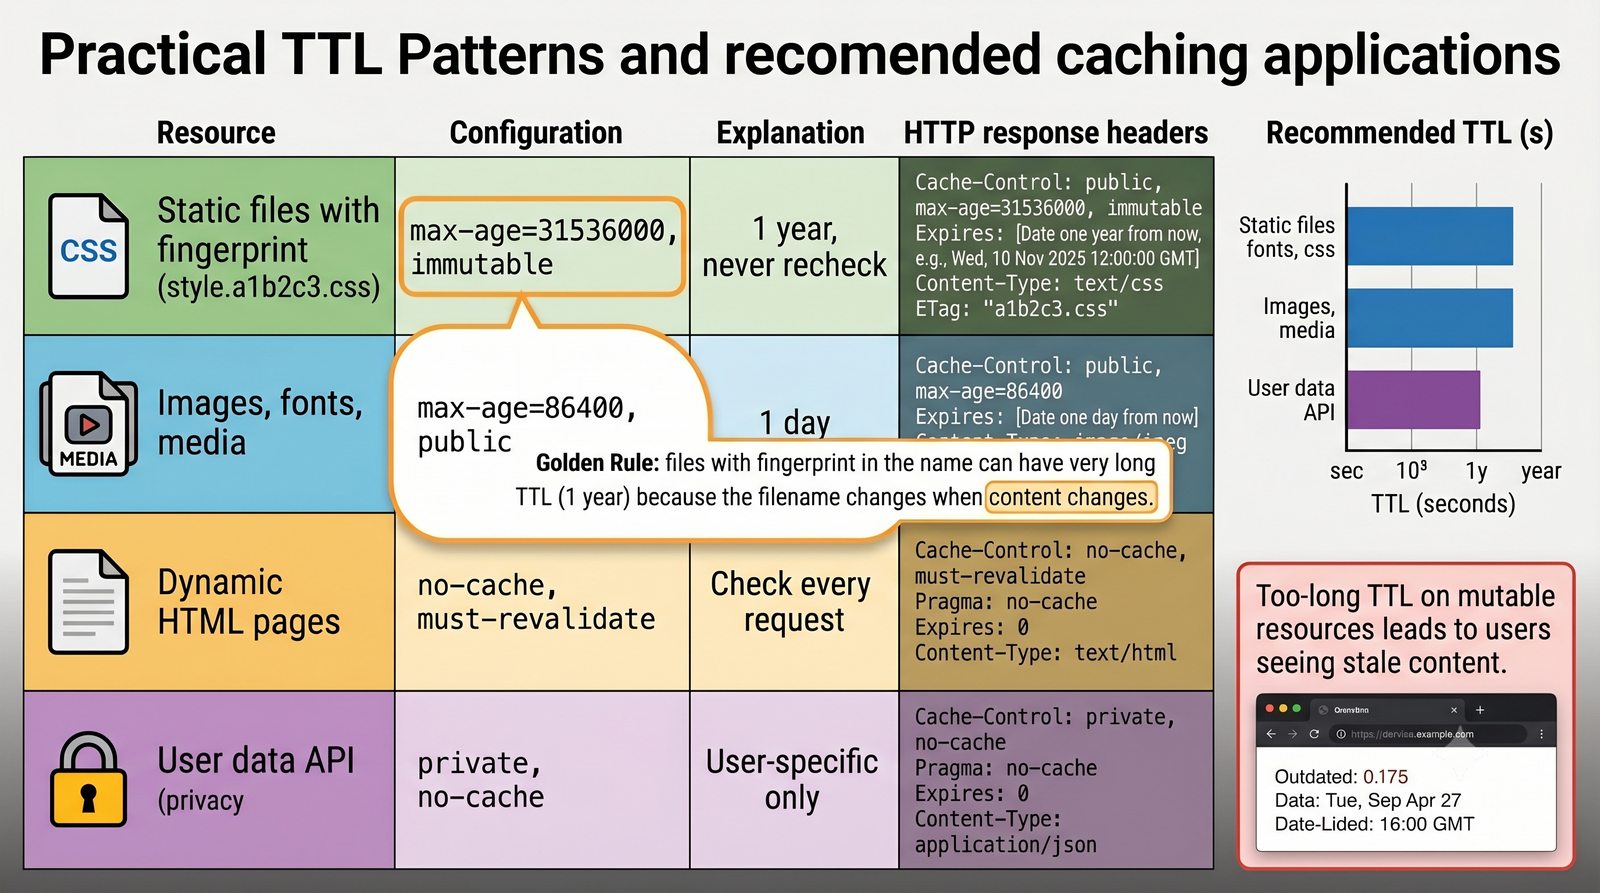
Troubleshooting: Diagnostyka martwych serwerów backendu
49/50
Troubleshooting: Zaawansowana diagnostyka proxy
Cel slajdu: Slajd omawia zagadnienie „Troubleshooting: Zaawansowana diagnostyka proxy” w kontekście: Formatowanie logów telemetrycznych, analiza pakietów i metryki jądra.

Formatowanie logów telemetrycznych, analiza pakietów i metryki jądra

Kompleksowe instrumentarium diagnostyczne administratora wysokowydajnych węzłów pośredniczących

  • Rozszerzony format logów dostępu w Nginx (kontekst http):
    log_format upstream_logging '$remote_addr - [$time_local] "$request" '
                                '$status $body_bytes_sent "$http_referer" '
                                'up_addr="$upstream_addr" up_status="$upstream_status" '
                                'up_response_time=$upstream_response_time req_time=$request_time';
    access_log /var/log/nginx/access.log upstream_logging;
  • Inspekcja nagłówków na żywo: curl -v -H "X-Debug: 1" http://localhost:8080/
  • Przechwytywanie i analiza surowego ruchu sieciowego na gniazdach backendu:
    sudo tcpdump -nn -i lo port 8081 -A -s 0 -c 20
    Umożliwia bezpośredni podgląd przesyłanych nagłówków HTTP oraz weryfikację flag TCP (SYN, RST, FIN).
  • Tuning parametrów jądra Linux pod kątem stanów TIME_WAIT i deskryptorów:
    • Zwiększenie limitu otwartych plików: worker_rlimit_nofile 65535; w Nginx oraz ulimit -n 65535.
    • Recykling gniazd TCP w jądrze: sudo sysctl -w net.ipv4.tcp_tw_reuse=1.
Troubleshooting: Zaawansowana diagnostyka proxy: Slajd przedstawia zagadnienie Formatowanie logów telemetrycznych, analiza pakietów i metryki jądra w ramach tematu Troubleshooting: Zaawansowana diagnostyka proxy na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
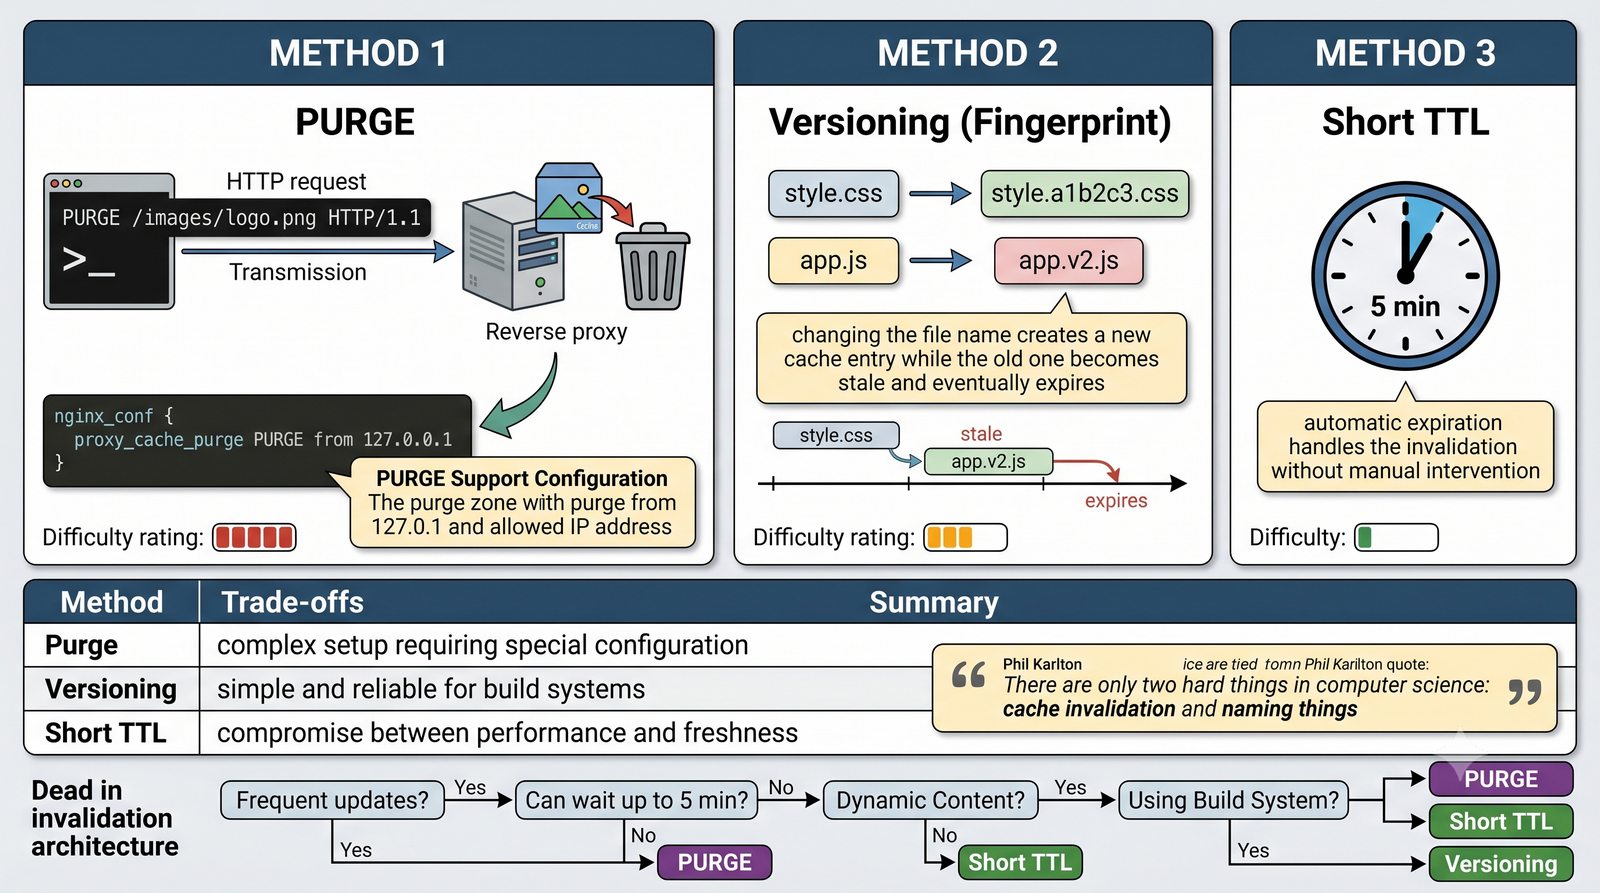
Troubleshooting: Zaawansowana diagnostyka proxy
50/50
Finał: Cheat Sheet administratora proxy
Cel slajdu: Slajd omawia zagadnienie „Finał: Cheat Sheet administratora proxy” w kontekście: Usystematyzowane kompendium dyrektyw, poleceń i wzorców projektowych.

Usystematyzowane kompendium dyrektyw, poleceń i wzorców projektowych

Najważniejsze polecenia operacyjne i reguły konfiguracyjne do codziennej praktyki inżynierskiej

  • Polecenia zarządzania usługami w systemie Linux:
    • Nginx: test składni: nginx -t | przeładowanie bez przestoju: sudo systemctl reload nginx | podgląd logów: sudo tail -f /var/log/nginx/error.log
    • HAProxy: test składni: haproxy -c -f /etc/haproxy/haproxy.cfg | przeładowanie: sudo systemctl reload haproxy | panel statystyk: port 8404
  • Szybka ściągawka kluczowych dyrektyw:
    • Nginx Upstream: least_conn;, ip_hash;, weight=N, max_fails=N fail_timeout=Ns, backup, keepalive 32;
    • Nginx Location: proxy_pass http://backend;, proxy_next_upstream error timeout http_502;
    • Nagłówki tożsamości klienta: proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;, RFC 7239: proxy_set_header Forwarded "for=$remote_addr;proto=$scheme;host=$host";
    • WebSocket: proxy_http_version 1.1; proxy_set_header Upgrade $http_upgrade; proxy_set_header Connection "upgrade";
    • HAProxy Backend: balance roundrobin/leastconn, cookie SRVNAME insert indirect nocache, option httpchk GET /health
  • Złota zasada architektoniczna: Zawsze testuj konfigurację przed wdrożeniem, izoluj serwery zaplecza w prywatnych podsieciach i nigdy nie ufaj nagłówkom tożsamości klienta pochodzącym z niezaufanych węzłów sieciowych!
Finał: Cheat Sheet administratora proxy: Slajd przedstawia zagadnienie Usystematyzowane kompendium dyrektyw, poleceń i wzorców projektowych w ramach tematu Finał: Cheat Sheet administratora proxy na przykładach konfiguracji i diagnostyki w systemie Linux. Zasady semantyki i buforowania odpowiedzi opisano w RFC 9110 i RFC 9111, a popularną implementację pośrednika stanowi Squid.
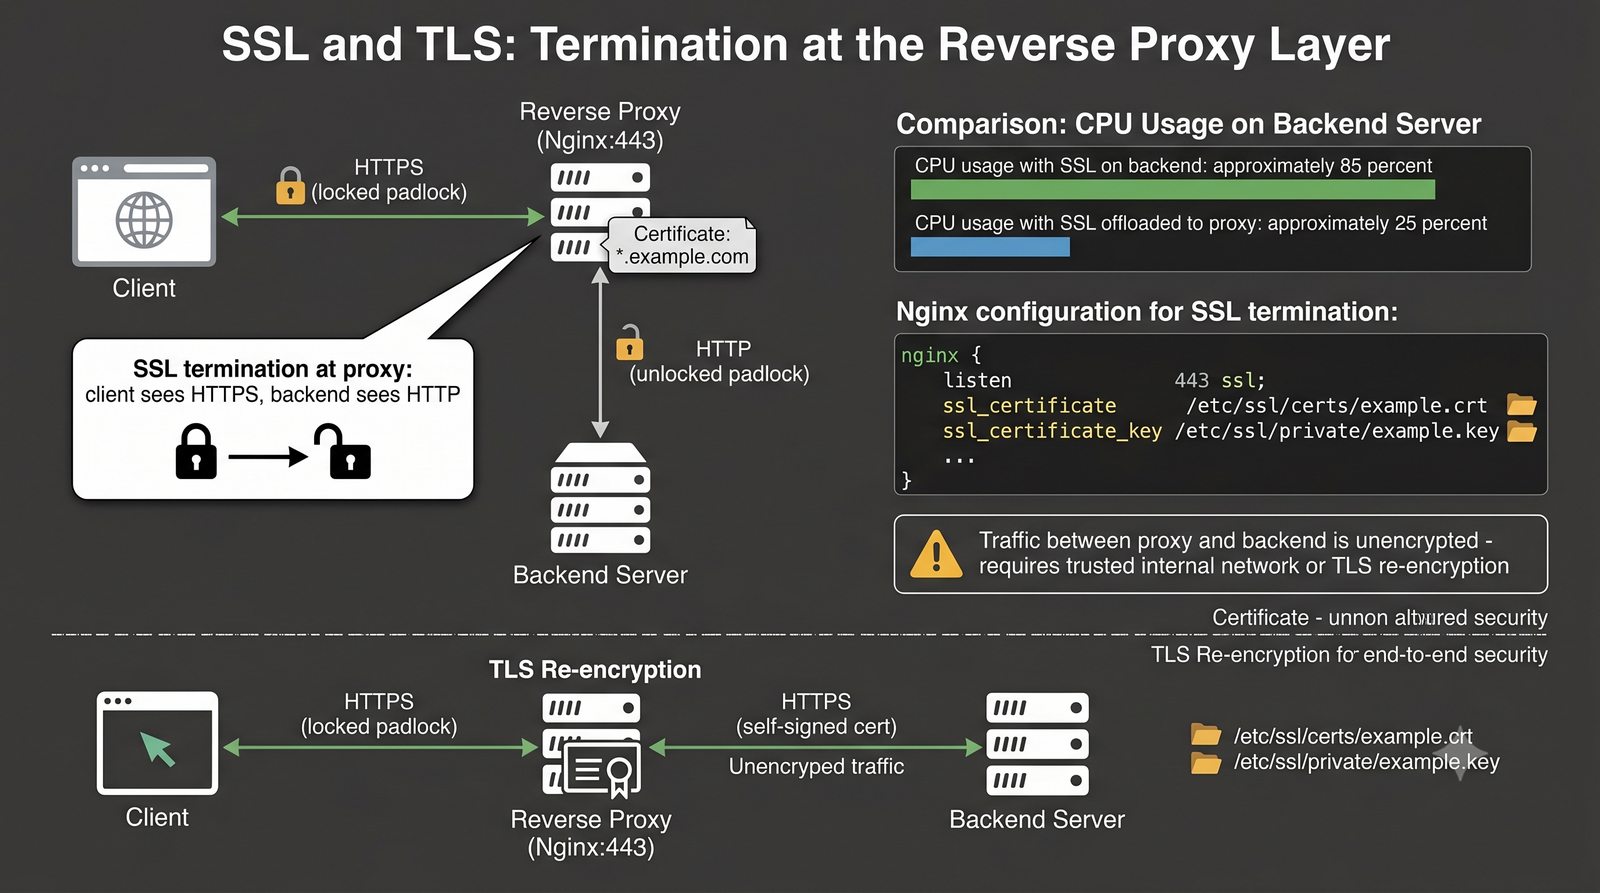
Finał: Cheat Sheet administratora proxy